“오픈소스로 풀면 규제에서 자유롭다”는 인식이 있습니다. 코드도 가중치도 공개했으니 책임도 덜하지 않겠냐는 거죠. EU의 인공지능법(EU AI Act)에서는 그 인식이 절반만 맞습니다.
오픈소스에 면제가 있긴 합니다. 그런데 면제되지 않는 의무가 따로 있고, 조건을 하나라도 못 채우면 면제 자체를 못 받으며, 모델이 일정 규모를 넘으면 그 면제마저 사라집니다.
 오픈소스 모델과 규제의 관계를 표현한 3D 에디터리얼 콘셉트 씬 — 출처: 개념 컷 · agy 자가 생성
EU가 범용 AI를 규제 대상에 넣었다
EU AI Act는 챗봇·이미지 생성처럼 여러 용도로 쓰이는 범용 AI(GPAI, General-Purpose AI) 모델 제공자에게 직접 의무를 지웁니다. 완성된 서비스가 아니라 모델 자체가 규제 대상이라는 점이 이 법의 특징이에요.
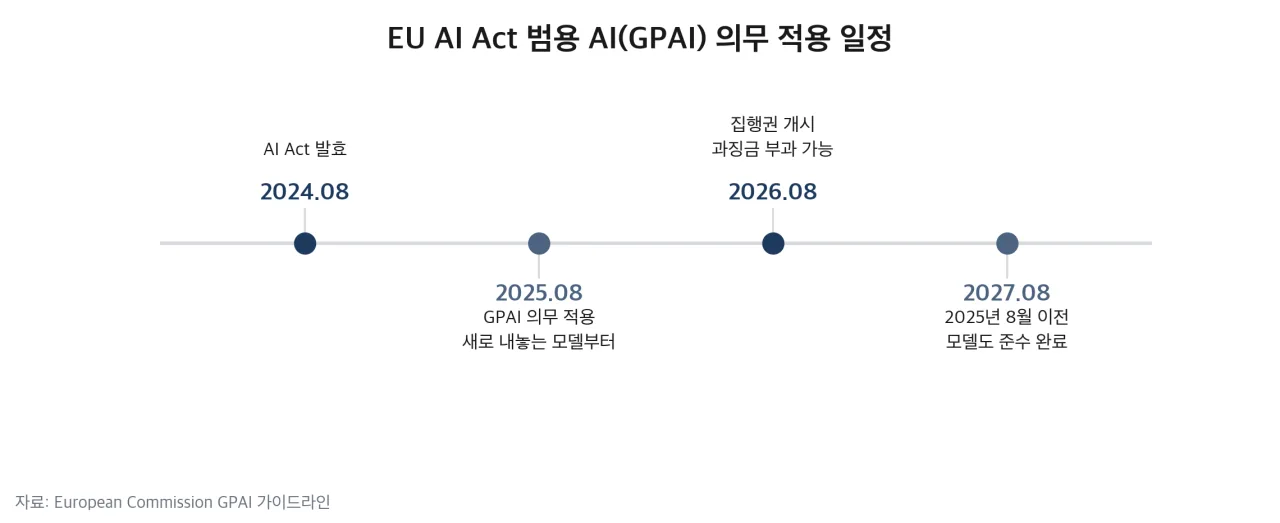 EU AI Act 범용 AI(GPAI) 의무 적용 일정 — 출처: European Commission GPAI 가이드라인 기반 자가 렌더
적용은 단계로 나뉩니다. 2025년 8월 2일부터 새로 내놓는 모델에 의무가 붙었고, 그때부터 1년은 EU의 집행 기구(AI Office)가 협의 위주로 운영하는 유예 구간이었습니다. 2026년 8월 2일에 그 구간이 끝나 과징금을 실제로 매길 수 있게 됐고, 2025년 8월 이전에 이미 시장에 나와 있던 모델은 2027년 8월 2일까지 준수를 마쳐야 합니다.
GPAI 의무는 상용 폐쇄 모델만이 아니라 가중치 공개(open weight) 모델에도 똑같이 적용됩니다. 다만 오픈소스에는 별도의 면제 조항이 붙어 있어요.
면제받는 조건은 네 가지다
면제의 근거는 AI Act 제53조 2항입니다. 조문이 요구하는 조건은 넷이고, 넷을 다 채워야 면제를 받습니다.
| 조건 | 무엇을 요구하나 |
|---|---|
| 라이선스 | 접근·사용·수정·배포를 모두 허용하는 무료 오픈소스 라이선스 |
| 가중치 | 모델 파라미터(weights)를 공개 |
| 구조 | 모델 아키텍처 정보를 공개 |
| 사용법 | 모델 사용에 관한 정보를 공개 |
넷을 다 채우면 두 가지 의무가 빠집니다. 그리고 오픈소스여도 반드시 남는 의무가 따로 있어요.
| 면제되는 것 (네 조건 충족 시) | 그래도 남는 의무 |
|---|---|
| 상세 기술 문서(Annex XI) 구비 | 학습 데이터 요약 공개 |
| 하위 개발자에게 문서 제공 | 저작권 정책 수립·공개 |
즉 “오픈소스면 아무것도 안 해도 된다”가 아니라, 문서화 부담은 덜되 데이터 투명성과 저작권 책임은 그대로 진다가 정확합니다.
“오픈 웨이트”라고 다 오픈소스는 아니다
 가중치는 공개돼 있지만 라이선스에 제약이 걸린 상태를 표현한 3D 에디터리얼 콘셉트 씬 — 출처: 개념 컷 · agy 자가 생성
네 가지 면제 조건 중 라이선스 조건이 실무에서 가장 자주 걸리는 자리입니다. 가중치를 내려받을 수 있다는 것과 조문이 말하는 자유로운 오픈소스 라이선스는 다른 얘기예요. European Commission의 GPAI 가이드라인은 면제 대상을 수익화 조건이 붙지 않은 자유 오픈소스 라이선스로 못박았습니다.
가장 널리 쓰이는 오픈 웨이트 모델인 Meta의 Llama가 여기에 걸립니다. Llama Community License에는 일반적인 오픈소스 라이선스에 없는 제약이 있어요.
월간 활성 이용자 7억 명을 넘는 사업자는 별도 라이선스를 따로 받아야 합니다
Llama의 출력으로 경쟁 모델을 학습시키는 것을 금지합니다
Open Source Initiative(OSI)는 이런 제약을 이유로 Llama를 오픈소스로 인정하지 않습니다
사용 범위에 조건을 건 라이선스는 “접근·사용·수정·배포를 모두 허용”이라는 첫 조건을 못 채울 수 있습니다. 그러면 가중치·구조·사용법을 다 공개해도 면제 밖이고, 상세 기술 문서 의무까지 전부 지게 됩니다. 오픈 웨이트는 면제의 필요조건이지 충분조건이 아닙니다.
큰 모델이면 면제가 사라진다
학습에 10²⁵ FLOPs 이상의 연산을 쓴 모델은 고영향 능력을 가졌다고 보고 시스템적 위험(systemic risk) GPAI로 분류합니다. FLOPs는 학습에 들인 총 연산량이에요.
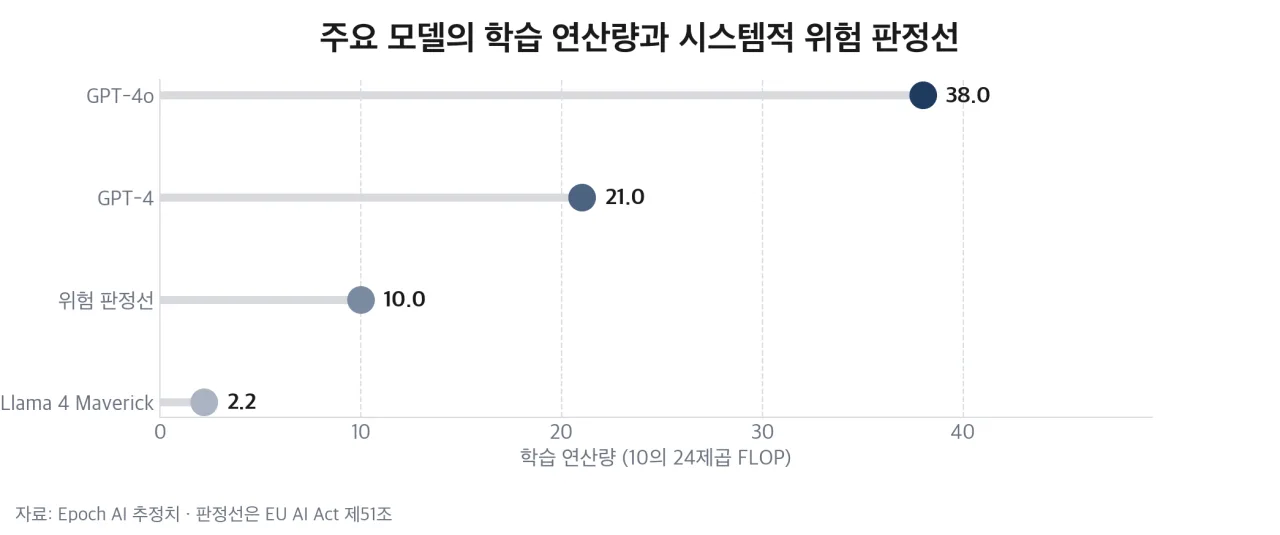 주요 모델의 학습 연산량과 시스템적 위험 판정선 — 출처: Epoch AI 추정치 기반 자가 렌더
이 선을 넘으면 위험 평가·완화, 심각한 사고 보고, 보안 강화 같은 추가 의무가 붙고, 조문은 오픈소스에 예외를 두지 않는다고 명시합니다. 앞 절의 면제가 여기엔 통하지 않아요.
의무는 분류된 뒤에만 생기는 게 아닙니다. 학습 연산량이 이 선에 도달하면 제공자가 지체 없이, 늦어도 2주 안에 European Commission에 스스로 알려야 합니다. 문턱을 넘었더라도 고영향 능력이 없다고 반박할 길은 열려 있고, 그 판단은 Commission이 합니다.
실제 위치는 모델마다 갈립니다. Epoch AI 집계로 이 선을 넘은 모델이 30개를 넘었지만, 오픈 웨이트 쪽에서 널리 쓰이는 Llama 4 Maverick은 2.2×10²⁴로 판정선 아래입니다. 규모로는 면제 대상이라는 뜻이고, 그래서 앞 절의 라이선스 조건이 더 중요해집니다.
학습 데이터 요약 — 양식이 이미 나왔다
오픈소스여도 남는 의무 중 학습 데이터 요약은 추상적인 선언이 아니라 정해진 서식입니다. European Commission이 2025년 7월 24일에 양식을 공표했고, 제공자는 여기에 맞춰 공개해야 합니다.
| 양식이 묻는 것 | 예 |
|---|---|
| 데이터 종류·규모 | 텍스트·이미지·음성, 크기 구간 |
| 언어·수집 기간 | 어떤 언어를 언제 모았나 |
| 주요 공개 데이터셋 | 식별자로 특정 |
| 크롤러 사양·목적 | 무엇을 어떻게 긁었나 |
| 상업 라이선스 데이터 | 사서 쓴 데이터가 있나 |
| TDM 옵트아웃 준수 | 수집 거부 의사를 지켰나 |
영업 비밀 보호를 위해 기술적 세부가 아닌 서술형 설명을 요구하지만, TDM 옵트아웃 준수 항목은 가볍지 않습니다. 저작권자가 텍스트·데이터 마이닝 거부 의사를 밝힌 자료를 어떻게 처리했는지 적어야 해서, 사실상 수집 방식을 공개하는 항목이에요. 요약은 6개월마다, 또는 중대한 변경이 있을 때 갱신해야 합니다.
실제로는 누가 지켰나
집행이 시작된 2026년 8월을 앞두고 대응이 갈렸습니다. 자율 준수 규약(Code of Practice) 서명과 학습 데이터 요약 제출, 두 곳 모두에서요.
| 구분 | 기업 |
|---|---|
| 규약 전체 서명 | Amazon · Google · Microsoft · OpenAI · Anthropic |
| 안전 챕터만 서명 | xAI |
| 서명 거부 | Meta |
Meta는 규약이 법의 범위를 넘어서고 법적 불확실성을 키운다는 이유로 서명하지 않았습니다. 오픈 웨이트 진영의 대표 주자가 규약 밖에 선 셈이에요.
학습 데이터 요약은 더 갈렸습니다. Google·Meta·Microsoft·OpenAI와 Hugging Face 등은 공식 양식의 칸을 그대로 채웠고, Anthropic·Mistral·xAI는 칸 대신 서술형 산문으로 대체했습니다. 다만 이들 모델 상당수가 2025년 8월 이전 출시라 2027년 유예 안에 있어서, 지금 시점의 형식 차이만으로 위반을 단정하기는 어렵습니다.
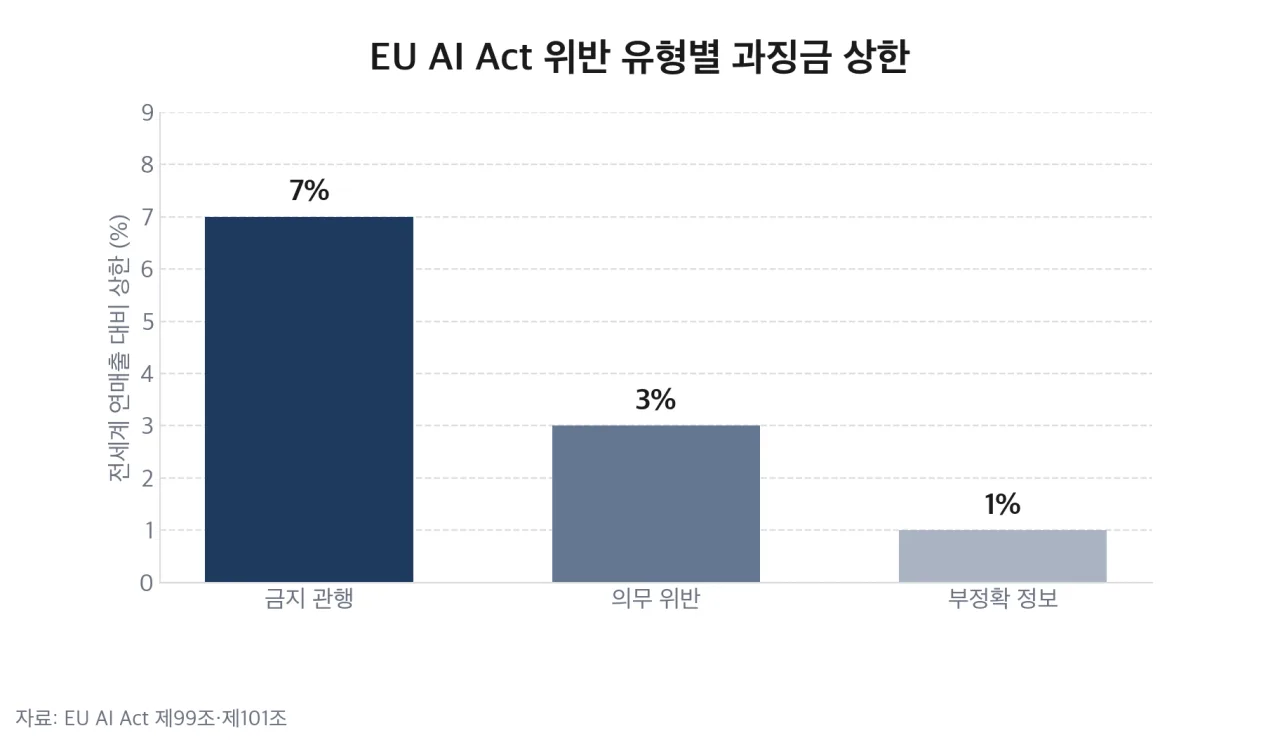 EU AI Act 위반 유형별 과징금 상한 — 출처: EU AI Act 제99조·제101조 기반 자가 렌더
제재 수위는 낮지 않습니다. GPAI 제공자가 의무를 어기면 전 세계 연매출의 3% 또는 240억 원(1,500만 유로) 중 큰 쪽까지 물릴 수 있어요(제101조). 금지된 AI 관행은 7%, 부정확한 정보 제공은 1%로 층이 나뉩니다.
다만 2026년 8월 초까지 실제로 부과된 과징금은 한 건도 없습니다. 양식을 채웠다고 내용이 충실한 것도 아니어서, Trinity College Dublin과 Mozilla Foundation이 초기 요약 5건을 평가한 결과 품질 기준을 통과한 것은 Hugging Face의 SmolLM 하나였고 Microsoft의 Phi 요약은 미달로 봤습니다. 제도는 시행됐지만 집행 실적과 문서 품질은 아직 초기 단계예요.
국내에는 무엇을 뜻하나
1탄에서 본 인공지능기본법은 고영향 AI를 중심으로 의무를 지웁니다. EU는 그와 별개로 범용 AI 자체와 연산 규모라는 기준을 하나 더 둔 셈이에요.
AI 와 법 (1) — 우리 서비스가 고영향 AI 인지 확인하는 순서
| 구분 | 국내 AI기본법 | EU AI Act |
|---|---|---|
| 중심 축 | 고영향 AI(용도) | 범용 AI + 연산 규모 |
| 오픈소스 | 별도 면제 조항 약함 | 조건부 면제(4개 조건) |
| 규모 기준 | 명시적 문턱 없음 | 10²⁵ FLOPs |
| 과징금 | 최대 3천만 원 | 연매출 3% 또는 240억 원 |
과징금 수위의 차이가 대응 순서를 정합니다. 국내 기업이 유럽에 서비스한다면 국내법 준수만으로는 부족하고, 학습 데이터 요약과 저작권 정책을 EU 양식에 맞춰 따로 준비해야 해요.
이미 움직인 곳들이 있습니다. 2026년 8월 2일부터 제50조 투명성 의무가 적용되면서 삼성전자·LG전자는 유럽향 AI 가전에 생성 콘텐츠 표기를 선제 반영했고, 기계 판독 워터마크는 기존 시스템에 한해 2026년 12월 2일까지 유예를 받았습니다. 국내 업계에서는 AI기본법을 이미 전면 시행 중이라 추가 부담이 크지 않다는 진단이 나오지만, 그 진단은 국내 서비스 기준입니다.
핵심은 모델을 어디서 만들었느냐가 아니라 EU 시장에 내놓느냐라서, 국내 스타트업이 가중치를 공개한 모델로 유럽 이용자를 받는 순간 같은 판단을 받습니다. 오픈소스라는 이유로 면제될 거라는 전제가 가장 위험합니다.
정리하면
EU AI Act에서 오픈소스는 조건부 부분 면제입니다. 셋으로 요약됩니다.
면제는 네 조건을 다 채웠을 때만 받고, 사용 제한이 붙은 라이선스는 여기서 걸린다
면제를 받아도 학습 데이터 요약과 저작권 정책은 남는다
학습 연산량이 10²⁵ FLOPs를 넘으면 면제 자체가 사라진다
“오픈소스 = 규제 무관”이 아니라 “오픈소스 = 조건부 경감”으로 읽는 게 맞습니다. 그리고 그 조건을 정하는 것은 가중치를 풀었느냐가 아니라 라이선스에 무엇을 적었느냐입니다.
참고 출처
- [EU Artificial Intelligence Act] 제53조 — GPAI 제공자 의무와 오픈소스 면제
- [EU Artificial Intelligence Act] 제101조 — GPAI 제공자 과징금
- [EU Artificial Intelligence Act] 제99조 — 위반 유형별 과징금 층위
- [European Commission] GPAI 제공자 의무 가이드라인 FAQ (수익화 조건·통보 의무·적용 일정)
- [European Commission] 학습 콘텐츠 공개 요약 양식 (2025-07-24)
- [Epoch AI] 10²⁵ FLOP 이상으로 학습된 모델 집계
- [Open Source Initiative] Llama 라이선스가 오픈소스 정의를 충족하지 않는 이유
- [아주경제] EU AI법 발효 — 삼성·LG 유럽향 AI 가전 투명성 표기 대응
- Llama 4 Maverick 2.2×10²⁴ FLOP 등 학습 연산량은 Epoch AI 추정치로, 제조사 공식 발표가 아니라 벤치마크·하드웨어 기반 역산입니다
- Llama 라이선스가 제53조 2항 면제 조건을 충족하는지는 European Commission의 개별 판단이 나온 사안이 아니라, 조문 문언과 가이드라인에 비추어 본 것입니다
- 환율은 1유로 ≈ 1,600원 기준 환산입니다