Anthropic이 9월 1일 Claude Fable 5.1과 Claude Mythos 5.1을 함께 공개했습니다. 두 모델은 가중치가 같고 걸어 둔 안전장치만 다릅니다.
같은 자료에 두 판의 점수가 나란히 실렸어요. Terminal-Bench 4.0에서 Fable 5.1이 55.8%, Mythos 5.1이 60.9%입니다. 같은 모델에서 안전장치만 해제했을 때 5.1%포인트가 오른다는 뜻이에요.
 Anthropic 로고 — 출처: Anthropic
무슨 일이 있었나
Anthropic은 2026년 9월 1일 claude-fable-5-1을 일반 공개하고, 안전장치를 낮춘 판인 Mythos 5.1은 검증을 통과한 조직에만 열었습니다. Claude.ai와 Claude Code, Claude API에 더해 Amazon Bedrock, Google Cloud, Microsoft Foundry로도 같이 나갔어요.
- 컨텍스트 윈도(context window, 한 번에 넣는 입력 길이) 100만 토큰, 최대 출력 12만 8,000토큰
- 적응형 사고(adaptive thinking)가 항상 켜진 상태로 동작
- 입력 1만 4,000원(10달러), 출력 7만 원(50달러)으로 기본 단가는 동결
- 캐시 읽기만 350원(0.25달러)으로 75% 인하
- 사이버·생물 안전장치의 오탐이 크게 줄고, 대신 반증류 조치가 추가됨
캐시 읽기 인하가 실제 청구서에 어떻게 작용하는지는 앞선 글이 다뤘고, 이번 공개에서 갈리는 축은 안전장치입니다.
같은 가중치, 다른 안전장치
Fable 5.1과 Mythos 5.1은 별개로 학습한 모델이 아닙니다. Anthropic은 두 판을 같은 모델이되 안전장치 수준이 다른 것이라고 설명했어요.
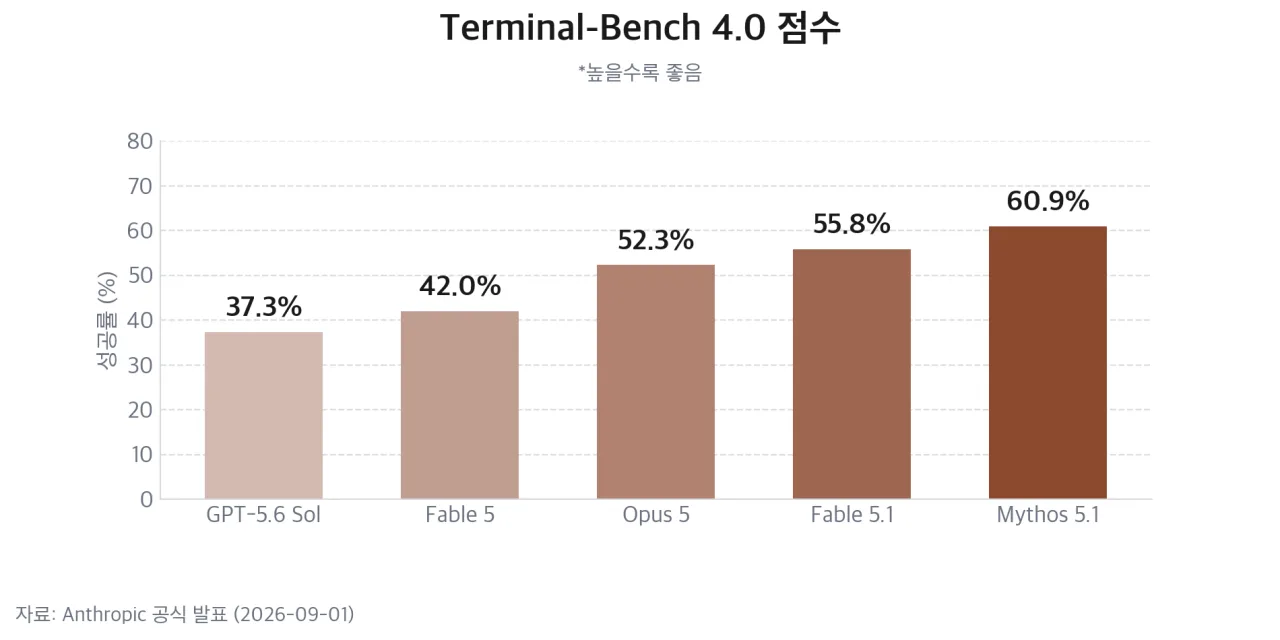 Terminal-Bench 4.0 모델별 점수 — 출처: Anthropic 공식 발표 수치 기반 자가 렌더
Terminal-Bench 4.0은 터미널에서 여러 단계를 스스로 밟아 과제를 끝내는지 보는 66개 과제 모음입니다. 최대 노력 설정에서 Fable 5.1이 55.8%, Mythos 5.1이 60.9%였어요.
Anthropic은 이 차이를 두고 이전의 덜 정밀했던 사이버 안전장치가 개입했던 과제들이 그 격차를 만든 것이라고 밝혔습니다. 능력의 차이가 아니라 개입의 흔적이라는 설명이에요.
격차는 고정된 값이 아닙니다
5.1%포인트를 안전장치의 값이라고 외워 두면 곧 틀립니다. 같은 두 판을 노력 등급을 바꿔 가며 재면 차이가 이렇게 움직여요.
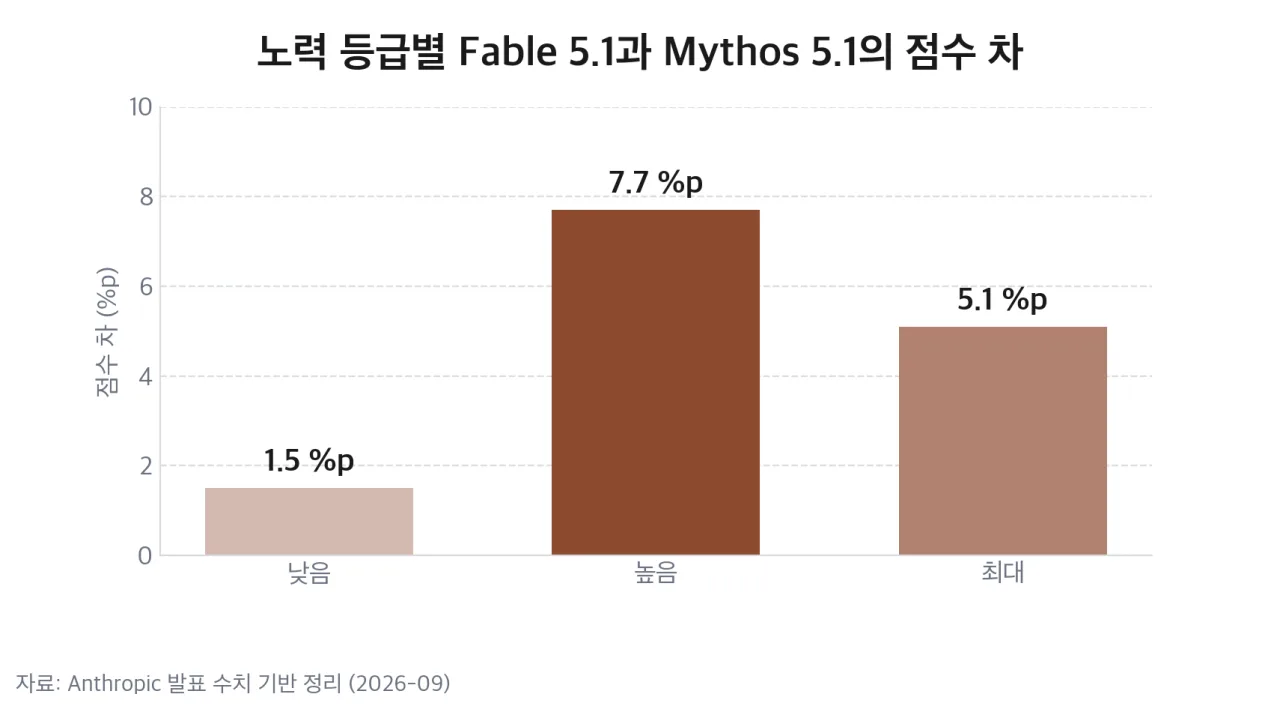 노력 등급별 두 판의 점수 차 — 출처: Anthropic 발표 수치 기반 자가 렌더
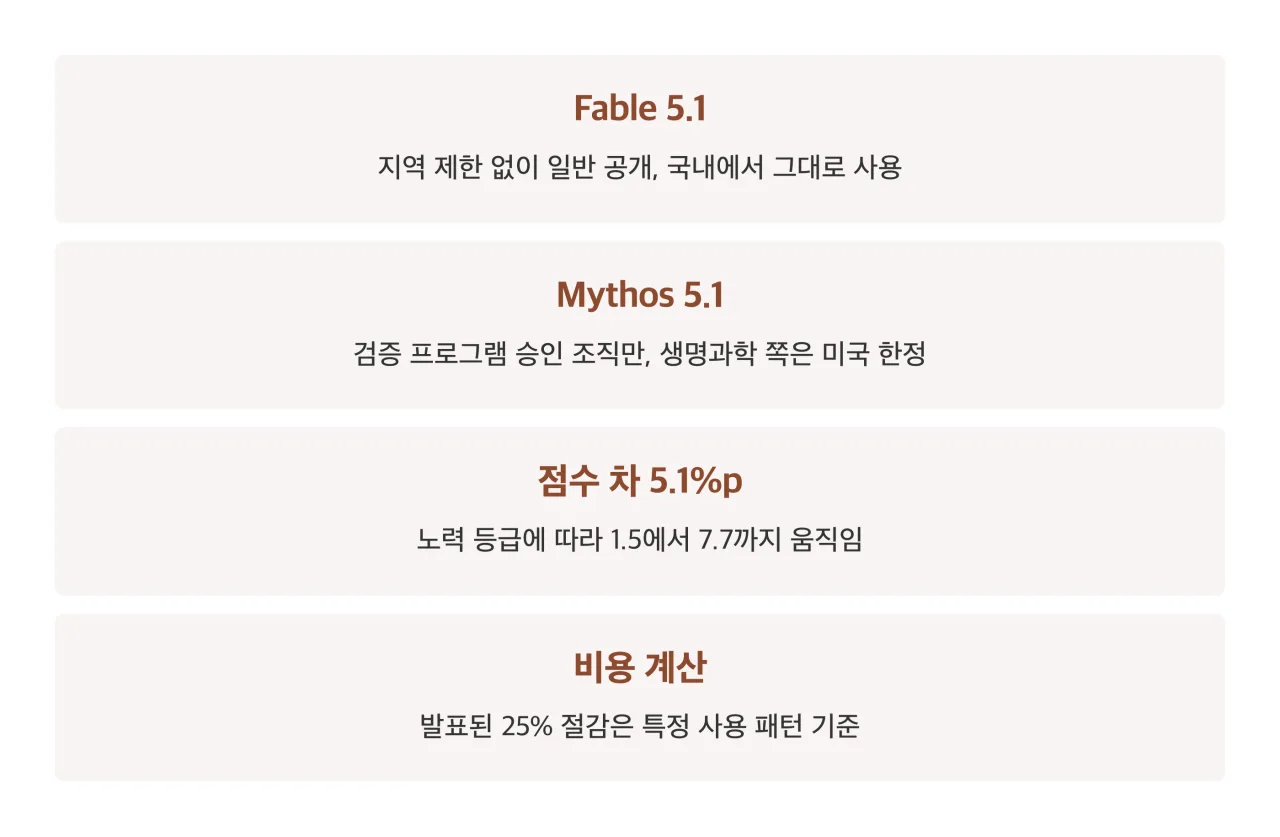
낮은 등급에서 1.5%포인트, 높은 등급에서 7.7%포인트, 최대 등급에서 5.1%포인트입니다. 등급을 올릴수록 벌어지다가 최대에서 다시 좁아지는 모양이에요.
수치의 정밀도도 감안해야 합니다. Anthropic이 밝힌 모델별 표준오차가 ±1.6에서 2.0%포인트인데, 두 판을 짝지어 비교한 신뢰구간은 공개하지 않았어요. 낮은 등급의 1.5%포인트는 오차 범위와 겹칩니다.
무엇보다 이 숫자 하나로는 안전장치가 정당한 작업을 막은 것인지, 우회 시도가 실패한 것인지, 모델이 원래 못 풀 문제였는지를 가를 수 없습니다.
안전장치를 어디까지 완화했나
이번 판의 변화는 강화한 쪽이 아니라 완화한 쪽입니다. 오탐을 줄이는 방향으로 두 영역을 손봤어요.
 같은 가중치에 다른 게이트 — 출처: 개념 컷 · agy 자가 생성
| 영역 | 달라진 것 |
|---|---|
| 사이버보안 | 정상 요청 개입 60% 감소, 소스코드 취약점 식별 허용 |
| 생물학 | 정상 요청 개입 85% 감소 (Fable 5 출시판 대비) |
| 반증류 | 새 API 계정의 사고 기록 보존 편집 차단 |
사이버 쪽에서 Claude Code 세션당 개입 횟수가 평균 60% 줄어들 것으로 봤습니다. 소스코드에서 취약점을 찾는 작업은 이제 Fable 5.1에서도 됩니다.
다만 전부 열린 것은 아니에요. 침투 테스트와 익스플로잇 생성, 바이너리 기반 스캔은 여전히 Opus 계열로 돌려보냅니다. 생물학도 초급 생물·의학 질문의 개입만 줄었고 연구개발 성격의 질의는 그대로 우회돼요.
반증류(anti-distillation)는 반대로 강화한 항목입니다. 새로 만든 API 계정은 Claude의 사고 과정 기록을 남긴 채 앞선 컨텍스트를 손으로 고치는 방식을 쓸 수 없게 됐어요. 다른 모델을 학습시키려고 사고 과정을 뽑아내던 알려진 수법을 막은 조치입니다.
기업 쪽에는 데이터 보존 항목이 하나 더 붙었습니다. Enterprise Frontier Safeguards로 고객이 관리하는 클라우드 저장소를 쓰면서 데이터를 남기지 않는 구성이 가능해지고, 올가을 여러 플랫폼에 순차 적용됩니다.
위험 등급 자체는 올라가지 않았어요. Anthropic은 화학·생물 위협에서 이 모델이 다음 위험 등급에는 아직 못 미친다고 자체 평가했습니다.
Work on safety, security, and alignment needs to advance at the same pace as AI capabilities
과학 과제에서 점수가 두 배가 됐습니다
발표 자료에서 폭이 가장 큰 항목은 과학 쪽입니다. 실험 데이터를 다루고 계산 도구를 돌려 결과를 내는 과제 모음인 Terminal-Bench-Science 0.1에서 52.6%를 기록했어요.
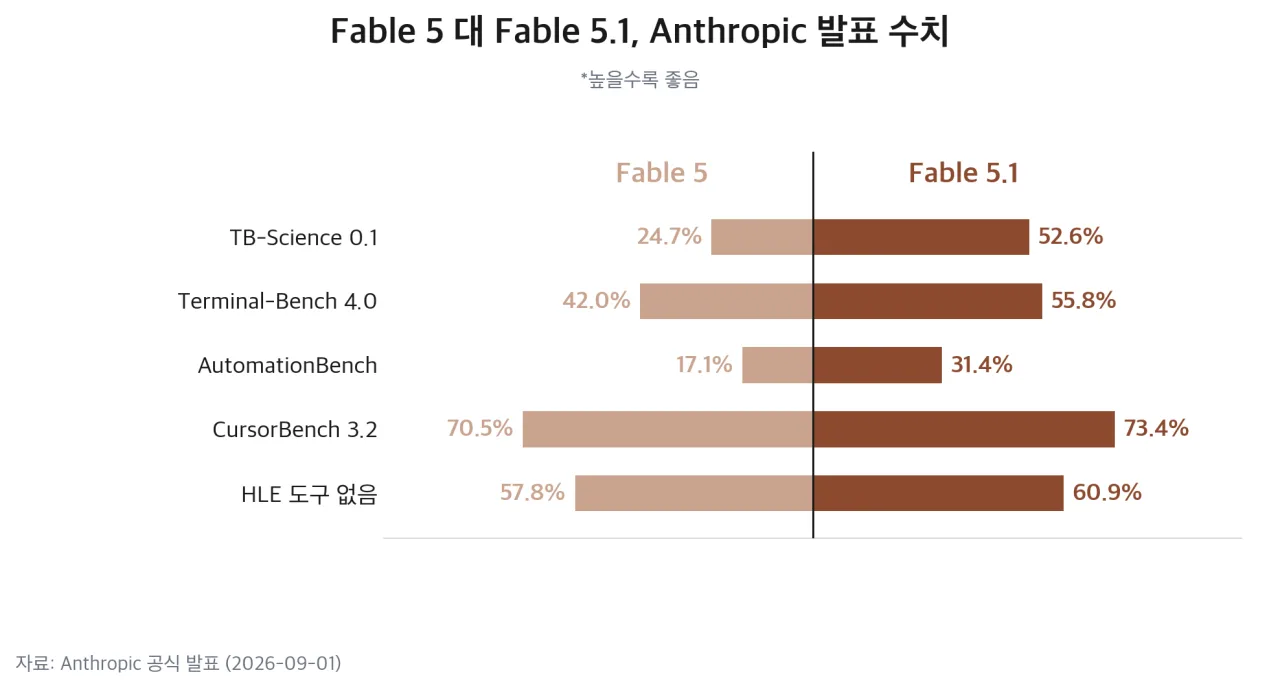 Fable 5 대 Fable 5.1 발표 수치 — 출처: Anthropic 공식 발표 수치 기반 자가 렌더
직전 세대인 Fable 5가 24.7%였으니 2.1배입니다. 같은 항목에서 Opus 5는 29.0%, GPT-5.6 Sol은 22.4%였어요.
여기에도 단서가 붙습니다. Anthropic이 이 항목의 표준오차를 3.5에서 4.5%포인트로 밝혔어요. 두 배로 뛴 폭 자체는 오차보다 훨씬 크지만, 29.0%와 24.7% 같은 근소한 순위는 그대로 믿기 어렵다는 뜻입니다.
숫자 대신 실제로 무엇을 했는지도 함께 공개됐습니다.
- 표적 12개에 대한 단백질 결합체 설계에서 적중률 약 50%, 통상적인 수치는 10~15%
- 기존 대회 우승 설계보다 결합 친화도가 10배 높은 후보를 냄
- 금성 고도 지도의 해상도를 10~20km에서 2~3km로 올리고 높이 측정 정확도를 25% 개선
- 딥러닝 모델 7개를 최대 2.5배 빠르게 고쳐 유전체 분석 GPU 비용을 30~60% 절감
제3자 측정도 1위를 줬습니다
발표사 수치만 놓고 판단할 일은 아니라서 외부 평가를 함께 봅니다. 이번에는 방향이 어긋나지 않았어요.
 OpenAI 로고 — 출처: OpenAI
| 평가 기관 | Fable 5.1 결과 |
|---|---|
| Artificial Analysis | 인텔리전스 인덱스 1위, 66점 |
| Vals AI | Vals 인덱스 1위 |
| ARC Prize | ARC-AGI-1 97.5% |
Artificial Analysis 인덱스에서 66점은 이틀 뒤 나온 GPT-6 Astra의 61점, GPT-5.6 Sol의 60.9점보다 높은 값입니다. 이 인덱스는 이후 v4.2로 개편된 뒤에도 Fable 5.1을 1위에 뒀어요.
값이 싸서 얻은 자리가 아니라는 점이 이번 결과의 의미입니다. Fable 5.1의 기본 단가는 GPT-6 Astra와 같은 입력 1만 4,000원(10달러), 출력 7만 원(50달러)이에요.
즉시 응답이 필요 없는 작업에 쓰는 배치 요금은 입력 7,000원(5달러), 출력 3만 5,000원(25달러)으로 절반입니다. Anthropic은 캐시 읽기 인하까지 얹으면 일반적인 작업에서 약 25%, 도구를 많이 쓰는 에이전트 작업에서는 최대 45%까지 값이 내려간다고 밝혔어요.
대신 같은 기관이 비용에 단서를 달았습니다. 최대 노력 설정에서 Fable 5.1은 직전 세대보다 출력 토큰을 약 1.7배 쓰고 과제당 비용이 약 20% 더 들었어요. Anthropic이 밝힌 25% 절감은 2026년 8월 한 회사의 사용 패턴을 기준으로 계산한 값이라, 본인 트래픽에서는 성공한 과제당 비용으로 다시 재 봐야 합니다.
국내에서는 어디까지 쓸 수 있나
Fable 5.1은 지역 제한 없이 일반 공개라 국내에서 그대로 씁니다. 제한이 걸린 쪽은 Mythos 5.1이에요.
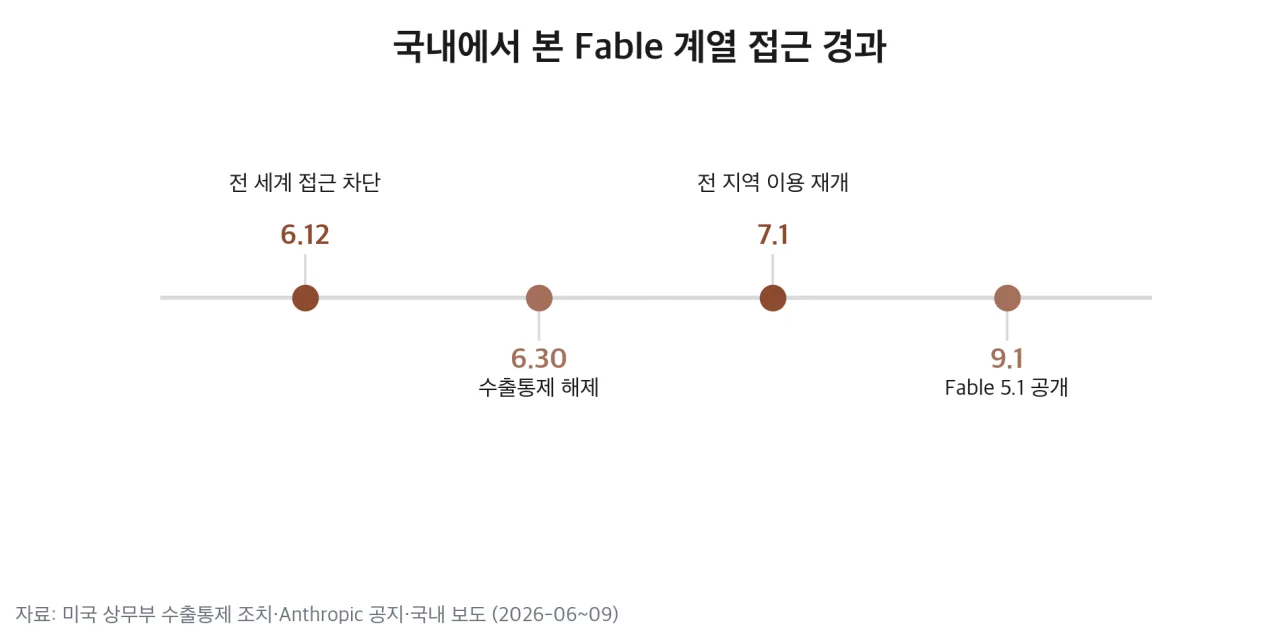 국내에서 본 Fable 계열 접근 경과 — 출처: 수출통제 조치·Anthropic 공지·국내 보도 기반 자가 렌더
6월 12일 미국 정부의 수출통제로 Fable 5와 Mythos 5가 전 세계에서 한 번에 막혔던 일이 있었습니다. 실시간으로 국적을 확인할 방법이 없어 전체를 세운 조치였고, 6월 30일 해제되면서 7월 1일부터 다시 열렸어요.
미 정부 수출통제로 막힌 Claude Fable 5·Mythos 5 접근
이번 Mythos 5.1의 제한은 성격이 다릅니다. 국적이 아니라 용도와 조직 심사로 가릅니다.
| 경로 | 조건 |
|---|---|
| Cyber Verification Program | 방어 목적 보안 업무, 신청 후 심사 |
| Life Sciences Verification Program | 초청 기반 베타, 현재 미국 조직 한정 |
사이버 쪽 검증 프로그램은 이미 Opus·Sonnet 계열의 사이버 안전장치 완화판을 열어 왔고, 여기에 Mythos 계열을 더한다는 계획입니다. 생명과학 쪽은 미국 정부와 함께 운영하는 초청 베타라 국내 연구기관이 바로 들어가기는 어려워요.
국내 조직이 완전히 밖에 있는 것은 아닙니다. Anthropic이 6월 2일 확대한 Project Glasswing에는 15개국 이상 약 150곳이 새로 들어와 참여 조직이 200곳 안팎이 됐고, 한국도 대상 국가로 보도됐어요.
앞으로 주목할 점
 지금 정리해 둘 것 — 출처: 본문 정리 · 자가 렌더
- Cyber Verification Program에 Mythos 5.1이 실제로 올라가는 시점
- 국내 기간시설 사업자의 Glasswing 경로 접근 여부
- 다음 판에서 두 판의 점수 차 축소 여부
- 타사의 안전장치 완화판 점수 동시 공개 여부
- 최대 노력 설정 시 출력 토큰 증가가 실사용 청구서에 미치는 영향
같은 가중치의 두 판을 나란히 재서 공개한 사례는 흔치 않습니다. 안전장치가 성능 손실을 얼마나 유발하는지 회사 밖에서 확인할 방법이 없었는데, 이번에는 발표사가 직접 두 값을 내놨어요.
저는 이 숫자가 안전장치를 완화하자는 근거로 쓰이는 쪽이 걱정됩니다. 5.1%포인트는 안전장치를 해제했을 때 얻는 것이 아니라, 그 판을 아무나 못 쓰게 하려고 Anthropic이 심사 절차를 따로 만든 이유에 가깝거든요.
참고 출처
- [Anthropic] Claude Fable 5.1과 Claude Mythos 5.1 공식 발표 (스펙·벤치마크·안전장치 원본)
- [MarkTechPost] Terminal-Bench-Science 52.6%와 캐시 읽기 75% 인하 (2026-09-01)
- [Karo Zieminski] 노력 등급별 격차와 표준오차 정리 (안전장치 비용 분석)
- [Vellum] Fable 5.1·Mythos 5.1 벤치마크 해설 (2026-09)
- [CNBC] Project Glasswing 150곳 확대와 대상 국가 (2026-06-02)
- [Help Net Security] Project Glasswing 확대와 취약점 발견 실적 (2026-06-03)
- 환율: 1달러 ≈ 1,400원 기준 환산