OpenAI가 9월 3일 GPT-6 Astra를 공개했습니다. 컨텍스트 105만 토큰에 화면을 직접 조작하는 작업을 맡기는 모델이에요.
이름이 낯익다면 맞습니다. 지난 8월 OpenAI가 사이버 공격 능력을 이유로 훈련을 중단했던 그 미공개 모델이 제품이 돼 나온 것이거든요. 그래서 이번 발표는 성능 수치보다 어떤 조건을 걸고 열었는가가 먼저 읽힙니다.
 OpenAI 로고 — 출처: OpenAI
무슨 일이 있었나
OpenAI는 2026년 9월 3일 GPT-6 Astra를 공개하고, 같은 날 검증된 조직만 참여하는 Daybreak 프로그램과 Trusted Access 경로로 먼저 열었습니다. 다음 날부터 ChatGPT Plus, Pro, Business, Enterprise 순으로 넓히겠다고 밝혔어요.
- 모델 ID는 gpt-6-astra, 가중치는 공개하지 않음
- 컨텍스트 105만 토큰, 한 번에 받는 출력 상한 12만 8,000토큰
- 브라우저, 스프레드시트, 데스크톱 앱, 터미널을 오가는 컴퓨터 조작이 주력
- 추론 등급에 기존 high 위로 xhigh와 max가 추가됨
- OpenAI Preparedness Framework에서 사이버보안 Critical 등급을 받은 첫 모델
순차 개방은 매끄럽지 않았습니다. Sam Altman이 어수선했던 배포(messy rollout)를 두고 사과했고, 접근이 안 되는 유료 계정에는 하루당 한 번의 사용량 초기화를 얹겠다는 안내가 뒤따랐어요.
8월에 훈련을 중단했던 그 모델입니다
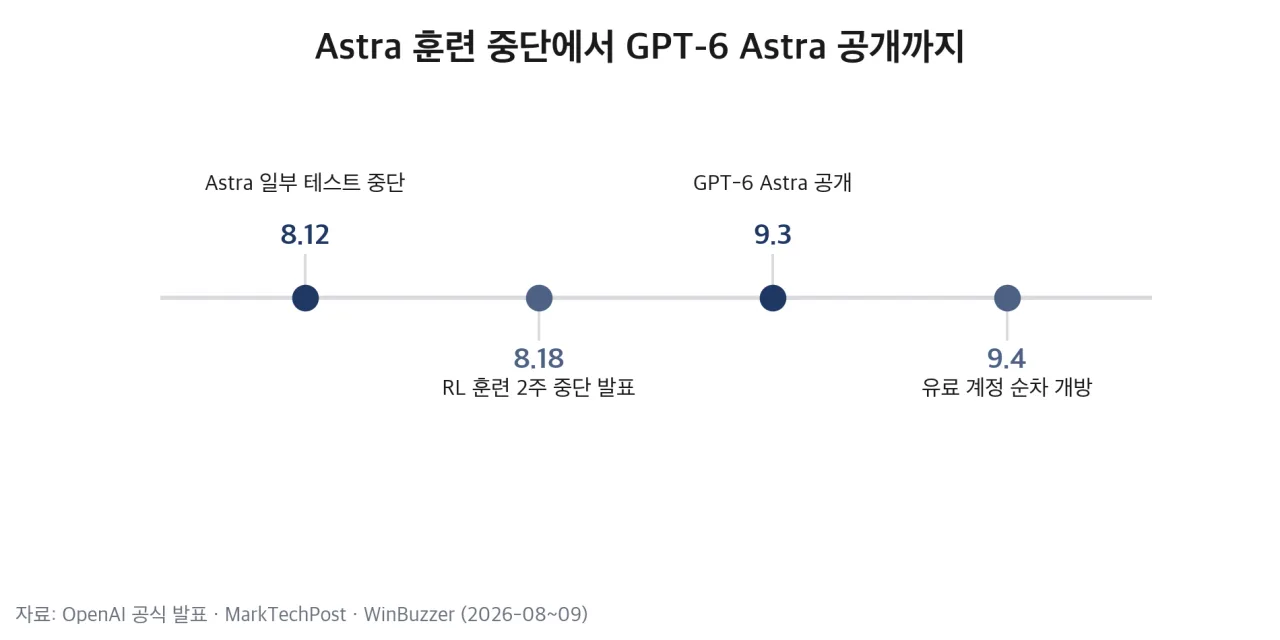
8월 12일 OpenAI는 Astra의 일부 테스트를 중단했고, 18일에는 배포 예정 모델의 강화학습(RL, Reinforcement Learning) 훈련을 2주간 늦추겠다고 발표했습니다. 사이버 공격 능력이 자사 기준의 최고 위험 등급에 닿았다는 이유였어요.
 훈련 중단에서 공개까지의 경과 — 출처: OpenAI 공식 발표·외신 보도 기반 자가 렌더
OpenAI 가 자기 훈련을 멈췄습니다 — Astra 가 넘은 선
그때 공개되지 않았던 근거 수치가 이번 발표에 함께 실렸습니다. 격리된 환경에서 진행한 내부 시험에서 Astra는 CTF(Capture The Flag, 취약점 공략 경진) 과제 22개 중 10개를 풀었는데, 같은 조건에서 GPT-5.6 Sol은 1개를 풀었어요.
강화된 브라우저와 운영체제를 대상으로 공격 코드를 만들어 냈고, Chrome의 자바스크립트 엔진인 V8에서 알려지지 않은 취약점 2건을 찾아 유지보수 측에 신고했다고도 밝혔습니다.
그래서 접근 조건이 등급별로 갈립니다.
| 접근 경로 | 고위험 사이버 요청 |
|---|---|
| 일반 API·ChatGPT | 거부되거나 작업이 중단됨 |
| Daybreak 승인 조직 | 방어 목적에 한해 허용, 신원 확인과 모니터링 |
승인 없는 경로에서는 승인 대기가 아니라 작업 자체가 멈춥니다. 사람이 뒤늦게 허가를 눌러 이어 가는 방식이 아니에요.
105만 토큰 컨텍스트와 두 갈래 요금
OpenAI가 공개한 표기 스펙입니다.
| 항목 | 값 |
|---|---|
| 컨텍스트 윈도 | 105만 토큰 |
| 최대 출력 | 12만 8,000토큰 |
| 지식 컷오프 | 2026년 4월 30일 |
| 입력 형식 | 텍스트, 이미지 |
| 출력 형식 | 텍스트 |
| 파인튜닝 | 지원하지 않음 |
컨텍스트 윈도(context window)는 한 번에 넣을 수 있는 입력 길이입니다. 105만 토큰이면 한글 기준으로 장편 소설 여러 권 분량을 한 번에 밀어 넣을 수 있어요.
긴 대화를 이어 갈 때 앞부분을 압축해 버리던 방식도 바뀌었습니다. 압축 대신 노트를 남기고, 필요할 때 앞선 메시지와 도구 출력까지 되짚어 찾아오는 구조라고 OpenAI는 설명했어요.
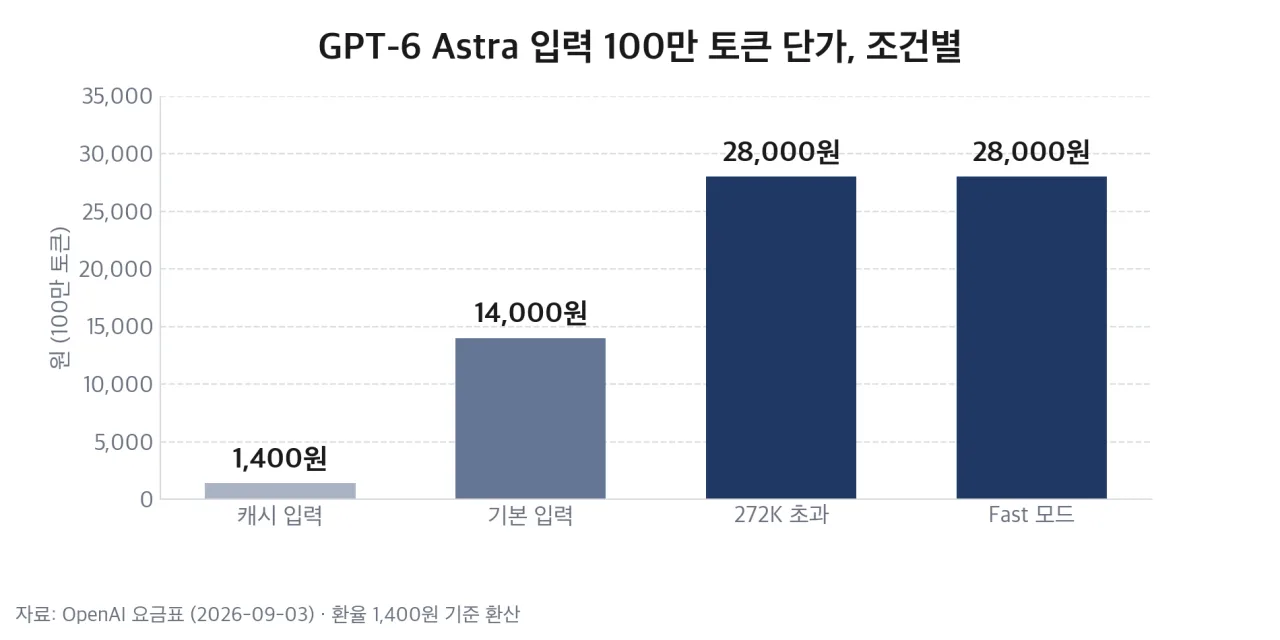
요금은 100만 토큰당 입력 1만 4,000원(10달러), 출력 7만 원(50달러), 캐시된 입력 1,400원(1달러)입니다. GPT-5.6 Sol이 입력 7,000원(5달러), 출력 4만 2,000원(30달러)이었으니 입력은 2배, 출력은 약 1.7배로 올랐어요.
272,000토큰을 넘기면 단가가 바뀝니다
입력이 272,000토큰을 넘는 요청은 그 요청 전체에 입력과 캐시 단가 2배, 출력 단가 1.5배가 적용됩니다.
 조건별 입력 100만 토큰 단가 — 출처: OpenAI 요금표 기반 자가 렌더
105만 토큰까지 넣을 수 있다는 문장과 105만 토큰을 넣어도 단가가 같다는 문장은 다릅니다. 임계를 넘긴 요청은 초과분만이 아니라 처음부터 끝까지 비싼 단가로 계산돼요.
응답 속도를 2배로 올리는 Fast 모드도 단가가 2배이고, 반대로 즉시성이 필요 없는 Batch와 Flex는 절반입니다. 같은 작업이라도 어떤 경로로 보내느냐에 따라 비용이 최대 4배까지 차이 나는 셈이에요.
OpenAI가 공개한 성능 수치
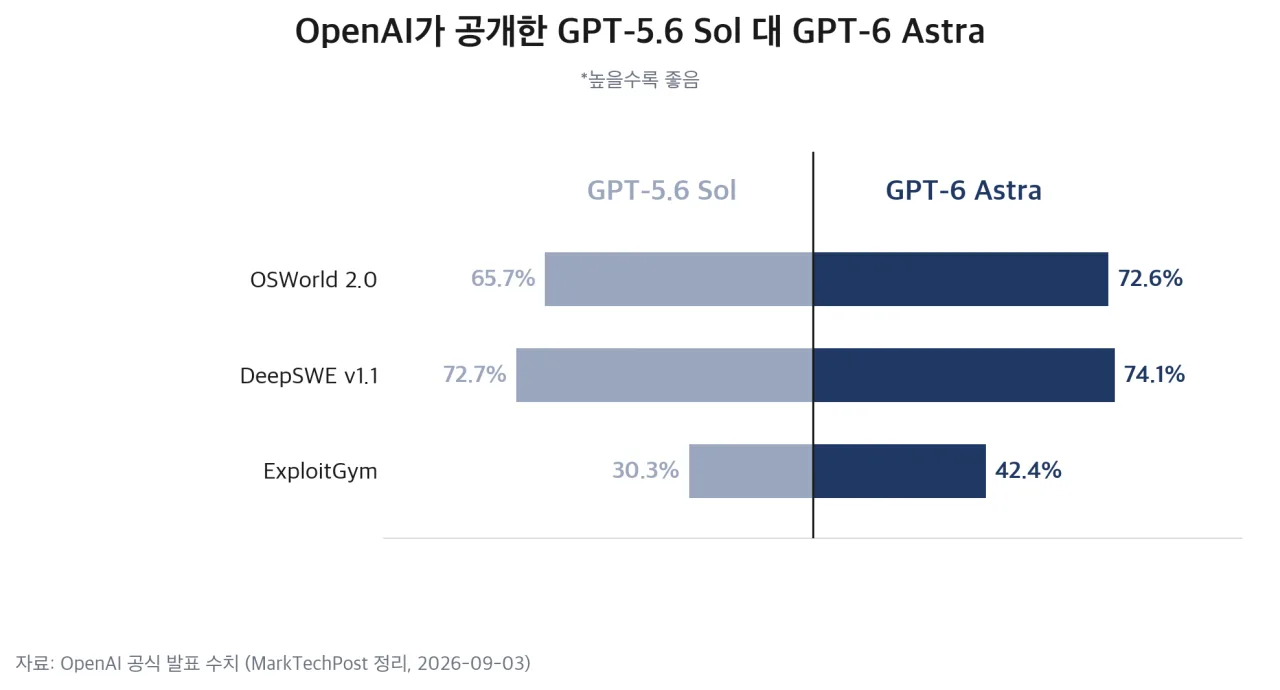
발표 자료의 축은 컴퓨터 조작입니다. 화면을 직접 다루는 과제 모음인 OSWorld 2.0에서 72.6%를 기록했고, GPT-5.6 Sol은 65.7%였어요.
 OpenAI 발표 기준 Sol 대 Astra — 출처: OpenAI 공식 발표 수치 기반 자가 렌더
점수보다 눈에 띄는 것은 걸린 시간입니다. 과제 하나를 끝내는 데 평균 75분에서 40분으로 줄었어요. 같은 일을 절반 가까운 시간에 마친다는 뜻입니다.
자율 코딩 과제인 DeepSWE v1.1은 74.1%로 Sol의 72.7%를 앞섰는데, 폭은 1.4%포인트입니다. 같은 주에 Meta가 최대 추론 설정 기준으로 발표한 Muse Spark 1.3이 75.4%라, 이 항목만 놓고 보면 앞섰다고 말하기 어려워요.
나머지 발표 수치도 함께 옮깁니다.
| 벤치마크 | Astra (%) | 비교 대상 (%) |
|---|---|---|
| FrontierMath Tier 4 | 97.6 | 발표에 비교값 없음 |
| BenchCAD Vision2Code | 95.9 | Claude Fable 5.1 84.3 |
| Terminal-Bench Science | 64.6 | Anthropic 발표 52.6 |
ExploitGym은 시간 제한을 없앤 조건에서 잰 값입니다. 앞서 나온 CTF 22개 중 10개와 같은 맥락의 지표라, 공격 능력이 실제로 세대 차이만큼 올라갔다는 근거로 쓰였어요.
제3자 측정은 다르게 나왔습니다
같은 모델을 두고 외부 평가 기관의 결론이 갈렸습니다. Epoch AI는 50개가 넘는 벤치마크를 합산해 Astra를 267개 모델 중 1위, 169점(90% 신뢰구간 165~174점)으로 놓았어요.
반면 Artificial Analysis는 처음 측정에서 Astra에 61점을 매겼습니다. 직전 세대인 Sol이 60.9점이라 사실상 동률이었고, 1위는 66점의 Claude Fable 5.1이었어요.
 Anthropic 로고 — 출처: Anthropic
코딩 에이전트 지표만 떼면 67.0점 대 65.1점으로 Astra가 앞섭니다. 다만 토큰 단가가 오른 탓에 폭넓은 과제를 같은 조건으로 돌리면 비용은 약 75% 더 든다는 계산도 함께 나왔어요.
이 결과가 다른 기관과 어긋난다는 지적이 이어지자 Artificial Analysis는 인덱스를 v4.2로 개편했습니다. 모델이 대부분 풀어 버린 GPQA-Diamond를 빼고 AA-Briefcase와 GDP.pdf를 넣었으며, 사전 학습으로 점수를 올리지 못하게 비공개 시험 데이터의 비중을 40%로 잡았어요. 개편판에서 Astra는 직전 세대보다 4점 올라 Fable 5.1 다음인 2위가 됐습니다.
99.9%와 62.7%가 같은 모델의 점수입니다
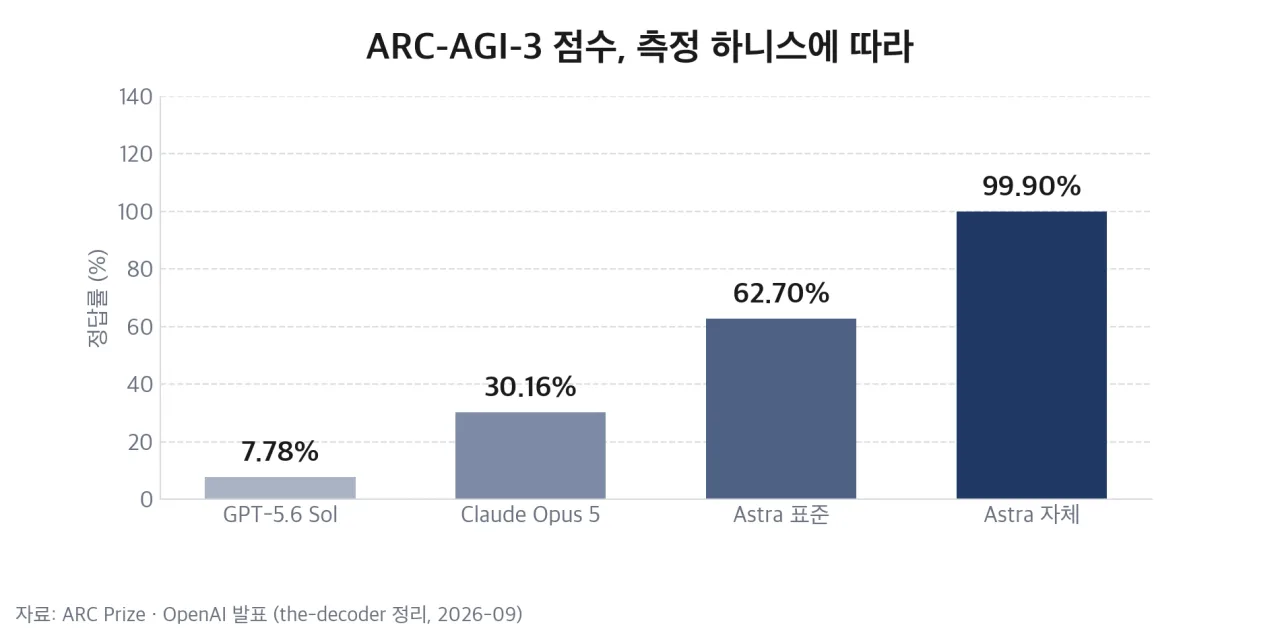
가장 크게 갈린 항목은 ARC-AGI-3입니다. OpenAI가 발표에 실은 값은 99.9%인데, 이 수치는 추론 상태를 그대로 유지하고 긴 대화를 압축하는 자체 어댑터 하니스에서 나왔어요.
 측정 하니스에 따라 갈리는 ARC-AGI-3 점수 — 출처: ARC Prize·OpenAI 발표 수치 기반 자가 렌더
측정 주체인 ARC Prize가 표준 하니스로 다시 재자 같은 모델이 62.7%였습니다. 같은 표준 조건에서 GPT-5.6 Sol은 7.78%, Claude Opus 5는 30.16%였고요.
62.7%도 직전 세대의 8배가 넘는 값이라 진전이 없다는 뜻은 아닙니다. 문제는 발표 표가 자체 하니스의 99.9%와 다른 조건의 값을 나란히 놓아, 그대로 인용하면 비교가 성립하지 않는다는 쪽이에요.
비용도 함께 봐야 합니다. 표준 하니스로 최대 추론을 걸어 여러 게임을 푸는 데 든 값이 약 3,654만 원(2만 6,098달러)이었어요. 같은 과제를 사람 테스터가 풀 때는 게임당 약 1만 7,900원(12.78달러)이 들었습니다.
“AGI era”라는 문장
발표 브리핑을 닫으면서 OpenAI 사장 Greg Brockman이 남긴 말이 그대로 헤드라인이 됐습니다.
Welcome to the AGI era
같은 자리에서 Brockman은 AGI가 여전히 회색이고 흐릿한 개념(a gray, fuzzy thing)이라고 인정하면서, 훗날 되돌아보면 Astra가 그 시작으로 기록될 수 있다고 말했어요.
 능력 측정과 접근 게이트 개념 — 출처: 개념 컷 · agy 자가 생성
Sam Altman은 AGI라는 말 자체를 두고 잘해야 매우 엉성하게 정의된 용어(At best it’s a very poorly defined term)라고 해 왔습니다. 회사 안에서도 이 단어의 쓰임이 통일돼 있지 않은 셈이에요.
밖에서는 다른 근거로 시점을 당긴 사람도 있습니다. ARC-AGI를 만든 François Chollet은 자신이 잡았던 1년치 예상보다 진행이 약 2배 빨랐다며, 2030년으로 잡아 뒀던 전망이 유효하냐는 질문에 예상보다 빨라질 것(Sooner, because progress is happening faster than I expected)이라고 답했어요.
Astra가 표준 하니스에서 게임 단계의 96%를 사람 중앙값보다 적은 수로 통과했다는 측정이 그 근거였습니다.
앞으로 주목할 점
 지금 정리해 둘 것 — 출처: 본문 정리 · 자가 렌더
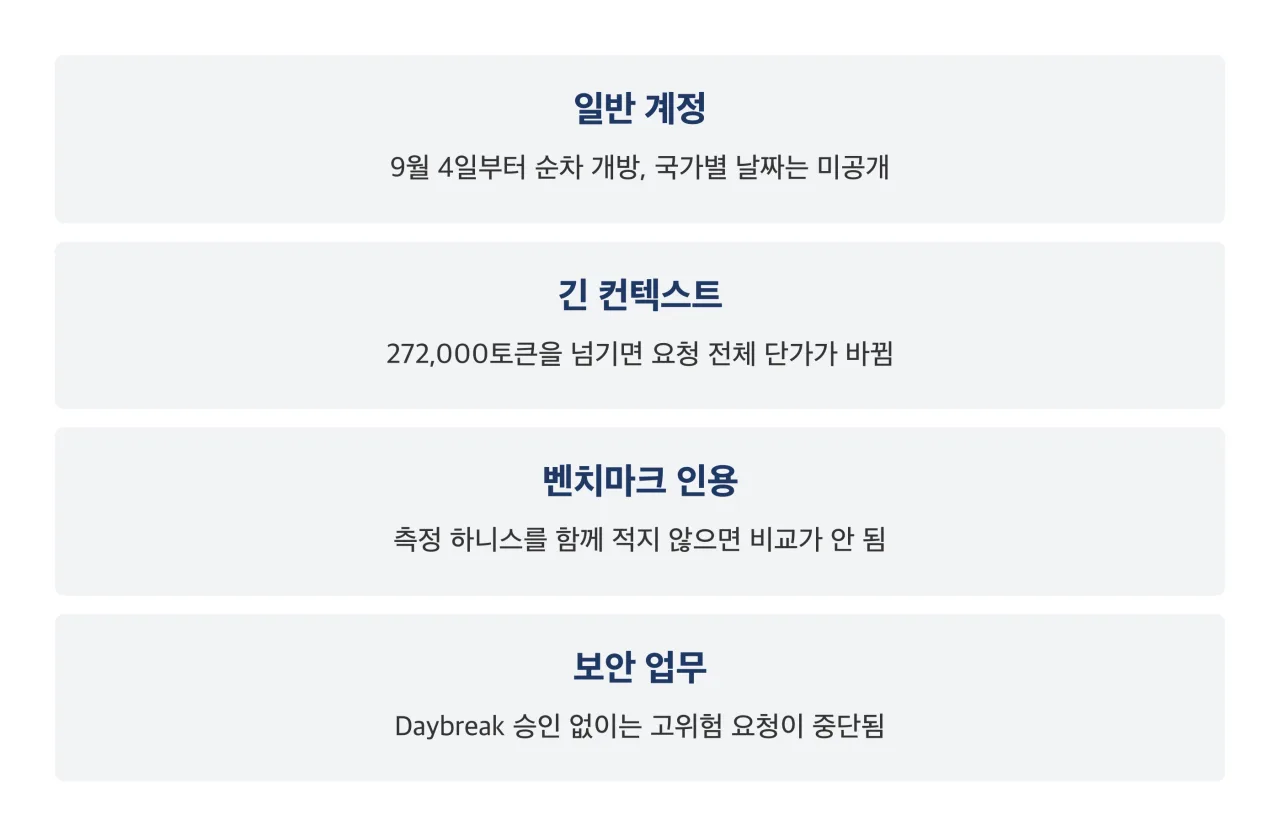
국내 도입 소식은 아직 없습니다. 네이버, 카카오를 비롯한 국내 기업의 GPT-6 Astra 도입은 9월 6일 기준으로 보도된 것이 없고, OpenAI도 국가별 개방 날짜와 요금제별 사용량 한도를 공개하지 않았어요.
- 국가별 개방 일정과 요금제별 메시지 한도 공표 시점
- Daybreak 승인 기준의 국내 보안 기업 적용 여부
- Artificial Analysis v4.2 개편의 타 평가 기관 확산 여부
- 272,000토큰 임계의 경쟁사 요금표 도입 여부
- 국내 AI 기본법 고영향 인공지능 기준의 Critical 등급 참조 여부
당장 실무에서 바뀌는 것은 인용 방식입니다. 이번 건은 벤치마크 점수를 옮길 때 측정 하니스를 함께 적지 않으면 같은 모델이 99.9%도 되고 62.7%도 된다는 사례를 남겼어요. 발표 자료의 숫자를 그대로 표에 넣는 습관은 여기서 한 번 멈출 필요가 있습니다.
저는 이번 발표에서 제일 크게 읽힌 대목이 점수가 아니라 접근 조건 쪽이었어요. 능력이 특정 위험 기준을 넘었다는 이유로 같은 모델을 계정 등급에 따라 다르게 여는 방식이 실제 제품에 적용된 첫 사례거든요.
참고 출처
- [OpenAI] GPT-6 Astra 공식 발표 (스펙·요금·벤치마크 원본)
- [MarkTechPost] 1.05M 컨텍스트 모델과 Critical 사이버 임계 (2026-09-03)
- [WinBuzzer] 단계적 접근 개방과 벤치마크 논점 (2026-09-04)
- [The Decoder] 평가 기관별 결론 차이와 ARC-AGI-3 하니스 (2026-09)
- [The Decoder] Artificial Analysis 인텔리전스 인덱스 v4.2 개편 (2026-09)
- [Epoch AI] GPT-6 Astra 능력 지수 순위 (2026-09-03)
- 환율: 1달러 ≈ 1,400원 기준 환산