마켓에서 스킬 하나를 받아 Claude Code 나 Codex에 붙이는 데는 30초도 안 걸립니다. 폴더 하나를 내려받아 지정된 자리에 두면 끝이에요.
그 30초에 무엇이 따라오는지가 문제입니다. 스킬은 지시문을 적은 SKILL.md와 함께 실행 스크립트를 품고 들어오고, 설치되는 순간 에이전트가 가진 셸 접근 권한과 파일 읽기·쓰기, 환경변수에 담긴 자격증명을 그대로 물려받습니다.
NVIDIA가 2026년 8월 공개한 오픈소스 스캐너 SkillSpector는 설치 직전에 위험을 검사하는 도구입니다. 스킬을 설치하기 전에 폴더나 저장소 주소를 입력하면 지적 목록과 위험 점수, 설치 권고를 돌려줘요.
AI 보안 (1) — 프롬프트 인젝션, AI 에이전트를 속이는 공격
 검사 관문 앞에 놓인 스킬 패키지 — 출처: 개념 컷 · agy 자가 생성
스킬 3만 개 중 넷에 하나가 취약
싱가포르·호주 연구진이 2026년 1월 arXiv에 올린 Agent Skills in the Wild는 이 생태계를 처음으로 대규모 측정했습니다. 두 마켓(skills.rest 27,365개, skillsmp.com 15,082개)에서 42,447개를 수집하고, 삭제된 저장소와 내용이 거의 없는 것을 걸러 31,132개를 분석했어요.
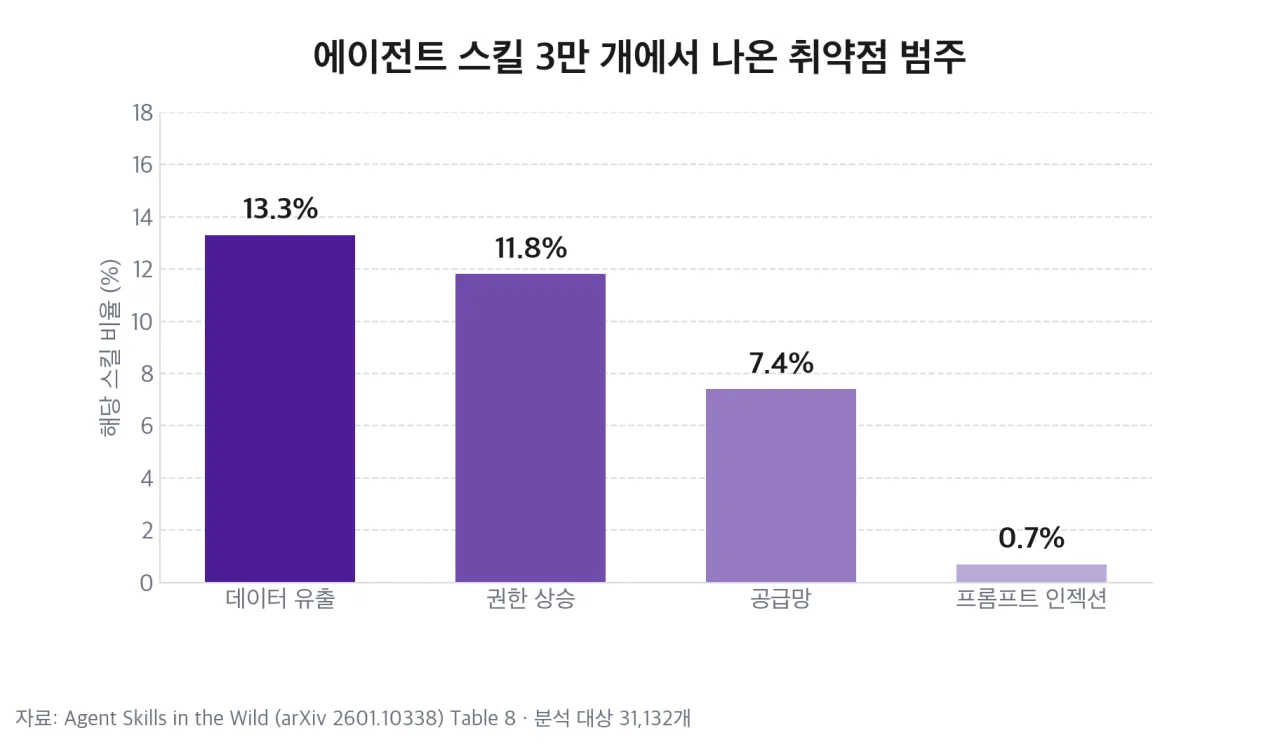
결과는 26.1%, 8,126개가 취약점을 하나 이상 갖고 있었습니다. 그중 5.2%는 단순 부주의로 보기 어려운 고위험 패턴이라 악의적 의도가 강하게 의심된다고 적었고, 8.1%는 판단이 갈리는 중간 등급, 12.8%는 관행이 나쁜 낮은 등급이었습니다.
 취약점 범주별 스킬 비율 막대그래프 — 출처: Agent Skills in the Wild (arXiv 2601.10338) 기반 자가 렌더
한 달 뒤 Snyk이 다른 두 마켓을 훑은 ToxicSkills 조사도 비슷한 결과를 냈습니다. 2026년 2월 5일 기준 3,984개 중 1,467개(36.82%)에 결함이 하나 이상 있었고, 534개(13.4%)는 심각 등급, 사람이 직접 검수해 악성 페이로드를 확인한 스킬이 76개였습니다.
| 조사 | 대상 스킬 | 주요 결과 |
|---|---|---|
| Agent Skills in the Wild (2026-01) | 31,132개 분석 | 26.1% 가 취약점 하나 이상 |
| Snyk ToxicSkills (2026-02) | 3,984개 분석 | 13.4% 가 심각 등급, 76개는 악성 |
두 조사 모두 네 마켓 어디에도 필수 보안 심사가 없다고 짚었습니다. 등록하면 바로 올라가고, 내려받으면 그대로 실행됩니다. Snyk은 발표 시점에도 악성으로 분류한 스킬 여덟 개가 마켓에 그대로 남아 있었다고 밝혔어요.
기존 스캐너가 산문을 못 읽는다
1탄과 2탄에서 다룬 프롬프트 인젝션은 공격이 입력값을 타고 들어오는 이야기였는데, 스킬은 그 입력값이 배포 단위로 굳은 형태예요. 공격자가 대화 도중 무언가를 흘려 넣을 필요가 없습니다.
문제는 그 지시문이 코드가 아니라 산문이라는 점입니다. SKILL.md에 적힌 프롬프트 인젝션에는 위험한 API 호출도, 취약한 의존성도, 유출된 자격증명 문자열도 없습니다. 기존 보안 도구가 찾도록 만들어진 신호가 하나도 없어요.
| 도구 | 무엇을 보나 | 산문을 읽나 |
|---|---|---|
| Semgrep | 코드 패턴 | 아니오 |
| Bandit | 파이썬 호출 | 아니오 |
| OSV-Scanner | 알려진 CVE | 아니오 |
| TruffleHog | 자격증명 문자열 | 아니오 |
| SkillSpector | SKILL.md 산문과 스크립트 | 예 |
 코드 모듈만 붙잡고 산문 시트는 그대로 통과하는 검사 광선 — 출처: 개념 컷 · agy 자가 생성
취약점 범주 가운데 프롬프트 인젝션이 0.7%로 유독 낮았던 것도 같은 이유입니다. 연구진은 이 수치를 두고 실제로 드물기도 하지만 자연어 조작 패턴을 탐지하기가 어렵기 때문이라고 적었어요. 낮은 숫자가 안전의 근거가 아니라 측정 한계의 흔적일 수 있다는 뜻입니다.
산문은 코드 스캐너에게 그냥 깨끗한 글입니다
SkillSpector가 보는 것
SkillSpector는 Apache 2.0 라이선스로 공개돼 있고, 폴더·zip·SKILL.md 한 장·Git 저장소 주소를 모두 입력으로 받습니다. 17개 범주에 걸친 71개 패턴을 보고, 결과를 터미널·JSON·마크다운·SARIF로 냅니다.
 SkillSpector를 공개한 NVIDIA 로고 — 출처: NVIDIA
검사는 두 단계입니다. 1단계는 정적 분석이라 몇 초면 끝나요. AST를 훑어 exec·eval·subprocess·동적 import를 표시하고, 환경변수와 파일 내용이 네트워크로 나가는 경로를 taint 추적으로 따라가고, YARA 규칙으로 알려진 악성코드와 웹셸, 암호화폐 채굴 코드를 탐지합니다. 그 위에 정규식 패턴이 프롬프트 인젝션·자격증명 탈취 같은 범주를 훑습니다.
2단계는 선택 사항인 LLM 판독입니다. OpenAI 호환 엔드포인트를 붙이면 모델이 1단계에서 걸린 자리를 문맥과 함께 읽고 오탐을 걸러내요. 저장소가 밝힌 정밀도는 이 단계까지 돌렸을 때 약 87%입니다.
지적마다 점수를 쌓아 100점에서 자릅니다. 실행 가능한 스크립트가 있으면 1.3배를 곱해요.
| 점수 | 등급 | 권고 |
|---|---|---|
| 0~20 | LOW | SAFE |
| 21~50 | MEDIUM | CAUTION |
| 51~80 | HIGH | DO NOT INSTALL |
| 81~100 | CRITICAL | DO NOT INSTALL |
공식 저장소 스킬 19개 직접 검사
Anthropic이 공개한 공식 스킬 저장소 anthropics/skills의 스킬 19개를 직접 설치해 돌렸습니다. 버전은 SkillSpector v2.11.1, 조건은 API 키 없이 쓰는 정적 단독(–no-llm)입니다.
설치와 실행은 두 줄이면 끝납니다.
💻 [소스코드: SkillSpector 설치와 스킬 한 개 스캔]
uv tool install \
  git+https://github.com/NVIDIA/skillspector.git
skillspector scan ./my-skill/ --no-llm
먼저 pdf 스킬 하나입니다. 점수 7점에 등급은 LOW 인데 권고는 SAFE가 아니라 CAUTION이 나왔어요. 지적은 하나, SKILL.md가 그 스킬이 쓸 도구 범위(allowed-tools)를 선언하지 않았다는 것입니다.
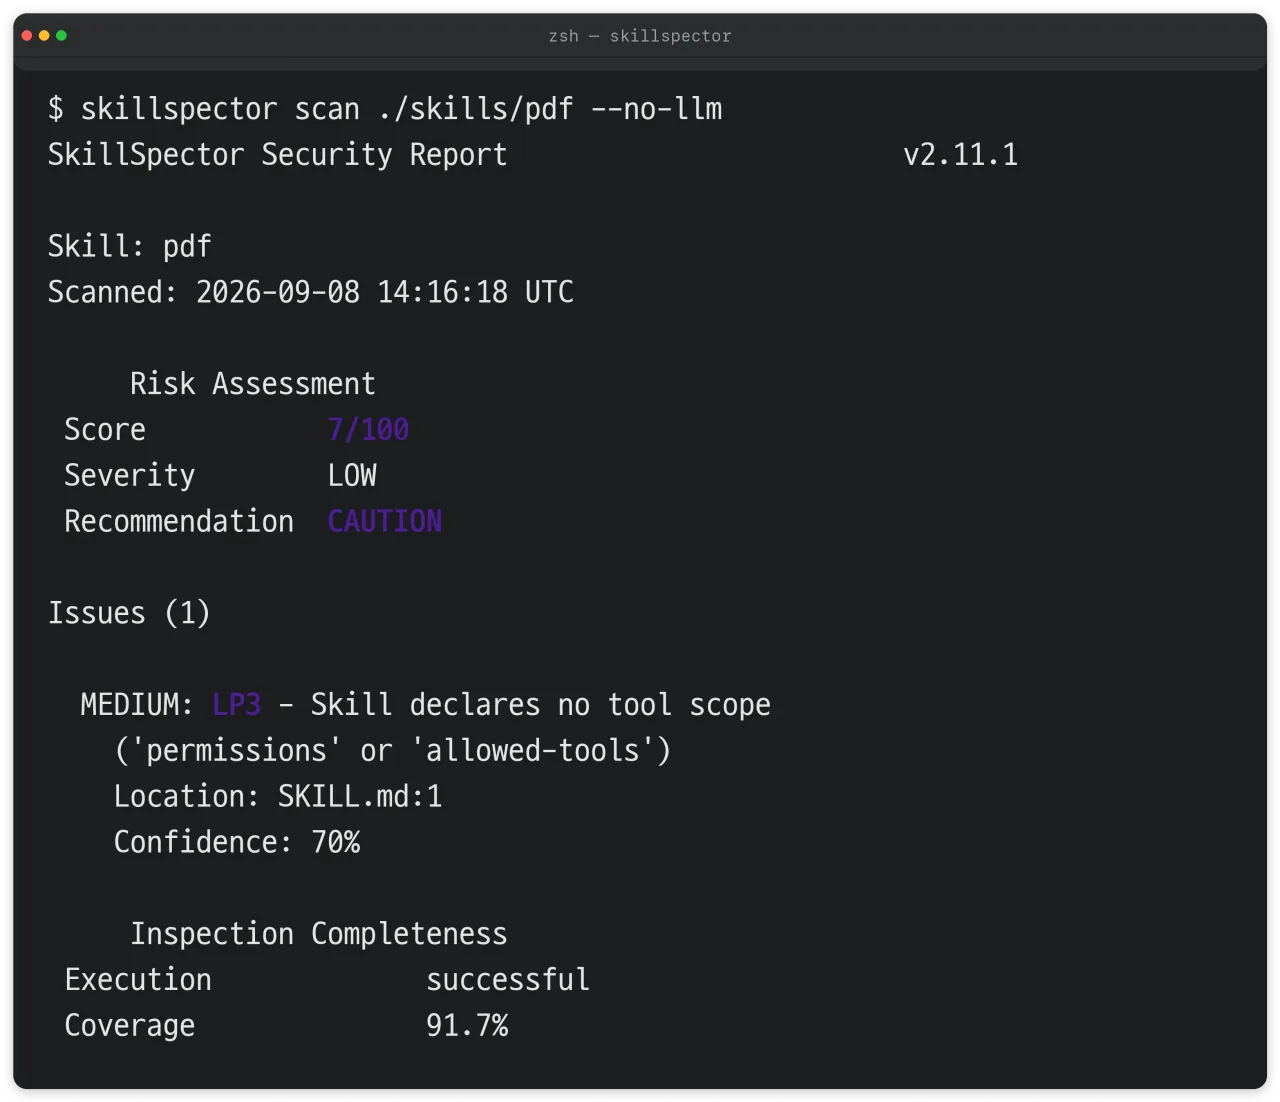 공식 pdf 스킬을 스캔한 터미널 화면 — 출처: SkillSpector v2.11.1 실행 화면 자가 렌더
Anthropic이 직접 만들어 공개한 스킬인데도 권고가 CAUTION으로 내려옵니다. 도구 범위를 선언하지 않은 스킬은 에이전트가 가진 도구를 그대로 다 쓸 수 있다는 뜻이니, 지적 자체는 타당해요.
여섯 개가 받은 DO NOT INSTALL 권고
19개를 전부 돌린 결과 SAFE는 한 개도 없었습니다. 다섯 개가 100점 만점, xlsx가 92점으로 CRITICAL 등급을 받았고 webapp-testing이 64점으로 HIGH 여서, 여섯 개가 DO NOT INSTALL 권고를 받았습니다.
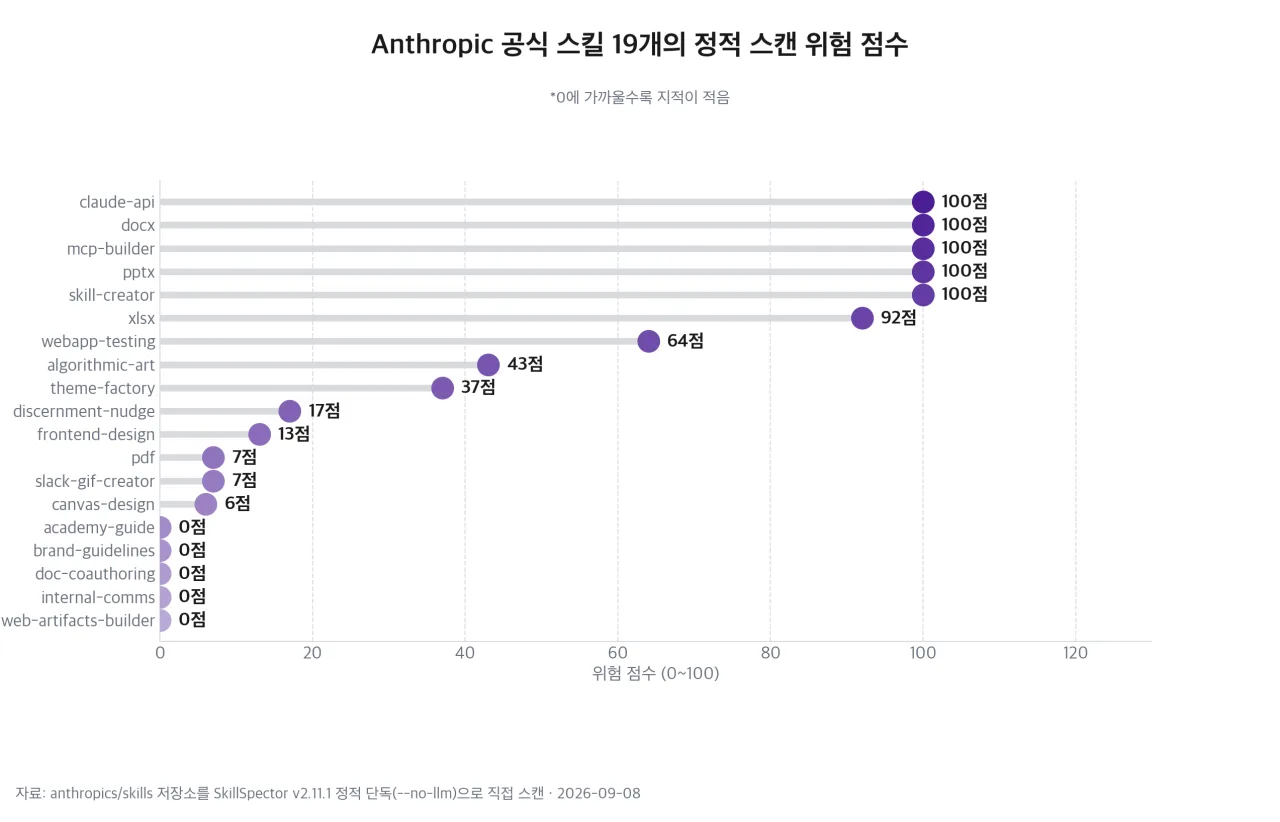 공식 스킬 19개의 정적 스캔 위험 점수 — 출처: anthropics/skills 저장소 직접 스캔 기반 자가 렌더
숫자만 보면 공식 저장소가 위험해 보이지만, 지적 301건을 하나씩 열어 보면 그림이 달라집니다.
가장 높은 점수를 받은 claude-api는 실행 스크립트가 아예 없는 문서 스킬입니다. 지적 151건 중 48건이 analysis-evasion 범주의 HIGH 인데, 내용은 참조한 파일을 끝까지 들여다보지 못했다는 뜻이었어요. 스캐너가 못 본 것을 위험으로 세는 자리입니다.
| 스킬 | 걸린 자리 | 스캐너가 붙인 범주 |
|---|---|---|
| canvas-design | 폰트 라이선스의 NOT LIMITED TO | Excessive Agency |
| claude-api | 표를 맞추려고 넣은 공백 87칸 | Prompt Injection |
| skill-creator | 문서에 적힌 nohup 실행 예시 | Rogue Agent |
폰트 파일에 딸려 온 OFL 라이선스 면책 조항의 관용구가 권한 범위를 벗어난다는 신호로 잡히고, 마크다운 표를 정렬하려고 넣은 공백이 지시문을 화면 밖으로 밀어내는 수법으로 잡힙니다. 셋 다 정적 단독 단계라 그렇습니다. 이 단계는 재현율을 높게 잡고 정밀도를 포기하도록 설계돼 있어요. 실제로 한 검증 실험에서는 정상 스킬의 정적 지적 20건 중 16건이 무해한 GitHub API 호출이었고, LLM 단계를 붙이자 27점에 확인된 지적 4건으로 정리됐습니다.
점수 100은 악성이라는 뜻이 아니라 지적이 많다는 뜻입니다
그렇다고 정적 단계가 무의미한 것은 아닙니다. skill-creator의 subprocess 호출과 pdf의 도구 범위 미선언은 실제로 확인할 값어치가 있는 지적이고, 악성 검체를 넣은 실험에서는 정적 단독으로도 100점에 설치 금지 판정이 나왔습니다. 그때 가장 높은 위험도로 잡힌 것도 코드가 아니라 마크다운에 적힌 평문이었어요.
스캐너 통과가 안전을 보장하지는 않습니다
반대 방향의 한계도 분명합니다. 표현만 바꿔 쓴 위협은 알려진 패턴을 비껴가고, 코드가 문서에 적힌 기능보다 더 많은 일을 하는 경우는 정적 단계에서 잘 안 보여요. 실제 자동화 스킬을 검사한 사례에서는 저장소 하나에만 적용해야 할 설정을 전역 Git 설정으로 조용히 바꾸는 동작이 LLM 단계에 가서야 드러났습니다.
국내에서도 판단 기준을 만드는 작업이 진행 중입니다. 과학기술정보통신부와 KISA는 2026년 7월 8일 AI 보안 위협 대응 매뉴얼을 냈는데, 데이터·모델·에이전트·공급망·고성능 모델로 위협을 나누고 금융·의료·공공 등 8개 분야별 대응 기준을 담았어요. 프롬프트 인젝션과 권한 오남용, 데이터 유출이 명시된 항목입니다.
과기정통부와 NIA는 별도로 18억 원을 들여 MCP 안전·신뢰성 검증 체계를 2026년 안에 구축하기로 했습니다.
설치 전에 볼 것
스킬을 받기 전에 확인할 것은 다섯 가지로 줄어듭니다.
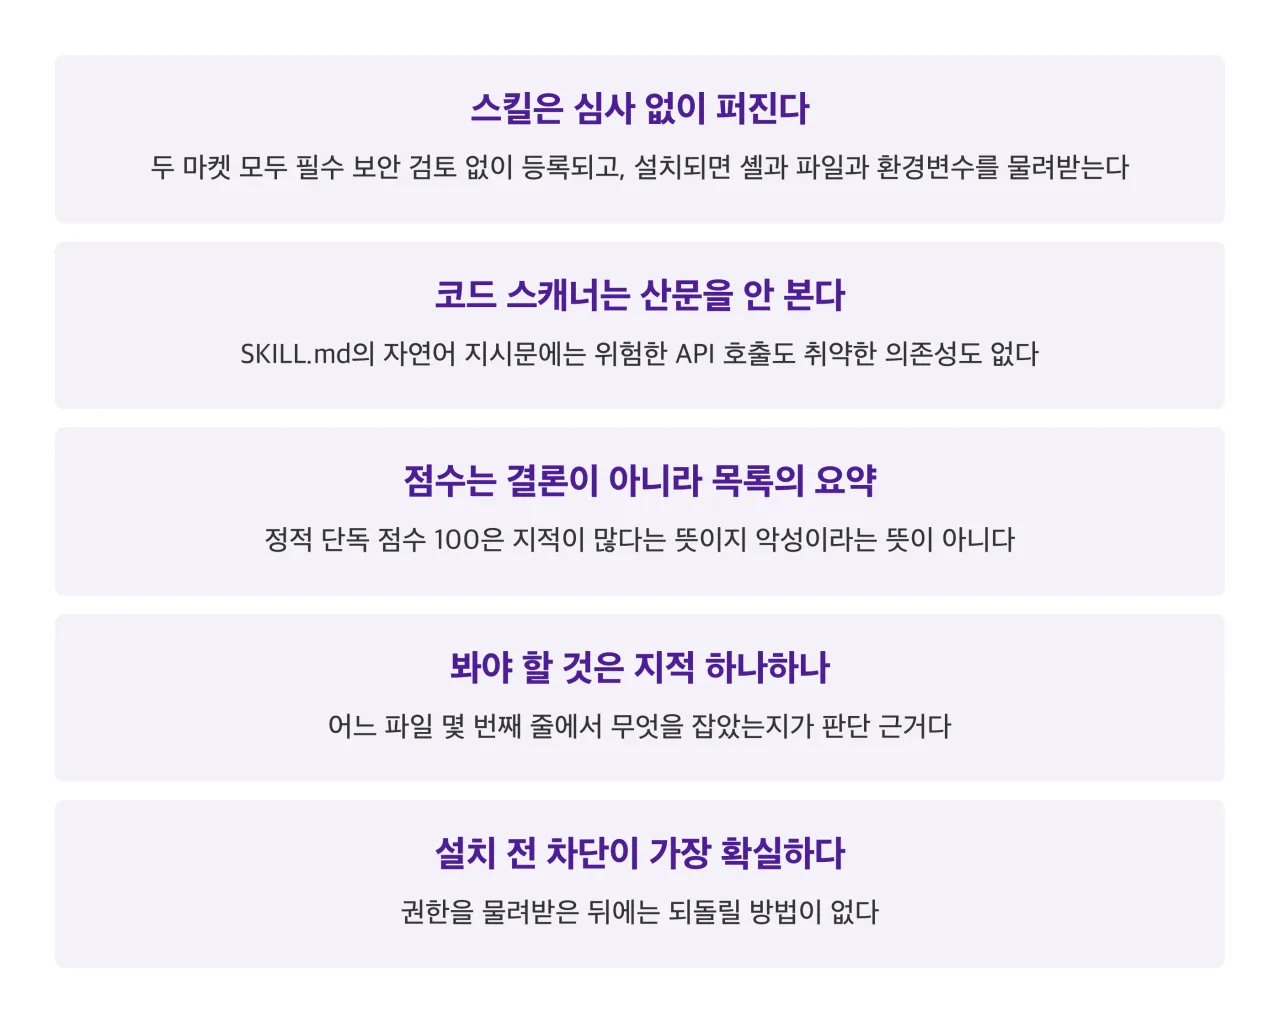 설치 전 점검 5항목 카드 — 출처: 개념 정리 · 자가 렌더
설치 전에 스캐너를 한 번 돌리고, 점수가 아니라 지적 목록을 열어 파일과 줄 번호를 확인하세요. SKILL.md에 allowed-tools가 선언돼 있는지 보고, 스크립트가 환경변수를 읽어 네트워크로 보내는 자리가 있는지 찾습니다. 판단이 서지 않으면 설치하지 않는 쪽이 맞아요. 권한을 넘겨준 뒤에 되돌릴 방법은 없습니다.
운영자 쪽이라면 사내에서 쓰는 스킬 목록을 한 번 정리하고, 마켓에서 받은 것과 직접 만든 것을 갈라 두는 것부터가 시작입니다.
의심스러운 스킬이나 실제 피해를 만났다면 KISA 인터넷침해대응센터(118)와 개인정보보호위원회 신고 창구를 이용하면 됩니다.
🔗 링크 첨부 - https://www.krcert.or.kr
AI 보안 (3) — 메신저·메일 AI 요약에 숨은 프롬프트 인젝션
참고 출처
- [arXiv] Agent Skills in the Wild: An Empirical Study of Security Vulnerabilities at Scale (42,447개 수집·31,132개 분석, 범주별 비율)
- [NVIDIA] SkillSpector 저장소 README (17개 범주 71개 패턴·점수 구간·설치 방법)
- [Help Net Security] SkillSpector: NVIDIA’s open-source security scanner for AI agent skills (2단 구조·정밀도)
- [Snyk] ToxicSkills 조사 (3,984개 중 1,467개 결함·534개 심각·악성 76개)
- [Towards Data Science] Auditing AI Agent Skills with SkillSpector (정적 단계 오탐·기존 스캐너 대조·검증 실험)
- [이투데이] 과기정통부·KISA, AI 보안 위협 대응 매뉴얼 발간 (2026-07-08)
- [ZDNet Korea] 검증 모델 부족해 확산 제약, 정부 AI 에이전트·MCP 안전망 (MCP 검증체계·예산)
- 직접 측정: anthropics/skills 저장소를 SkillSpector v2.11.1 정적 단독(–no-llm)으로 스캔, 2026-09-08