Anthropic이 2026년 9월 22일 Claude Opus 5.5를 공개했습니다. 상위 모델인 Claude Fable 5.1과 대부분의 작업에서 비슷한 성능을 내면서, 요금은 Opus 5보다 입력·출력 모두 20% 내렸어요.
Anthropic은 기본 설정 기준으로 일반적인 작업 비용이 Opus 5보다 40% 적다고 밝혔습니다.
다만 API를 이미 쓰고 있다면 모델 이름만 바꾸는 것으로는 충분하지 않아요. Opus 5에서 되던 요청 네 가지는 400 오류를 반환합니다.
 Claude Opus 5.5 공식 발표 키 비주얼 — 출처: Anthropic
발표 요지
Claude Opus 5.5는 새 Claude 5.5 제품군의 첫 모델이고, Anthropic CEO Dario Amodei가 프런티어 모델 개발 속도를 조절해야 한다는 글을 공개한 뒤 처음 나온 모델입니다. 같은 세대의 Sonnet 5.5와 Haiku 5.5는 수 주 안에 출시된다고 예고했어요.
- 성능: 대부분 작업에서 Fable 5.1 수준, Anthropic이 공개한 벤치마크 9개 중 7개에서 비교 모델 가운데 최고점
- 요금: 100만 토큰당 입력 5,600원(4달러), 출력 28,000원(20달러)
- 속도: 출력 생성 속도가 Opus 5보다 30% 이상 빠름
- 컨텍스트 윈도(context window, 한 번에 받는 입력 길이): 100만 토큰, 최대 출력 12만 8,000토큰으로 Opus 5와 같음
- 제공처: Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry
- 구독: Pro·Max·Team·좌석형 Enterprise 요금제의 5시간 사용 한도 상향, 구독자에게 원하는 때 사용 한도를 초기화할 수 있는 기회 1회 제공
Anthropic은 Opus 5.5가 Opus 5보다 서빙에 드는 연산이 적고, 요금 인하가 그 차이를 반영한 것이라고 설명했습니다.
벤치마크 수치
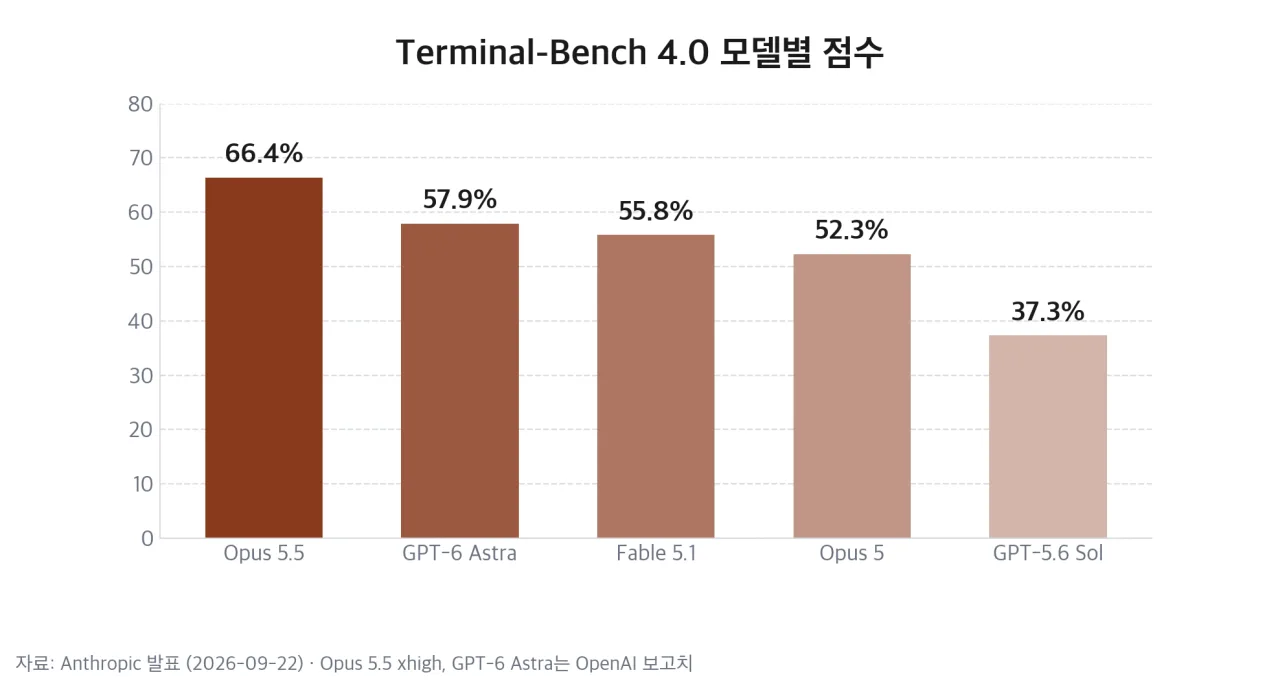 Terminal-Bench 4.0 모델별 점수 — 출처: Anthropic 발표 수치 기반 자가 렌더
Terminal-Bench 4.0은 모델이 터미널에서 명령을 실행하며 과제를 푸는 에이전트(agent) 벤치마크입니다. Opus 5.5는 66.4%로 GPT-6 Astra(57.9%)와 Fable 5.1(55.8%)을 앞섰고, Opus 5(52.3%)보다 14.1%포인트 높아요. Opus 5.5는 xhigh 설정 값이고, GPT-6 Astra는 OpenAI가 보고한 high 설정 값입니다.
Fable 5.1과의 비교
| 벤치마크 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| FrontierCode v1.1 (%) | 54.4 | 50.3 |
| CursorBench 4.0 (%) | 57.8 | 51.8 |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 |
| HLE 도구 사용 (%) | 67.7 | 65.6 |
| OSWorld 2.0 (%) | 81.8 | 80.7 |
| Chartography (%) | 89.0 | 88.4 |
코딩 도구 과제인 CursorBench 4.0에서 6.0%포인트, 지식 노동 과제를 Elo 점수로 겨루는 GDPval-AA에서 111점 차이가 납니다. 컴퓨터 조작(OSWorld 2.0)과 차트 판독(Chartography)은 1%포인트 안쪽이라, 이 구간에서는 Anthropic이 말한 대로 Fable 5.1과 대등한 수준에 가깝습니다.
GPT-6 Astra와의 비교
| 벤치마크 | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| AutomationBench (%) | 40.0 | 41.4 |
| Terminal-Bench-Science 0.1 (%) | 58.7 | 64.6 |
| HLE 도구 사용 (%) | 67.7 | 57.2 |
| GDPval-AA v2.1 (Elo) | 1846 | 1542 |
업무 자동화(AutomationBench)와 과학 분야 터미널 과제(Terminal-Bench-Science)는 GPT-6 Astra가 높습니다. Anthropic은 안전장치를 켠 상태로 평가했고, 안전장치가 개입하면 사이버보안 과제는 Opus 4.8이, 생물학과 LLM(대규모 언어모델) 개발 과제는 Opus 5가 대신 풀었다고 각주에 적었어요. 과학 과제 점수가 이 영향으로 낮게 나왔을 수 있다는 것이 Anthropic의 설명입니다.
요금 변화
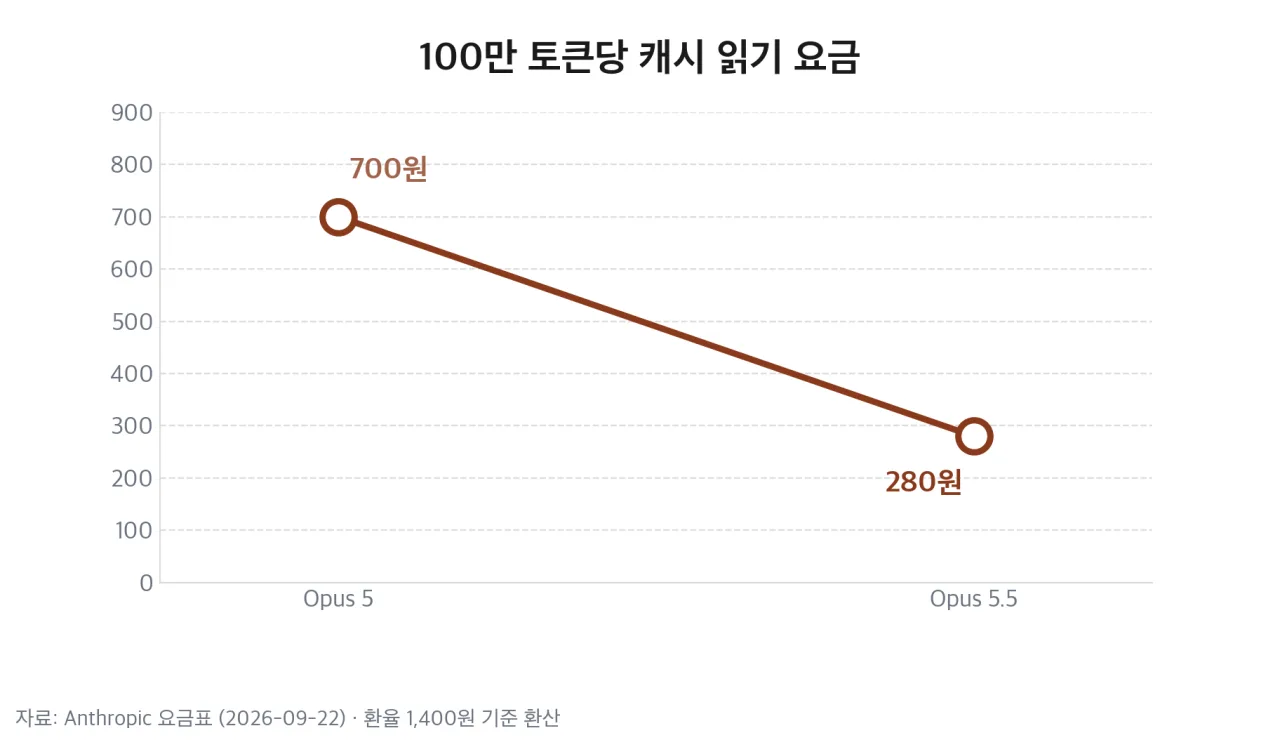 100만 토큰당 캐시 읽기 요금 변화 — 출처: Anthropic 요금표 기반 자가 렌더
가장 크게 인하된 항목은 캐시 읽기(cache read)입니다. 이전에 보낸 긴 입력을 저장해 두고 다시 읽을 때 부과되는 요금인데, 100만 토큰당 700원(0.50달러)에서 280원(0.20달러)으로 60% 내렸어요. Anthropic은 에이전트·코딩 작업 비용의 대부분이 캐시 읽기에서 발생한다고 설명했습니다.
| 100만 토큰당 | Opus 5 | Opus 5.5 |
|---|---|---|
| 입력 | 7,000원 | 5,600원 |
| 출력 | 35,000원 | 28,000원 |
| 캐시 쓰기 (5분) | 8,750원 | 7,000원 |
- 캐시 쓰기 (1시간): 11,200원(8달러)
- 배치 처리(batch): 기본의 절반, 입력 2,800원·출력 14,000원
- Fast mode: 최대 2.5배 빠른 출력, 입력 11,200원·출력 56,000원, Claude API와 Claude Code에서만 제공(Bedrock·Google Cloud·Foundry 미제공)
40% 절감은 단가 인하 20%에 같은 작업에 드는 토큰 감소가 더해진 수치입니다. 기본 설정끼리 비교한 값이라 기본 effort가 Opus 5의 high에서 Opus 5.5의 medium으로 내려간 차이도 반영돼 있어요. 초기 사용 기업들은 토큰 감소를 구체적인 숫자로 밝혔습니다.
- Optiver: Opus 5와 같은 품질을 턴 수·시간·출력 토큰 절반으로 달성, 비용 40~50% 감소
- Box: Opus 5 대비 토큰 3분의 1 사용, 정확도 유지
- Kiro: Opus 5보다 더 많은 과제를 풀면서 호출 40% 감소, 토큰 절반 사용
- Deloitte: 가장 낮은 effort에서 알려진 버그 72% 발견, Opus 5는 high에서 56%
API 요금은 달러로 청구돼 국내 사용자는 환율에 따라 원화 부담이 달라집니다.
개발자가 바꿔야 할 것
 thinking 상시 작동과 effort 설정 개념 컷 — 출처: 개념 컷 · agy 자가 생성
모델 ID는 날짜 접미사 없는 claude-opus-5-5입니다. Opus 5 코드에 이 이름만 지정하면 아래 네 가지에서 400 오류가 납니다.
| 항목 | Opus 5 | Opus 5.5 |
|---|---|---|
| thinking 끄기 | high 이하에서 가능 | 400 오류 |
| 강제 tool_choice | 가능 | 400 오류 |
| computer_20251124 | 가능 | 400 오류 |
| thinking 블록 재전송 | 앞 내용 편집 허용 | 편집 시 400 오류 |
[thinking 끄기] thinking: disabled와 수동 budget_tokens 둘 다 거부됩니다. 추론은 항상 켜져 있고 깊이는 effort 값(low·medium·high·xhigh·max)으로만 조절해요.
[강제 tool_choice] tool_choice의 any·tool을 받지 않습니다. auto에 strict tool use나 structured outputs를 쓰고, 도구를 언제 쓸지는 프롬프트에 적습니다.
[구형 computer use 도구] Claude API와 Google Cloud에서는 computer_toolset_20260801로 전환해야 합니다. Amazon Bedrock은 기존 computer_20251124가 계속 작동합니다.
[thinking 블록] 2026년 8월 31일 이후 만든 계정은 system 프롬프트·도구·이전 메시지를 고친 뒤 thinking 블록을 다시 보내면 400 오류가 납니다. 대화를 뒤에 덧붙이는 방식으로만 이어 가면 문제가 없어요.
💻 [소스코드: Opus 5.5 호출 예시 (Python)]
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "high"},
    messages=messages,
)
도구 호출 사이에 모델이 쓰던 진행 메모는 오류 없이 text 블록이 아니라 thinking 블록으로 반환되고, 기본 설정에서는 내용이 비어 있어요. 진행 상황을 화면에 보여 주던 서비스는 display 값을 updates(베타)나 summarized로 바꿔야 다시 보입니다. 거절 응답 분류에는 cyber 외에 bio와 reasoning_extraction이 추가됐습니다.
Claude Code에서는 /claude-api migrate 명령으로 모델 ID 교체와 파라미터 수정을 한 번에 적용할 수 있습니다.
안전장치와 속도 조절론
 Anthropic 로고 — 출처: Anthropic
Anthropic은 출시 전 METR과 Frontier Design에 외부 평가를 맡겼고, 자체 자동 행동 감사에서 Opus 5.5가 지금까지 시험한 모델 중 가장 좋은 결과를 기록했다고 밝혔습니다. 격리 경계를 넘으려는 경향을 보는 새 평가에서는 Opus 5와 Claude Mythos 5.1보다 우회 시도가 약 85% 적었고, 시도는 모두 심각도가 낮았으며 모델이 스스로 보고했어요.
사이버보안 쪽은 Fable 5.1과 비슷한 안전장치가 적용됩니다. 개발 중 버그를 찾고 고치는 일은 그대로 되지만, 대부분의 사이버보안 작업은 Opus 4.8로 라우팅돼요. 보안 실무자는 수 주 안에 확대될 Cyber Verification Program을 거쳐야 Opus 5.5를 쓸 수 있고, 생물학 연구는 Life Sciences Verification Program을 통해 접근 권한을 신청합니다.
Anthropic은 Opus 5.5가 자신이 평가받고 있다고 의심하는 징후를 자주 보여, 실제 환경에서 어떻게 행동할지 판단하기 어렵다는 한계도 발표문에 적었어요. 안전 훈련 방식은 이전 모델과 크게 다르지 않다고 TechCrunch는 전했습니다.
경쟁 구도와 외부 평가
 OpenAI 로고 — 출처: OpenAI
Anthropic 라인업에서 Opus 5.5는 Fable 5.1 아래 등급이지만, 공개 벤치마크 대부분에서 Fable 5.1보다 높은 점수를 기록했습니다. 경쟁사 쪽에서는 OpenAI GPT-6 Astra가 비교 대상인데, HLE와 GDPval-AA는 Opus 5.5가, 업무 자동화와 과학 터미널 과제는 GPT-6 Astra가 앞서요.
Artificial Analysis 지능 지수에서는 Opus 5.5가 58점으로 Fable 5.1(53점)보다 5점 높게 나왔어요. 반면 Vals AI 종합 지수에서는 66.16%로 60개 모델 중 4위에 올라 Opus 5(67.21%)를 조금 밑돌았고, 법률·의료 코딩·세무 에이전트 과제에서 점수가 떨어졌다고 Digital Applied가 전했습니다.
사용처
Anthropic과 초기 사용 기업이 공개한 사례는 오래 걸리는 코딩·분석 작업에 집중돼 있습니다.
- 68만 줄 규모 코드 마이그레이션을 하루 안에 완료
- 웹앱 전 페이지 로딩 시간 단축 과제 40회 중 39회 성공
- 20만 줄 코드베이스 감사 3시간, Opus 5는 20시간 이상에 토큰 2.5배
- HAProxy를 C에서 Rust로 옮기는 작업 9.5시간, Fable 5.1(12시간)보다 비용 51% 적음
- 분기 보고서 리서치 18건 중 16건 품질 기준 통과, Fable 5.1과 Opus 5는 0건
- 인수합병 재무 모델 63분에 완성, Opus 5는 93분에 오류 포함
Quantium은 Opus 5에서 4일 동안 프롬프트 38개가 필요했던 코딩 작업이 3시간·프롬프트 11개로 줄었다고 밝혔어요. 법률 쪽에서는 LexisNexis와 Thomson Reuters Labs가 인용 정확도 향상을 언급했지만, Vals AI의 법률 과제 결과와는 방향이 다릅니다.
국내에서는 Anthropic이 2026년 6월 17일 서울 오피스를 열었고, 네이버가 엔지니어링 조직 전체에 Claude Code를 도입했으며 LG CNS와 삼성SDS도 Claude를 쓰고 있다고 밝혔습니다. Claude Code를 쓰는 조직은 모델 설정만 바꿔 Opus 5.5를 쓸 수 있어요. 발표 자료에 한국어 성능 수치는 없습니다.
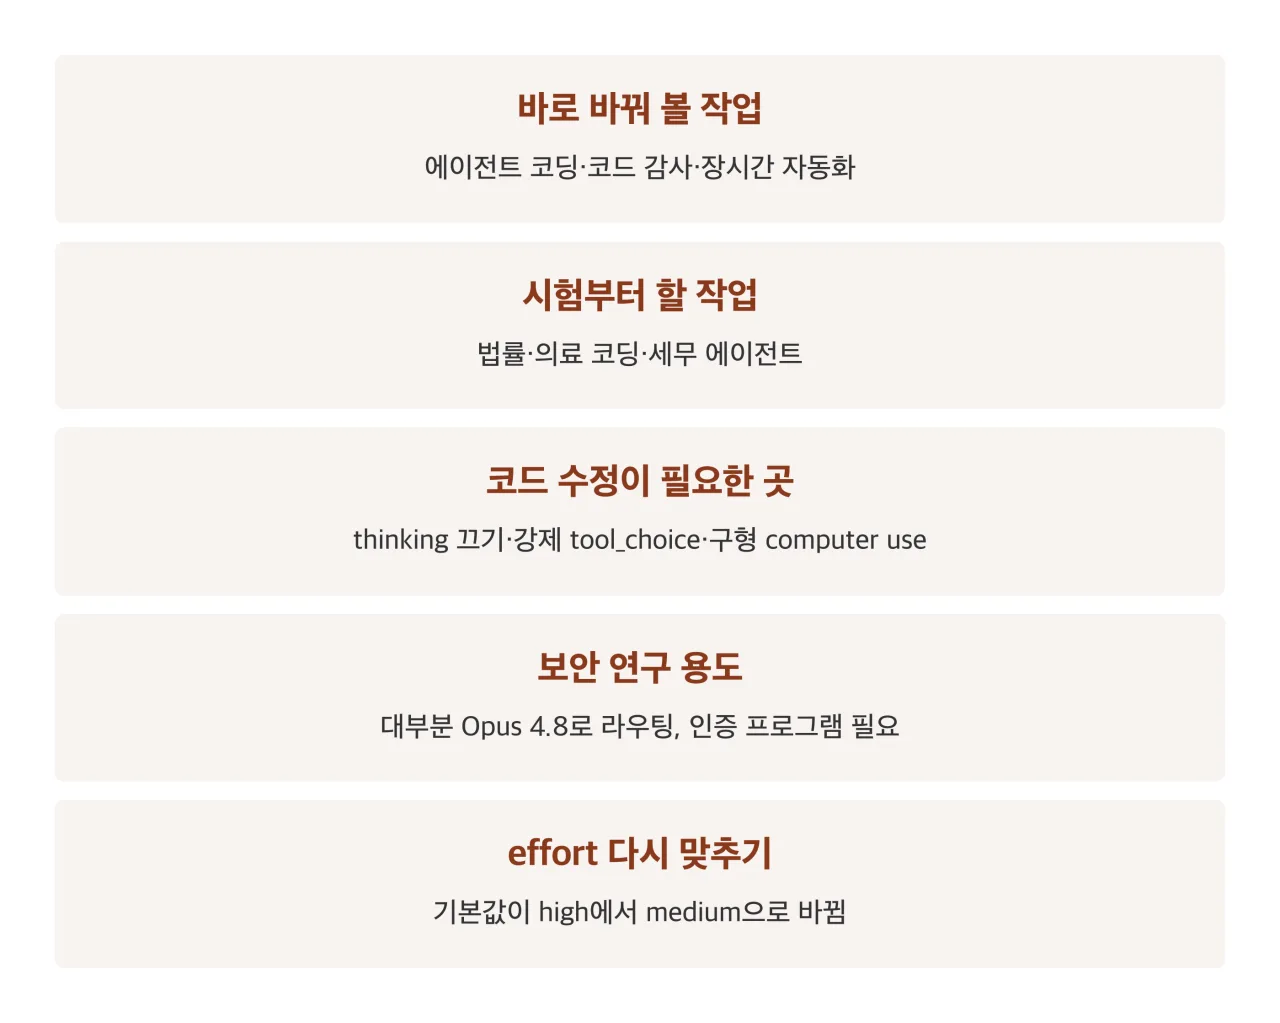 작업별 전환 판단 정리 카드 — 출처: Anthropic·Vals AI 발표 기반 자가 렌더
앞으로 주목할 점
- Sonnet 5.5·Haiku 5.5: Anthropic이 수 주 안에 출시 예고, 같은 효율 개선을 담는다고 설명
- Cyber Verification Program: 3단계 인증으로 확대 예정, 상위 단계는 Claude Mythos 모델 접근 포함
참고 출처
- [Anthropic] Introducing Claude Opus 5.5 (2026-09-22, 성능·요금·안전장치·고객 사례)
- [Claude Platform Docs] What’s new in Claude Opus 5.5 (호환성 변경·기능·제공처·요금)
- [Claude Platform Docs] Migrating to Claude Opus 5.5 (전환 체크리스트)
- [TechCrunch] Anthropic releases Opus 5.5 with lower prices and Fable-level performance (2026-09-22)
- [Artificial Analysis] Claude Opus 5.5 (지능 지수)
- [Digital Applied] Claude Opus 5.5: Pricing, Benchmarks and Breaking Changes (Vals AI 결과 인용)
- [AI타임스] 앤트로픽 클로드 오퍼스 5.5 공개 (2026-09-23, 국내 보도)
- [한국경제TV] 앤트로픽 서울 오피스 개소, 국내 기업 Claude 도입 (2026-06-17)
- 환율: 1달러 ≈ 1,400원 기준 환산