1탄에서 만든 판결문 가명 코퍼스로 Qwen3-4B를 LoRA 파인튜닝(fine-tuning, 미세조정)하고, 1탄과 같은 쟁점 50건의 이유 초안을 다시 생성하게 했습니다. 정답 참조조문을 맞힌 비율은 12~18%로, 근거 없이 쓴 1탄 초안(18%)과 같거나 낮았고 RAG(32%)의 절반 수준이었어요.
대신 학습 데이터의 형식은 그대로 따라 했습니다. 판결요지 문형으로 쓰고, 끝에 근거 조문 표기를 추가하고, 학습 데이터에만 있던 빈 태그까지 출력에 포함했어요.
초간단 RAG (1) — 판결서 익명처리 데이터로 만든 로컬 RAG, 조문 적중 18%→32%
 판결문 파인튜닝 개념 컷 — 출처: 개념 컷 · agy 자가 생성
학습 데이터
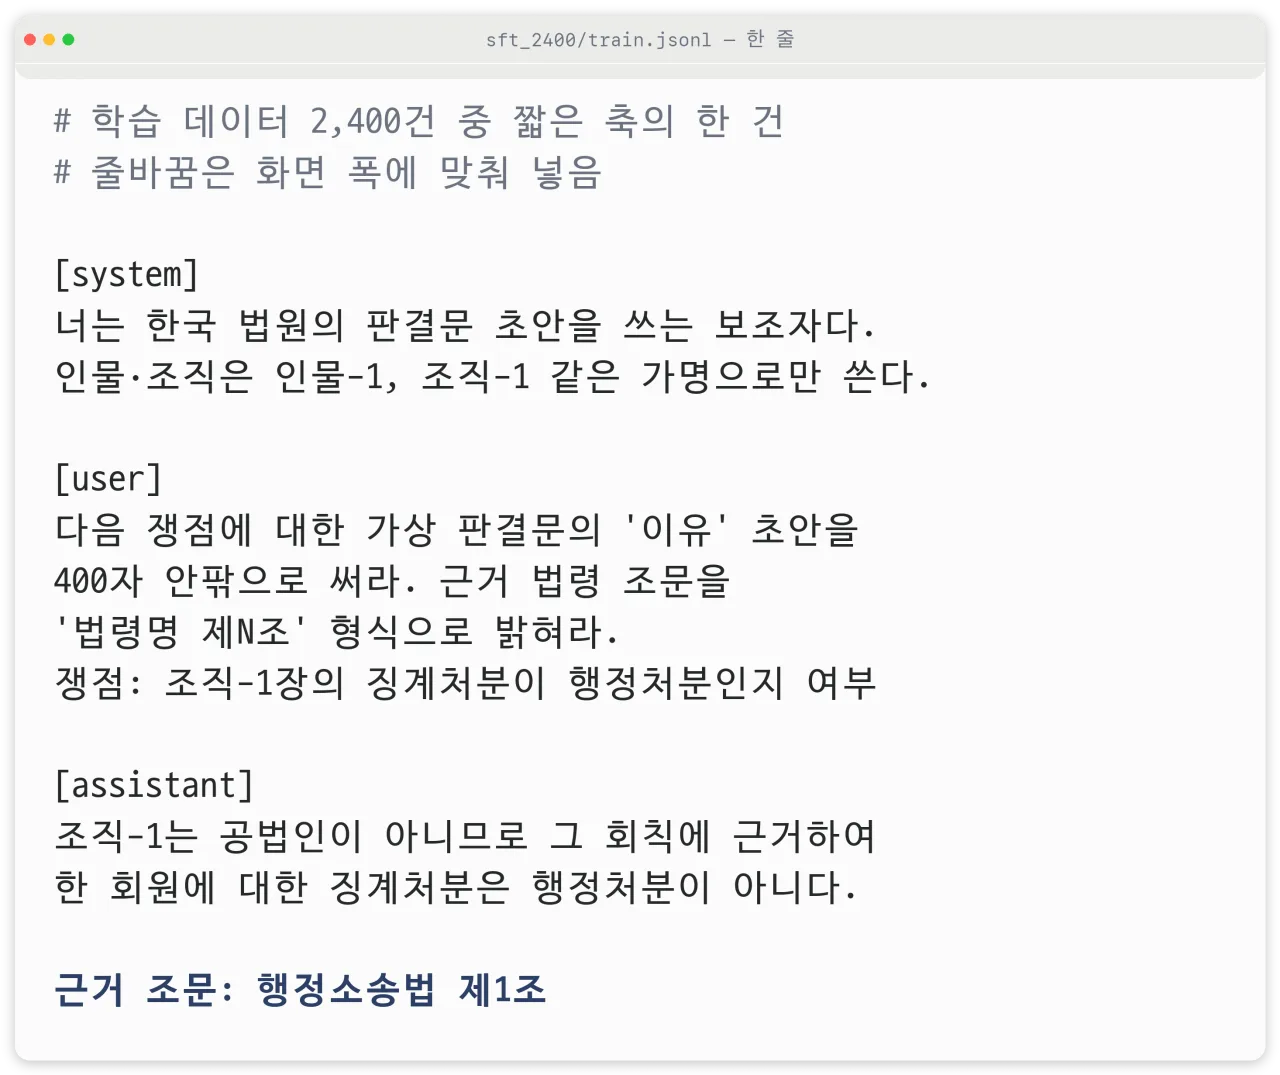 학습 데이터 한 건 — 출처: AI Hub 데이터 기반 학습셋 · 자가 렌더
1탄의 가명 코퍼스 학습셋 16,800건 가운데 판시사항·판결요지·참조조문이 모두 있는 판결은 5,745건이었습니다. 여기서 무작위로 2,400건을 선택해 질문과 정답 한 쌍씩으로 만들었어요.
| 구성 | 내용 |
|---|---|
| 시스템 지시 | 1탄과 같은 문장 |
| 사용자 질문 | 1탄 지시문 + 판시사항 |
| 정답 | 판결요지 앞 900자 + 참조조문 |
질문은 1탄의 근거 없음 조건과 글자 하나까지 동일하게 구성했습니다. 1탄 평가에 쓴 검증셋 대법원 판결 50건은 학습 데이터에도, 학습 중 손실을 재는 검증 데이터 50건에도 포함하지 않았어요.
지시문은 이유 초안 400자를 요구하지만 정답은 판결요지라서, 질문과 정답의 형식이 처음부터 달랐습니다. 정답 길이의 중앙값은 704자였고, 2,400건 모두 근거 조문 표기로 끝나며 그중 359건은 조문을 15개 넘게 나열합니다.
LoRA 학습
LoRA는 Microsoft 연구진이 2021년 발표한 방법으로, 원래 모델의 가중치는 고정하고 층마다 추가한 작은 행렬 두 개만 학습합니다. 논문은 GPT-3 175B 기준으로 학습할 파라미터를 1만분의 1, GPU 메모리를 3분의 1로 줄였다고 밝혔어요.
| 항목 | 값 |
|---|---|
| 학습 파라미터 | 734만 개 (0.182%) |
| 적용 층 | 36층 중 위 16층 |
| rank | 8 |
| 학습률 | 0.0001 |
| 배치 | 1건 × 4번 누적 |
| 스텝 | 2,400 (데이터 1회) |
| 최대 길이 | 1,024토큰 |
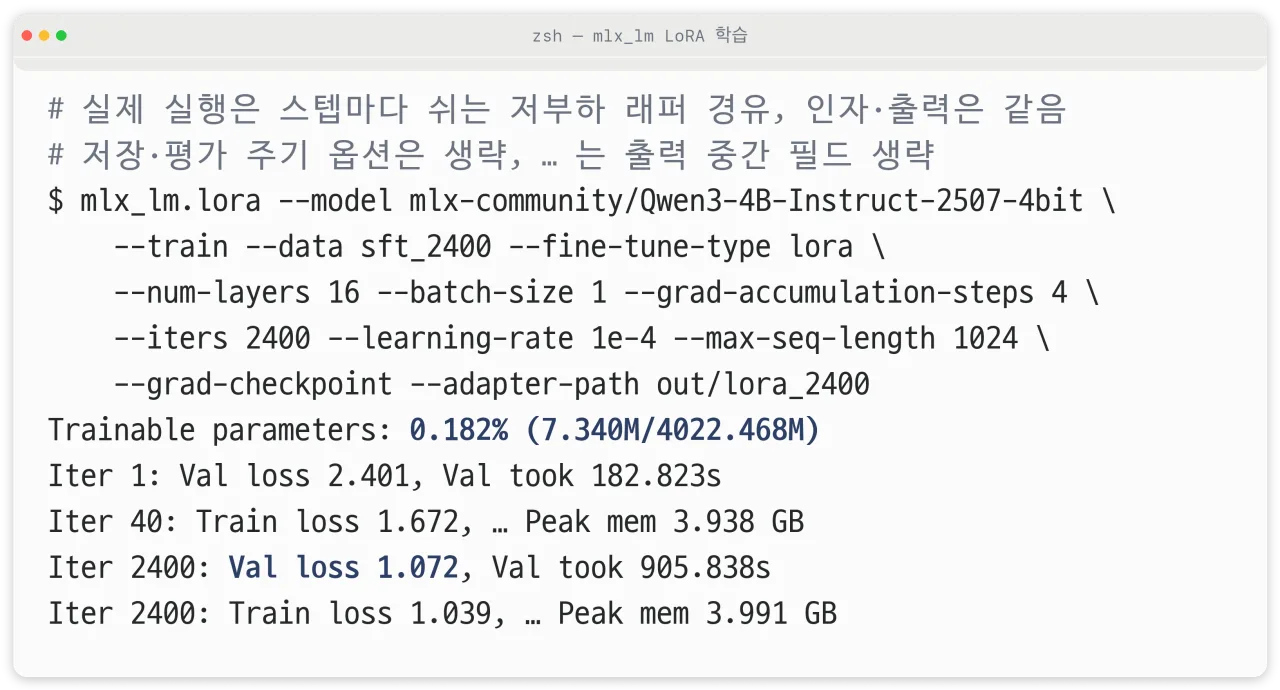 mlx_lm LoRA 학습 실행 — 출처: mlx_lm 실제 출력 · 자가 렌더
1탄과 같은 Apple M3 Pro 36GB에서 MLX로 학습했습니다. 다른 작업을 하면서 실행할 수 있게 스텝마다 계산한 시간만큼 대기하도록 했고, 그 설정으로 1회 학습에 5시간 52분이 걸렸어요.
최대 메모리는 3.99GB, 학습한 토큰은 172만 개였습니다. 결과물인 어댑터 파일은 29.4MB로, 4bit 원본 모델에 적용해 사용합니다.
손실 추이
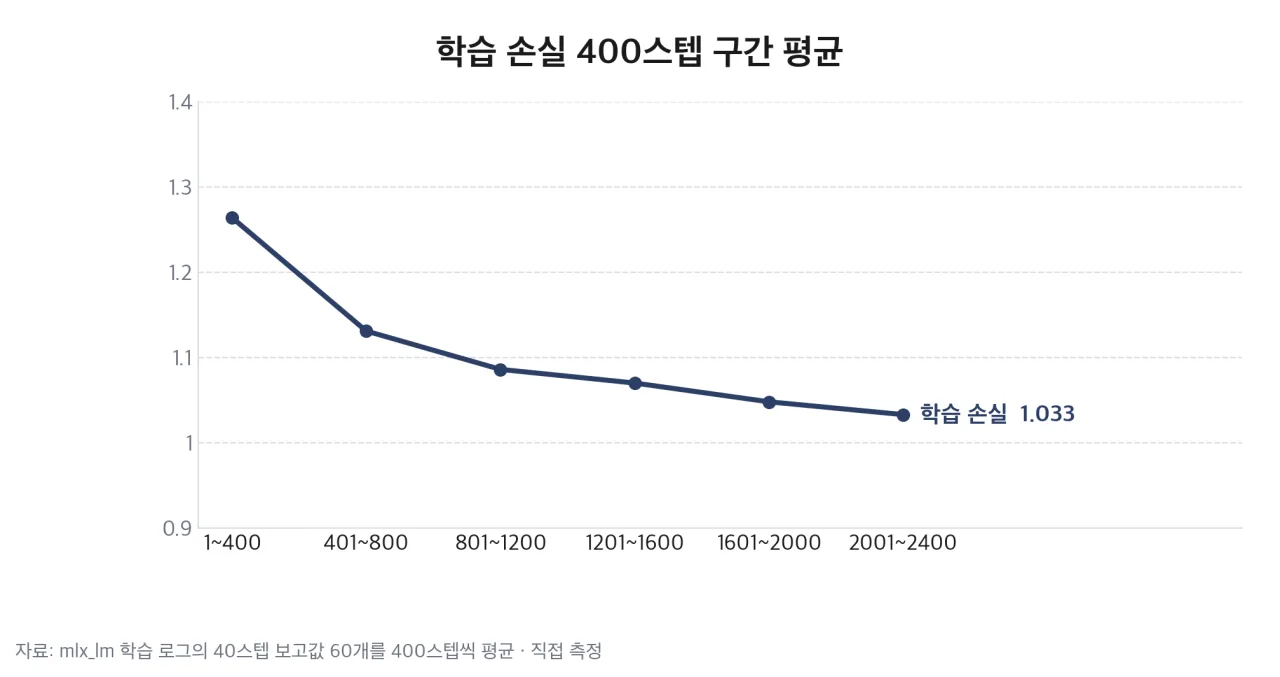 학습 손실 400스텝 구간 평균 — 출처: 직접 측정 · 자가 렌더
검증 손실은 2.401에서 1.072로 감소했습니다. 학습 손실은 첫 400스텝 평균 1.264에서 마지막 400스텝 1.033이 됐고, 하락 폭의 대부분이 첫 400스텝에 집중됐어요.
mlx_lm은 기본값으로 정답뿐 아니라 질문 부분까지 손실에 포함합니다(–mask-prompt 미사용). 2,400건이 같은 지시문을 공유하므로, 손실 하락에는 매번 같은 문장을 맞히게 된 영향이 포함돼 있어요.
같은 50건 다시 쓰기
검증셋 대법원 판결 50건의 판시사항을 1탄과 같은 지시문으로 입력하고, 참고 판결 없이 이유 초안을 쓰게 했습니다. 1탄처럼 무작위성 없이 가장 확률이 높은 토큰을 고르는 greedy 방식이고, 출력 상한은 600토큰이에요.
반복 생성 문제
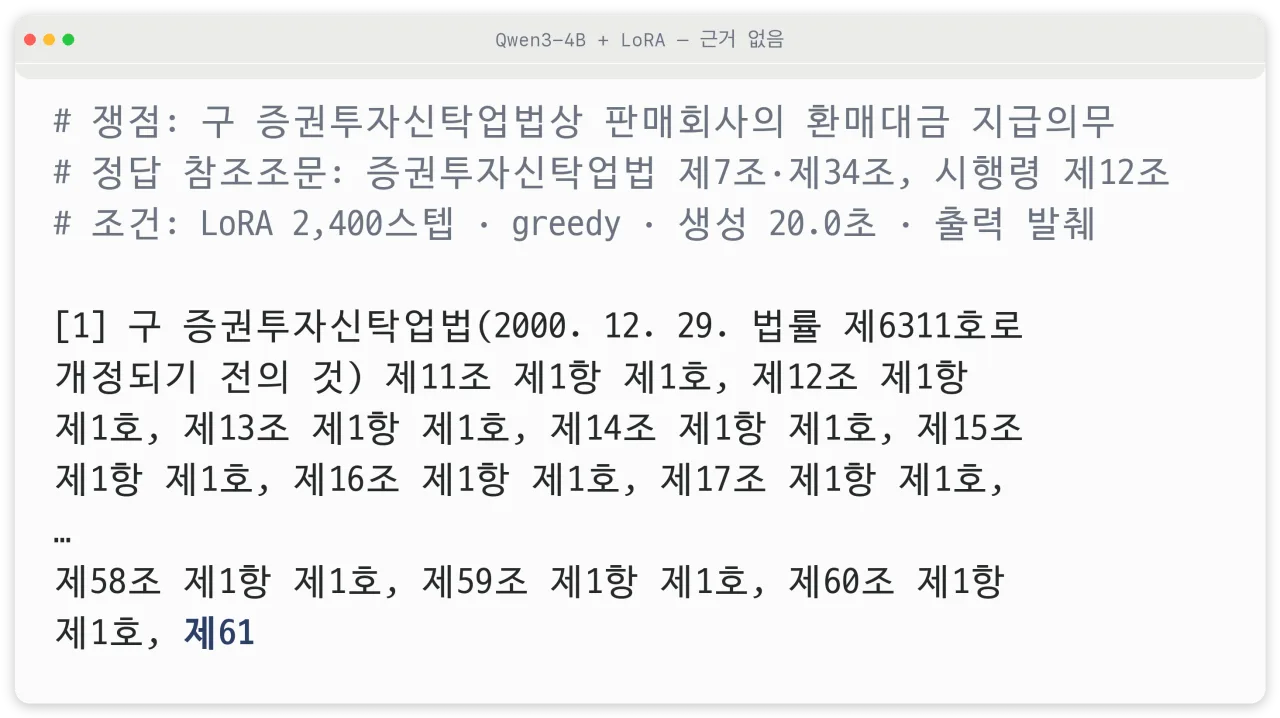 조문 번호를 반복하다 끊긴 출력 — 출처: Qwen3-4B + LoRA 실제 출력 · 자가 렌더
50건 중 49건이 600토큰 상한에 도달했습니다. 대부분 근거 조문 부분에서 「제n조 제1항 제1호,」를 번호만 바꿔 계속 생성하다가 상한에서 끊겼고, 그래서 생성 시간 중앙값이 18.5초로 1탄 근거 없음 조건(5.8초)의 3배가 됐어요.
이 출력은 정답 조문인 제34조가 나열 중간에 포함됐지만 적중으로 세지 않았습니다. 채점은 1탄과 같이 법령명과 조문 번호가 붙어 나온 경우만 셉니다.
학습 중간인 1,200스텝 체크포인트로 같은 쟁점 3건을 실행해도 같은 반복이 나왔습니다.
반복 억제
이미 나온 토큰의 점수를 깎는 repetition penalty를 적용해 같은 50건을 한 번 더 실행했습니다. 2019년 Salesforce의 CTRL 논문이 greedy와 함께 쓰는 값으로 1.2 안팎을 제안한 방식이고, 여기서는 1.1을 최근 64토큰에 적용했어요.
상한 도달은 26건으로 감소했습니다. 끝까지 쓴 24건의 길이 중앙값은 341자로, 지시문의 400자에 가까웠어요.
조문 적중
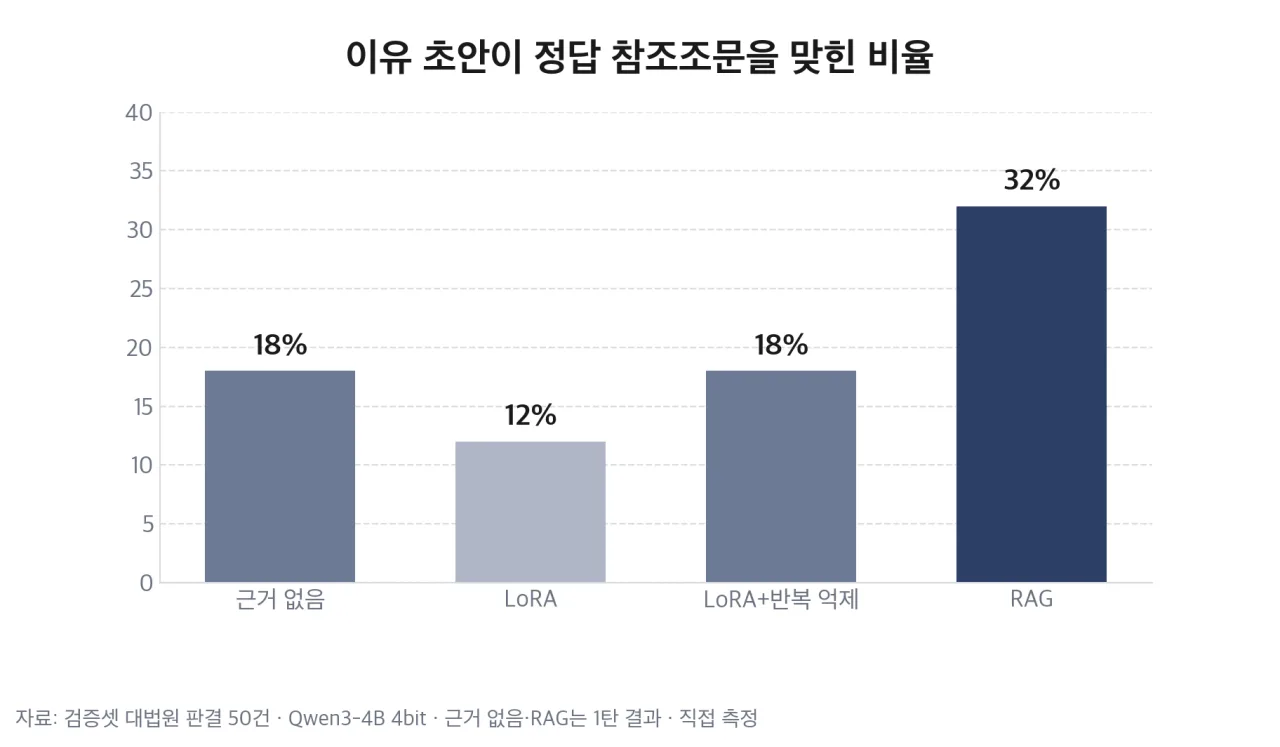 정답 참조조문 적중 비율 — 출처: 직접 측정 · 자가 렌더
| 조건 | 조문 없는 초안 | 생성 시간 |
|---|---|---|
| 근거 없음 | 23건 | 5.8초 |
| RAG | 13건 | 15.0초 |
| LoRA | 31건 | 18.5초 |
| LoRA+반복 억제 | 18건 | 18.3초 |
파인튜닝 모델이 맞힌 쟁점은 6건, 반복을 억제하면 9건이었습니다. 근거 없이 쓴 1탄과 같은 9건이지만 겹치는 쟁점은 6건이고, 반복 억제 쪽이 맞힌 9건 중 6건은 RAG도 맞힌 쟁점이었어요.
법령명 뒤에 (2000. 12. 29. 법률 제6311호로 개정되기 전의 것) 같은 괄호가 끼면 채점에서 빠지는데, 이를 허용해 다시 세도 LoRA 8건, 반복 억제 10건, 근거 없음 9건, RAG 16건으로 순서가 같았습니다.
코퍼스에 없는 사건번호를 인용한 초안은 두 조건 모두 0건이었어요.
틀린 법령의 단정
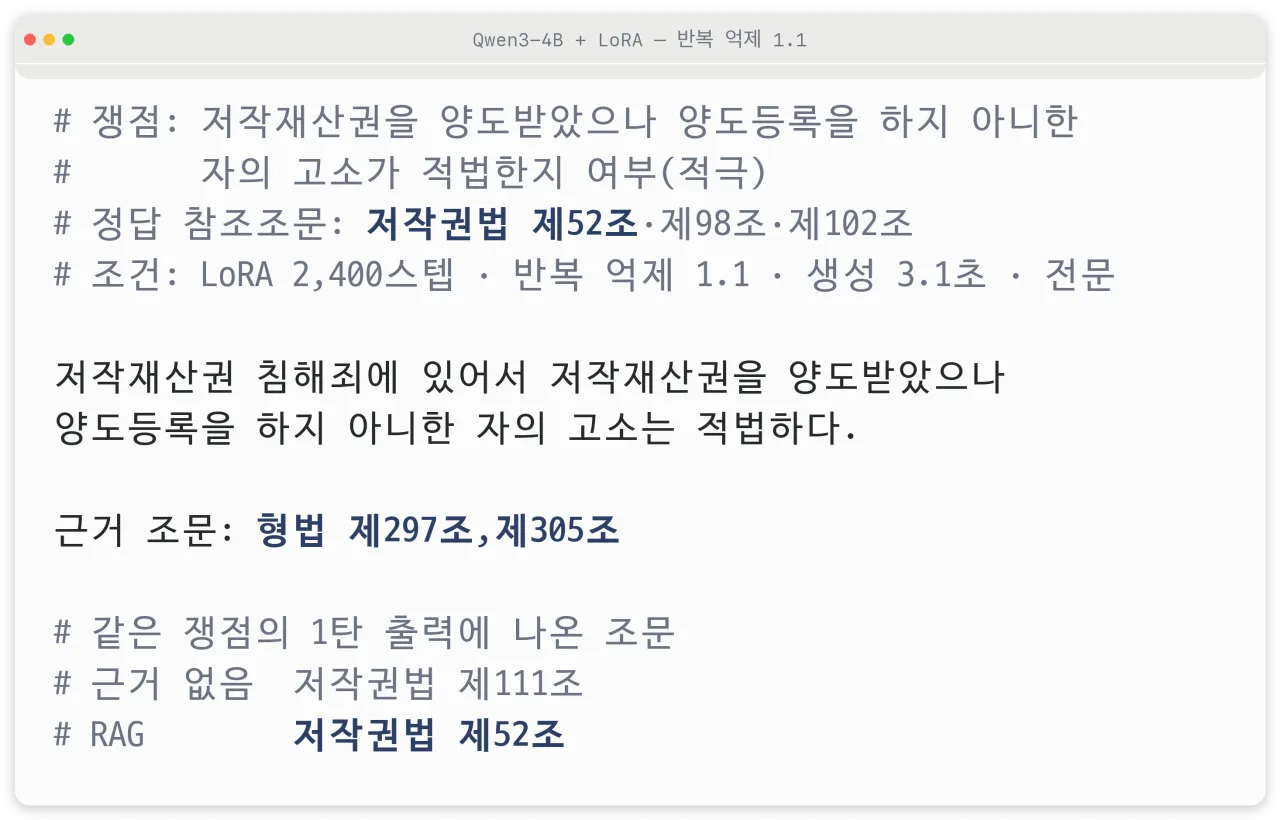 저작권 쟁점에 형법 조문을 단 출력 — 출처: Qwen3-4B + LoRA 실제 출력 · 자가 렌더
판시사항 끝의 (적극)을 「고소는 적법하다」로 풀어 쓴 결론은 정확합니다. 학습 데이터의 판결요지가 판시사항의 결론을 평서문으로 옮긴 형태라, 이 변환은 학습 데이터에서 본 형태 그대로예요.
그런데 근거 조문으로 저작권 사건과 무관한 형법 제297조·제305조를 제시했습니다. 같은 쟁점에서 1탄의 근거 없음 조건은 정답 밖의 저작권법 제111조를, RAG 조건은 정답인 저작권법 제52조를 들었어요.
학습한 형식
| 출력 특징 (50건 중) | LoRA | LoRA+반복 억제 |
|---|---|---|
| 근거 조문 표기 | 22건 | 39건 |
| 쟁점 문장 그대로 포함 | 27건 | 24건 |
| 빈 think 태그 | 50건 | 50건 |
| 600토큰 도달 | 49건 | 26건 |
1탄의 두 조건에서는 근거 조문 표기와 빈 태그가 0건, 쟁점 문장을 그대로 포함한 출력과 600토큰 도달이 RAG 쪽에서 1건씩이었습니다. 쟁점 문장 포함은 판시사항 앞 40자가 출력에 그대로 들어간 경우예요.
출력이 학습 데이터를 그대로 복제한 것은 아니었습니다. 출력을 20자 단위로 나눠 학습 정답 2,400건과 일치하는 비율을 재면 중앙값이 0~1%였어요.
빈 think 태그
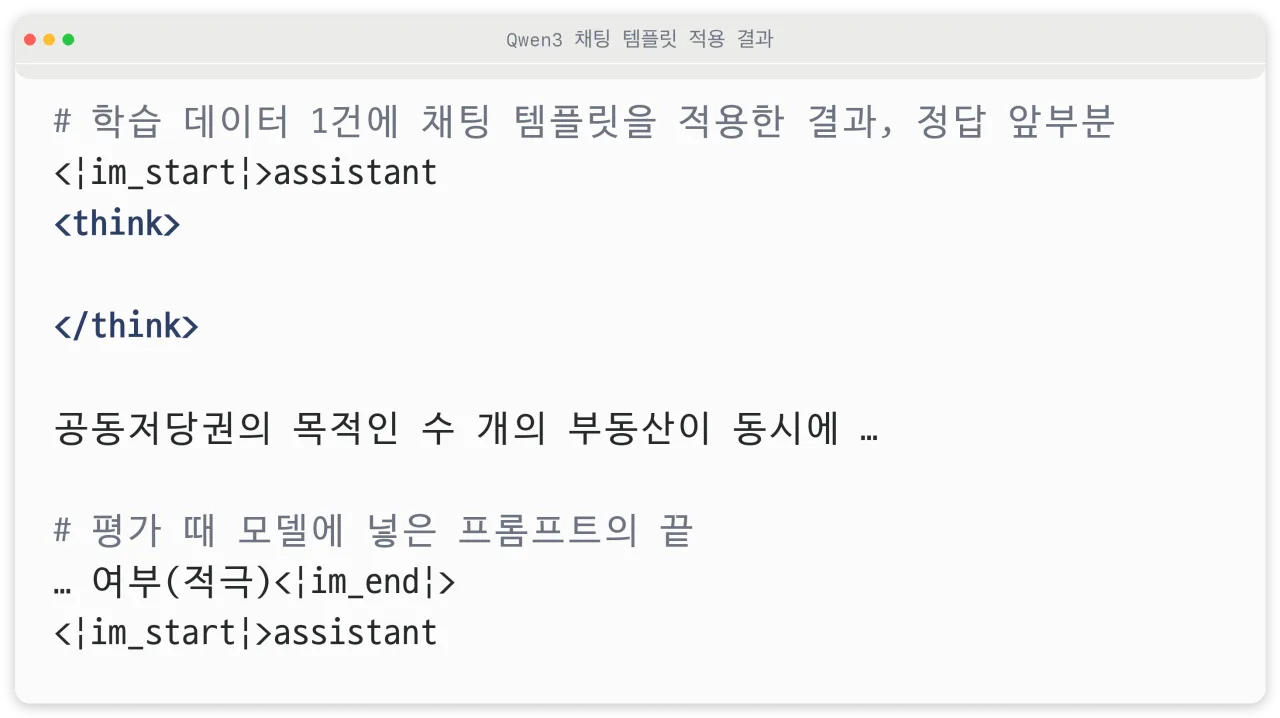 학습 데이터에 들어간 빈 think 태그 — 출처: Qwen3 채팅 템플릿 실제 출력 · 자가 렌더
Qwen3-4B-Instruct-2507은 모델 카드에 「생각 모드 없이 동작하며
학습 데이터를 대화 형식으로 바꾸는 채팅 템플릿이 정답 앞마다 빈 태그를 추가했고, 평가 프롬프트는 assistant 줄에서 끝나 태그가 없습니다. 모델은 2,400건에서 학습한 대로 출력 첫머리에 태그를 직접 쓰게 됐어요.
파인튜닝과 지식 연구
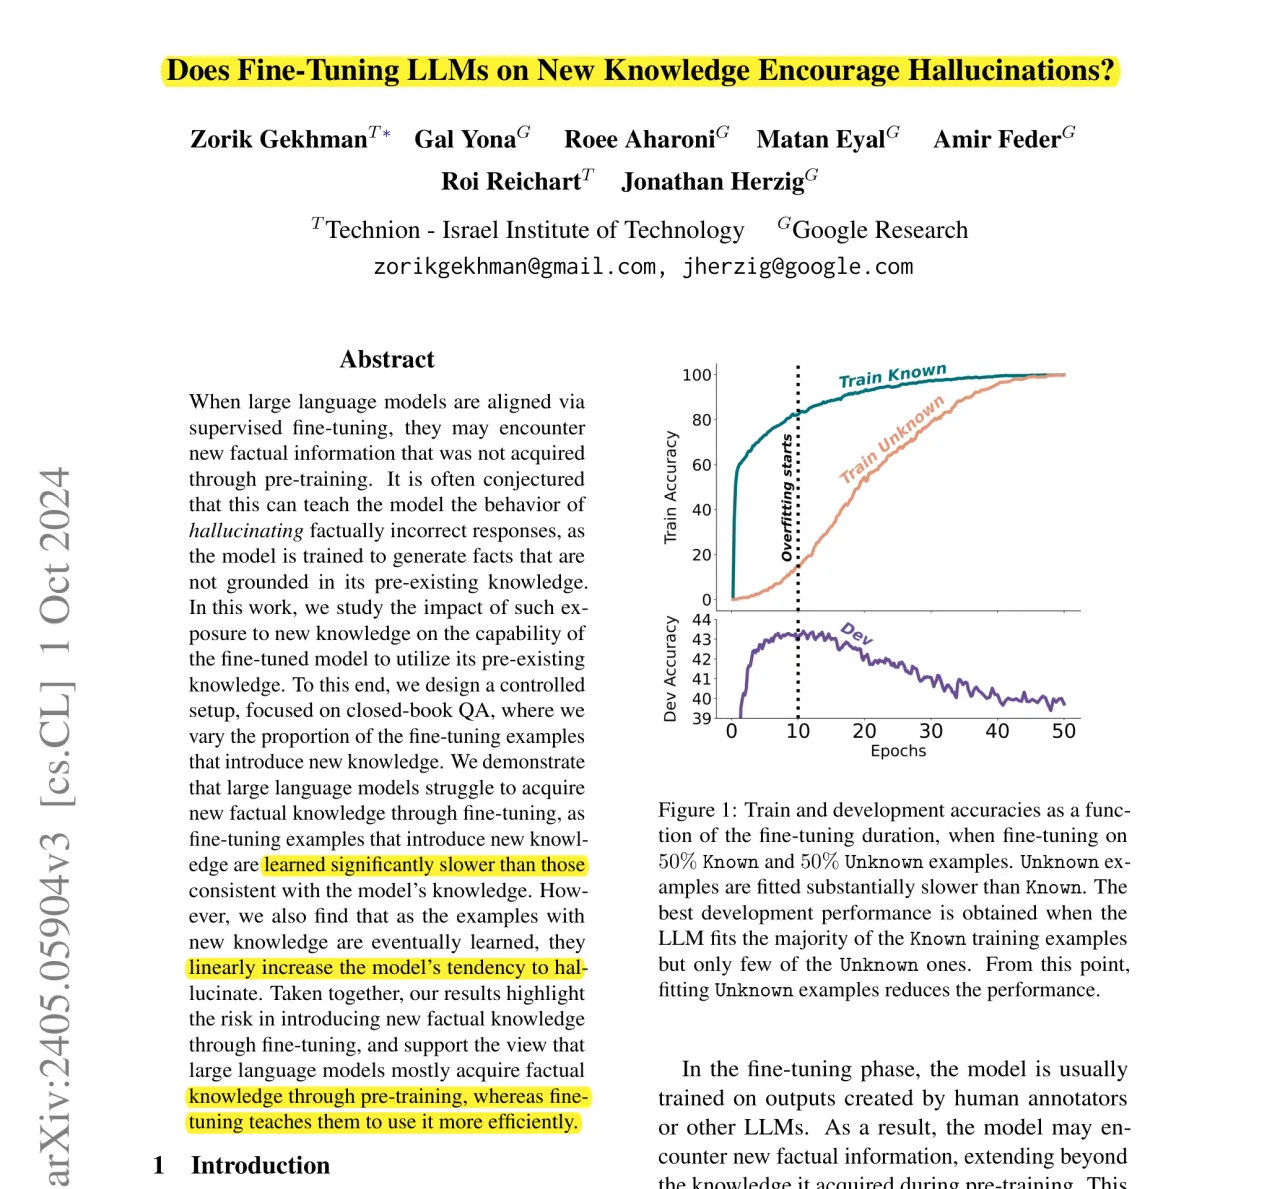 Gekhman 외, 파인튜닝과 새 지식 논문 초록 — 출처: arXiv / Gekhman et al. (CC BY 4.0)
Technion과 Google Research 연구진은 모델이 사전학습에서 모르던 사실을 담은 예시가 아는 사실의 예시보다 훨씬 늦게 학습되고, 결국 학습되면 그만큼 환각(hallucination) 경향이 선형으로 늘어난다고 보고했습니다(EMNLP 2024). 결론은 사실 지식은 주로 사전학습에서 얻고, 파인튜닝은 그 지식을 쓰는 방법을 가르친다는 쪽이에요.
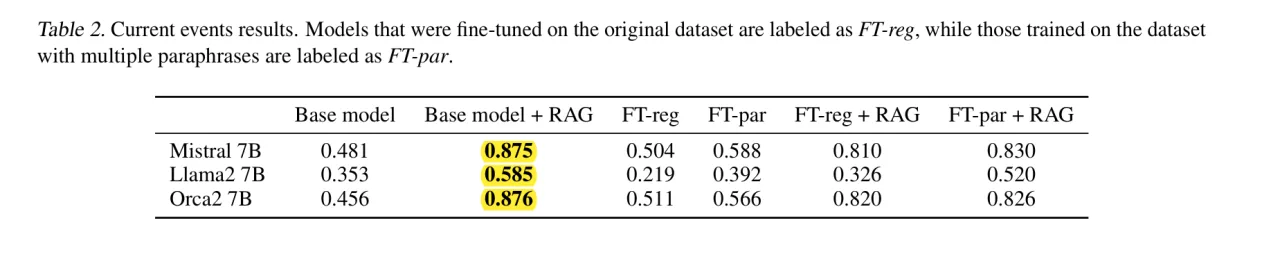 Ovadia 외, 최신 사건 과제 결과 표 — 출처: arXiv / Ovadia et al. (CC BY 4.0)
Microsoft 연구진은 학습 시점 이후의 사건을 묻는 객관식 과제에서 파인튜닝과 RAG를 비교했습니다(EMNLP 2024). Mistral 7B 정답률이 기본 0.481, 파인튜닝 0.504, RAG 0.875였고, 파인튜닝한 모델에 RAG를 추가하면 0.810으로 RAG만 쓴 쪽보다 낮았어요.
이 논문의 파인튜닝은 질문·정답 쌍이 아니라 위키백과 원문을 그대로 더 학습시키는 방식이라 이 글의 구성과 다릅니다. 같은 사실을 여러 표현으로 바꾼 데이터로 학습하면 정답률이 상승한다는 결과도 함께 실렸어요.
1,000건의 질문·정답으로 65B 모델을 튜닝한 Meta의 LIMA 연구(2023)는 지식은 대부분 사전학습에서 얻고 튜닝은 응답 형식을 고르게 한다는 피상적 정렬 가설을 제시했습니다. 판결문 2,400건으로 달라진 것도 판결요지 문형과 근거 조문 표기였어요.
국내에서는 대법원이 2026년 2월 13일 법원 내부 인프라에서 운영하는 재판지원 AI 시범 운영을 시작했습니다. 판례·법령·실무제요 등을 찾아 쟁점을 정리하고 근거 판례와 법령을 함께 보여 주는 구성으로, 외부 공개형 AI 서비스에 의존하지 않아요.
지금 정리
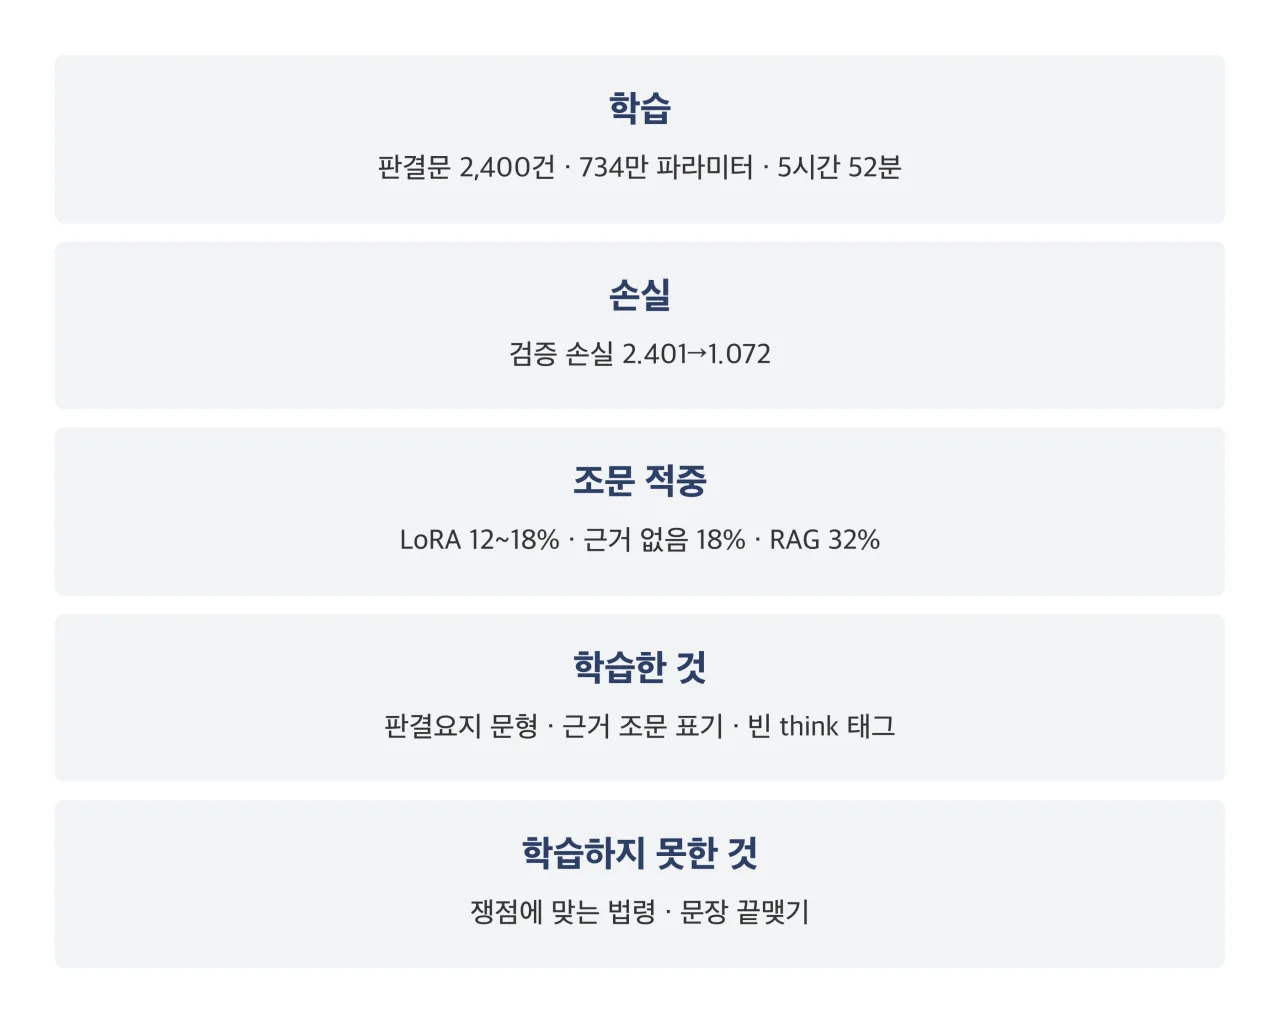 2탄 정리 — 출처: 본문 정리 · 자가 렌더
다음 편
- 3탄: RAG와 LoRA를 합친 구성의 조문 적중·생성 시간 비교
- 학습 조건 변경: 질문 부분을 손실에서 제외하는 –mask-prompt, 지시문과 같은 형식의 정답, 빈 태그를 제거한 템플릿
초간단 RAG (1) — 판결서 익명처리 데이터로 만든 로컬 RAG, 조문 적중 18%→32%
참고 출처
- [arXiv] LoRA: Low-Rank Adaptation of Large Language Models (2106.09685, 학습 파라미터·메모리 절감)
- [arXiv] Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? (2405.05904, 본문 이미지 1점 출처)
- [arXiv] Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs (2312.05934, 본문 이미지 1점 출처)
- [arXiv] LIMA: Less Is More for Alignment (2305.11206, 피상적 정렬 가설)
- [arXiv] CTRL: A Conditional Transformer Language Model for Controllable Generation (1909.05858, repetition penalty)
- [GitHub] mlx-lm LoRA 문서 (–mask-prompt 기본값·채팅 템플릿 적용)
- [Hugging Face] Qwen/Qwen3-4B-Instruct-2507 모델 카드 (생각 모드 미지원)
- [한국경제] 법원, 자체 AI 재판지원 시범운영 (2026-02-13)
- [AI Hub] 판결서 익명처리 데이터
- 이 글은 과학기술정보통신부와 한국지능정보사회진흥원의 사업결과로 구축된 AI Hub 판결서 익명처리 데이터를 활용했습니다.