Anthropic이 2026년 9월 28일 Claude Sonnet 5.5를 공개했습니다. 9월 22일 공개된 Opus 5.5의 절반 요금인데, 업무 문서 작성과 컴퓨터 조작 벤치마크에서는 Opus 5.5와 1~2점 차이였고 터미널 작업에서는 오히려 점수가 높았어요.
요금은 Sonnet 5와 같고 출력 속도는 30% 이상 빨라졌습니다. 같은 일을 더 적은 토큰으로 처리해서 작업당 비용은 최대 30% 낮다는 것이 Anthropic의 설명이에요.
 Claude Sonnet 5.5 발표 키 아트 — 출처: Anthropic
출시 내용
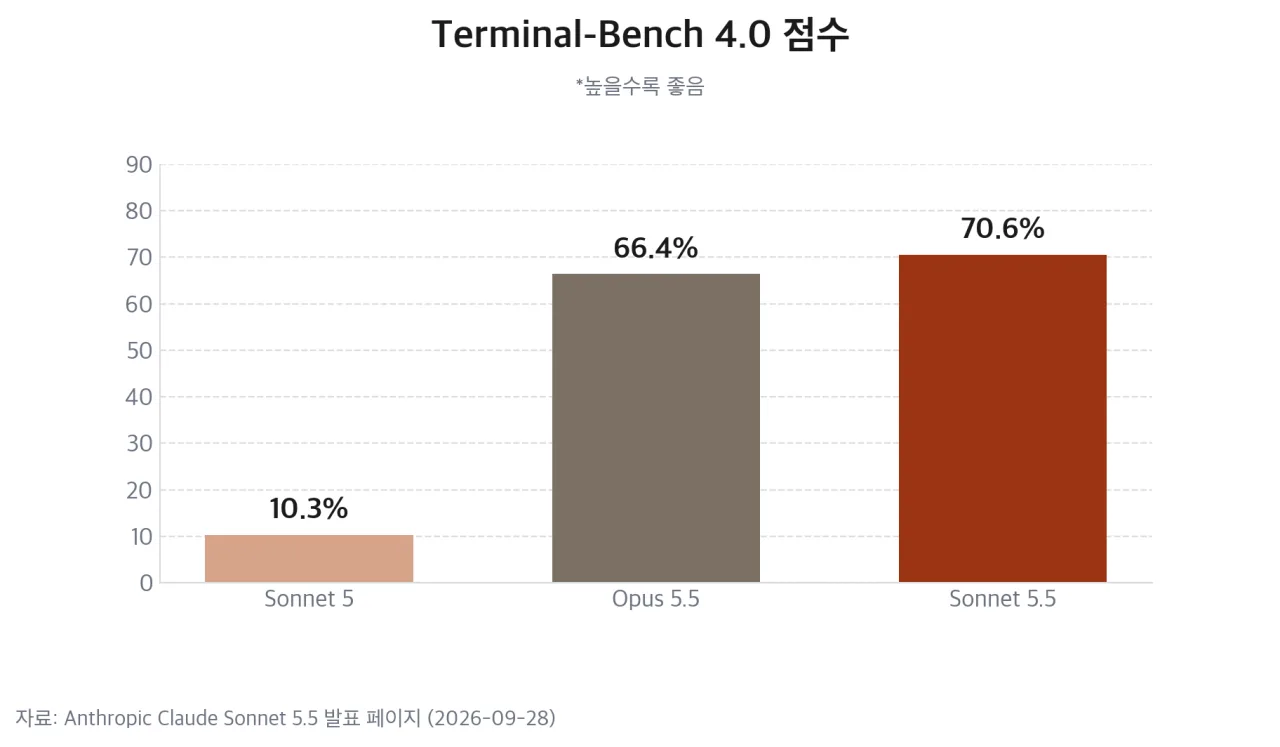 Terminal-Bench 4.0 점수 비교 차트 — 출처: Anthropic 발표 기반 자가 렌더
Sonnet 5.5는 Claude 5.5 계열의 두 번째 모델로, Opus 5.5보다 빠르고 저렴한 모델로 제공됩니다. Claude 앱과 Claude API, Amazon Web Services·Google Cloud·Microsoft Azure에서 바로 쓸 수 있어요.
- API 모델 ID: claude-sonnet-5-5
- 컨텍스트 윈도(context window, 한 번에 넣을 수 있는 입력 길이) 100만 토큰, 최대 출력 12만 8,000토큰
- 출력 속도 Sonnet 5 대비 30% 이상 향상
- 학습 데이터 기준 시점 2026년 6월
- 기본 추론 강도(effort) high, 모델이 추론량을 스스로 정하는 adaptive thinking 지원
가장 크게 상승한 점수는 터미널 작업 벤치마크 Terminal-Bench 4.0입니다. Sonnet 5는 10.3%였는데 Sonnet 5.5는 70.6%로, Opus 5.5의 66.4%보다 4.2%포인트 높았어요.
벤치마크
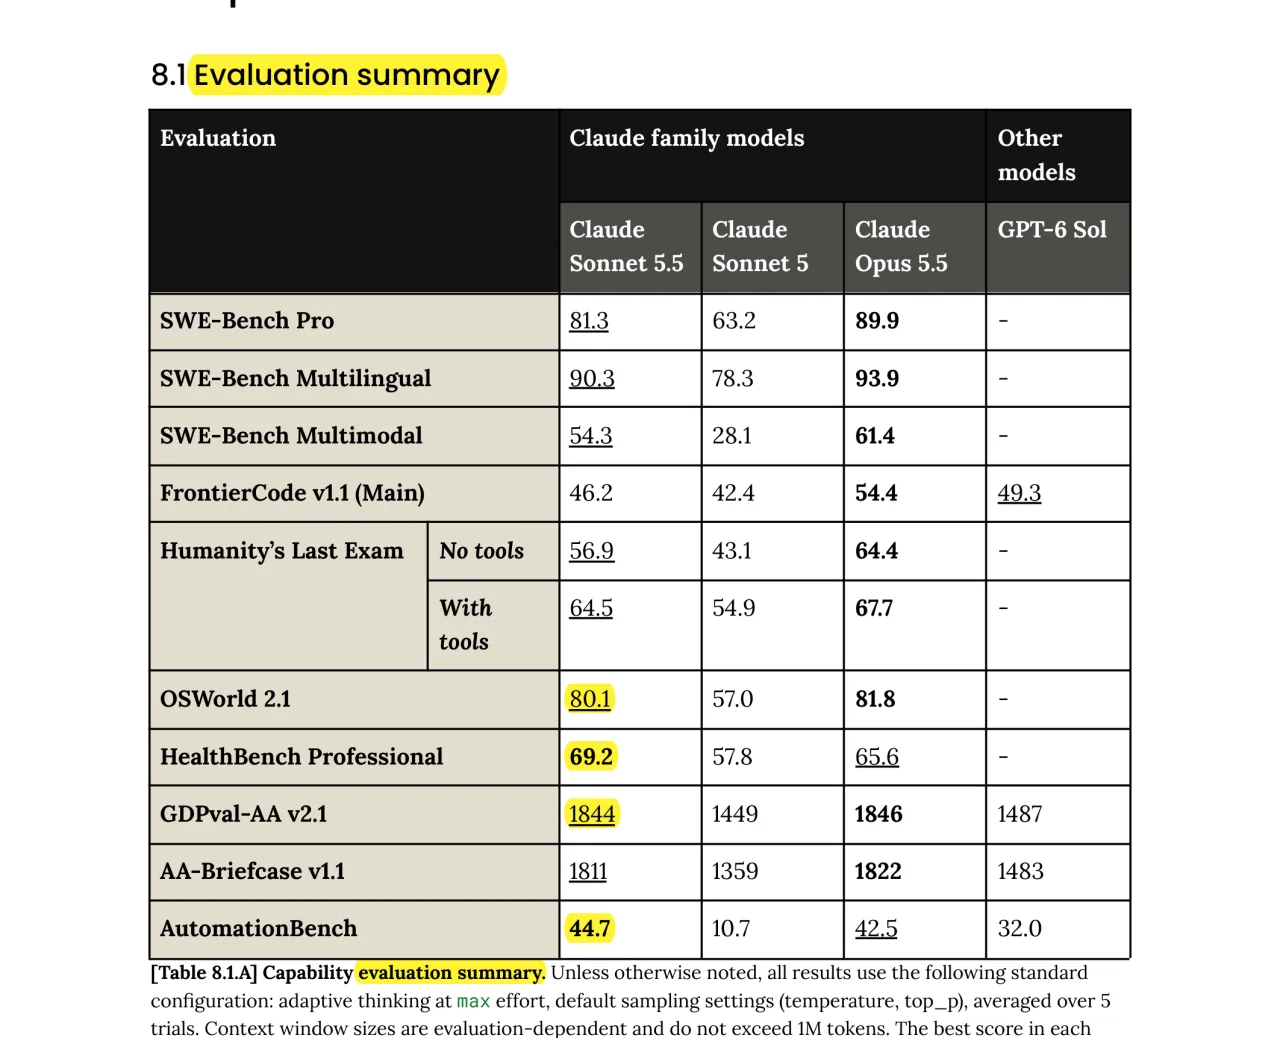 Claude Sonnet 5.5 시스템 카드 평가 요약표 — 출처: Anthropic Claude Sonnet 5.5 System Card
시스템 카드 평가 요약표에서 Sonnet 5.5는 Opus 5.5와 거의 같은 항목과 점수가 낮은 항목으로 구분됩니다. 모든 결과는 최대 추론 강도로 5회 평균한 값이에요.
[Opus 5.5와 1~2점 차이] 업무 산출물 평가 GDPval-AA v2.1 1,844 대 1,846, 컴퓨터 조작 OSWorld 2.1 80.1% 대 81.8%, 문서 작업 AA-Briefcase v1.1 1,811 대 1,822
[Opus 5.5보다 높음] Terminal-Bench 4.0 70.6% 대 66.4%, 업무 자동화 AutomationBench 44.7% 대 42.5%, 의료 전문가 질문 HealthBench Professional 69.2% 대 65.6%
[Opus 5.5보다 낮음] 코딩 SWE-Bench Pro 81.3% 대 89.9%, FrontierCode v1.1 46.2% 대 54.4%, 도구 없는 Humanity’s Last Exam 56.9% 대 64.4%
GPT-6 Sol과 비교하면 GDPval-AA는 1,844 대 1,487, AutomationBench는 44.7% 대 32.0%로 Sonnet 5.5가 높았고, FrontierCode는 46.2% 대 49.3%로 GPT-6 Sol의 점수가 높았어요.
헤지펀드 Balyasny Asset Management는 답변 하나에 쓰는 토큰이 Sonnet 5의 49만 7,000개에서 12만 1,000개로 줄었다고 했고, Box는 2.4배 빨라지고 총 토큰이 12% 줄었다고 밝혔어요. Zendesk는 상담 티켓 처리가 20% 빨라졌다고 했습니다.
요금
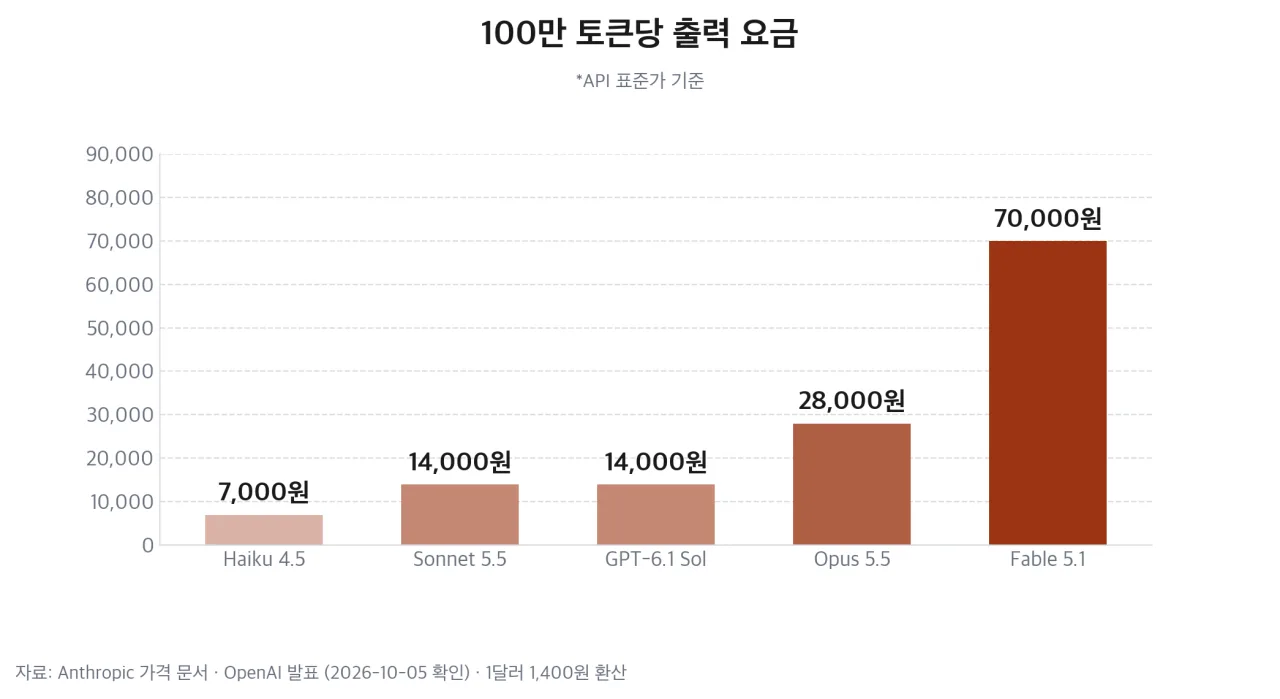 모델별 100만 토큰당 출력 요금 차트 — 출처: Anthropic 가격 문서·OpenAI 발표 기반 자가 렌더
API 표준 요금은 100만 토큰당 입력 2,800원(2달러), 출력 14,000원(10달러)입니다. Opus 5.5의 입력 5,600원(4달러)·출력 28,000원(20달러)의 절반이고, 9월 30일 나온 GPT-6.1 Sol과 같은 가격대예요.
| 항목 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 입력 (원) | 2,800 | 5,600 |
| 출력 (원) | 14,000 | 28,000 |
| 캐시 읽기 (원) | 280 | 280 |
| 배치 입력·출력 (원) | 1,400·7,000 | 2,800·14,000 |
캐시 읽기만은 두 모델이 280원(0.20달러)으로 같습니다. Opus 5.5는 캐시 읽기에 입력가의 5%, Sonnet 5.5는 10%를 부과하기 때문이에요. 같은 긴 문서를 반복해서 읽게 하는 에이전트 작업이라면 두 모델의 요금 차이는 출력과 새 입력에서만 생깁니다.
Sonnet 5의 2달러·10달러는 원래 2026년 8월 31일까지의 출시 할인가였고 9월 1일부터 3달러·15달러로 오를 예정이었는데, Anthropic은 인상을 철회하고 이 가격을 표준가로 확정했습니다. Sonnet 5.5는 그 가격을 그대로 적용했어요.
Opus 5.5와의 선택 기준
 Anthropic 로고 — 출처: Anthropic
| 작업 | 점수 격차 | 고를 모델 |
|---|---|---|
| 보고서·문서 작성 | 1~11점 | Sonnet 5.5 |
| 컴퓨터·브라우저 조작 | 1.7%포인트 | Sonnet 5.5 |
| 터미널·업무 자동화 | Sonnet이 높음 | Sonnet 5.5 |
| 대규모 코드 수정 | 8.6%포인트 | Opus 5.5 |
| 이미지가 섞인 코딩 | 7.1%포인트 | Opus 5.5 |
| 도구 없는 고난도 추론 | 7.5%포인트 | Opus 5.5 |
Anthropic 개발 문서는 대부분의 작업에 Opus 5.5를 먼저 쓰라고 권하고 Sonnet 5.5를 속도와 성능의 균형 모델로 분류합니다. 점수만 보면 대규모 코드 작업 말고는 Sonnet 5.5로 바꿔도 결과 차이가 작고, 요금은 절반이에요.
국내 이용
API 요금은 달러로 청구돼 원화 부담은 환율에 따라 달라집니다. 100만 토큰은 Anthropic 문서 기준 약 250만 문자 분량이라, 개인이 대화형으로 쓰는 범위에서는 API보다 Claude 앱 구독 요금제가 먼저 고려 대상이에요.
시스템 카드는 한국어를 포함한 7개 언어로 유해 요청 거절률을 평가했고, 42개 언어 평균 정확도 GMMLU는 92.1%로 Sonnet 5의 89.2%보다 높았습니다. 다만 한국어만 별도로 산출한 점수는 공개하지 않았어요.
앞으로 주목할 점
- Claude 앱 요금제별 기본 모델이 Sonnet 5.5로 바뀌는지와 사용량 한도 변화
- 2026년 10월 15일 이후로 예정된 Haiku 4.5 은퇴 시점과 후속 Haiku 모델 발표 여부
- GPT-6.1 Sol과 같은 가격대에서 독립 벤치마크(Artificial Analysis 등) 결과