독일 AI 기업 Aleph Alpha가 2026년 10월 3일 언어 모델 Kolibri를 Hugging Face에 공개했습니다. 전체 파라미터 781억 개 가운데 토큰마다 34억 6,000만 개만 쓰는 MoE(Mixture of Experts, 전문가 혼합) 모델이고, 누구나 상업적으로 쓸 수 있는 Apache 2.0 라이선스로 공개했어요.
Aleph Alpha는 Kolibri를 독일에서 만들고 독일·핀란드 인프라에서 학습한 소버린(sovereign, 주권) 모델이라고 소개했습니다. 정부가 정예팀을 선정해 수천억 파라미터 모델을 개발하는 한국 독자 AI 파운데이션 모델 사업과는 다른 방향이에요.
 Kolibri 발표 배너 — 출처: Aleph Alpha
공개 내용
 Kolibri 사전학습 데이터 구성 차트 — 출처: Aleph Alpha 발표 기반 자가 렌더
Kolibri는 영어와 독일어 두 언어를 다루는 모델로, 공공행정·제조·항공우주처럼 규제가 강한 분야를 겨냥합니다. 6월 11일 사전학습을 마친 전작 Kolibri Origin(전체 306억 개)에 이어 석 달 만에 공개된 후속작이에요.
| 항목 | 값 |
|---|---|
| 전체 파라미터 | 78.1B |
| 토큰당 활성 파라미터 | 3.46B |
| 전문가 수 | 384개 중 6개 사용 |
| 컨텍스트 | 256K 학습, 최대 100만 토큰 |
| 라이선스 | Apache 2.0 |
| 배포 | Hugging Face FP8 가중치 |
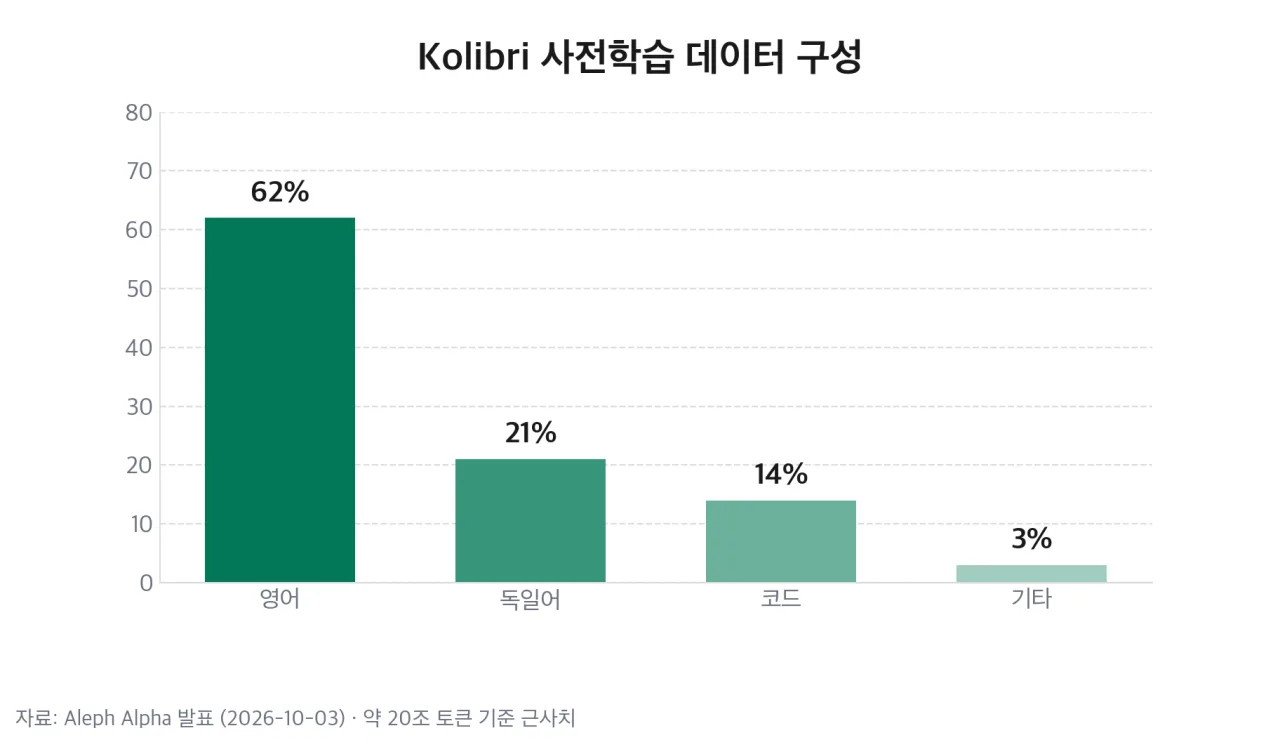
학습에는 NVIDIA B200 768장이 21일 동안 쓰였고, 사전학습 토큰은 약 20조 개입니다. 원시 데이터 200조 토큰 이상을 선별해 구성한 양이에요.
독일어는 사전학습 토큰의 21.3%, 약 4조 3,000억 토큰입니다. Aleph Alpha는 기계 번역에 의존하면 결과가 나빠진다며 독일어 문서를 직접 수집·재작성했고, 번역 데이터 비중은 6%로 제한했다고 밝혔어요.
성능
 AA-Omniscience 비환각률 비교 차트 — 출처: Aleph Alpha 발표 기반 자가 렌더
Aleph Alpha가 비교 상대로 선정한 모델은 비슷한 크기의 오픈웨이트 모델입니다. 활성 파라미터가 약 4배인 NVIDIA Nemotron 3 Super(활성 12B)와 Alibaba Qwen3.6-35B, Mistral Small 4예요.
[앞선 항목] 수학 AIME 2025 96.9%(Nemotron 3 Super 91.7%), 과학 추론 GPQA Diamond 84.3%(Qwen3.6 83.4%)
[점수가 낮은 항목] 코딩 HumanEval+ 92.7%(Nemotron 3 Super 94.7%), 긴 문서 LongBench Pro 64.5%(Qwen3.6 70.8%), 도구 호출 BFCL v4 61.4%(Qwen3.6 67.2%)
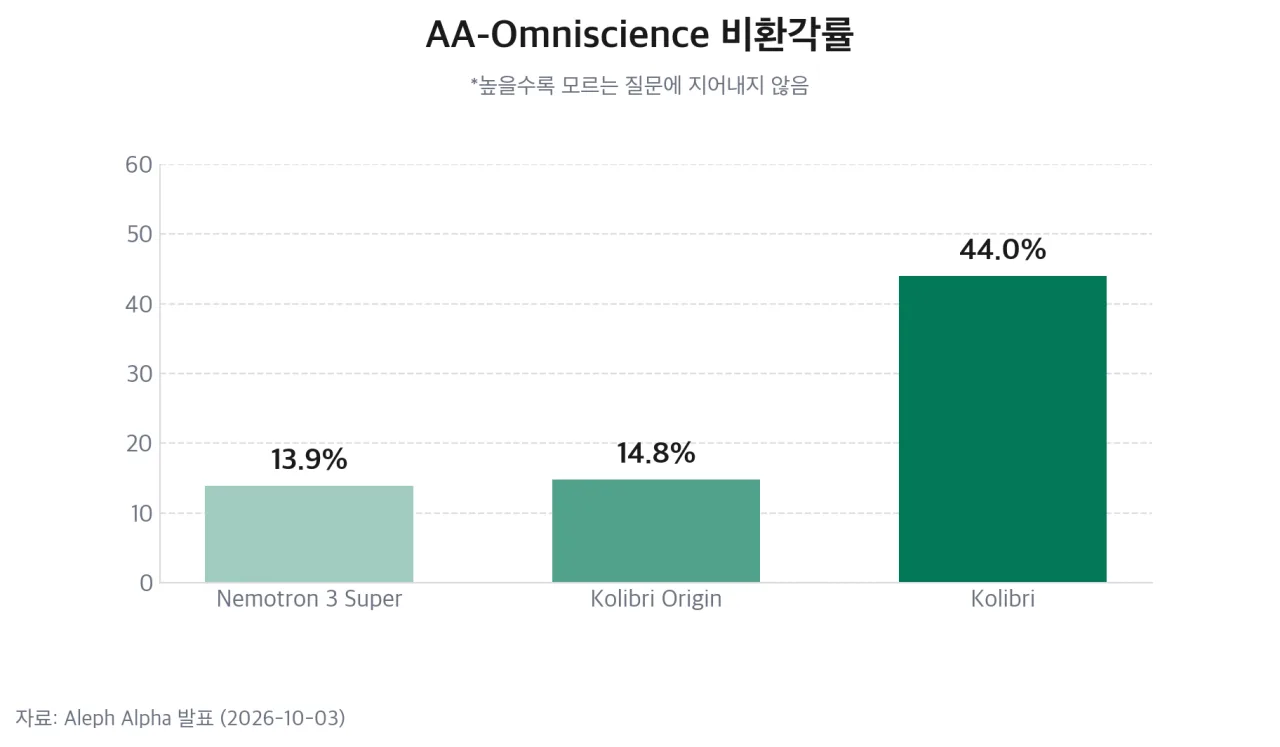
Aleph Alpha가 가장 강조한 숫자는 환각(hallucination) 억제입니다. 모르는 질문에 답을 지어내지 않는 비율인 AA-Omniscience 비환각률이 44.0%로, Kolibri Origin 14.8%와 Nemotron 3 Super 13.9%의 약 3배였어요.
벤치마크는 모두 Aleph Alpha가 직접 측정한 값이고 독립 기관 검증은 아직 나오지 않았습니다.
소버린 AI의 정의
 자국 인프라에서 학습한 오픈웨이트 모델 개념 컷 — 출처: 개념 컷 · agy 자가 생성
[만드는 과정] 데이터 수집부터 학습·평가까지 전 과정을 자사가 관리하고, EU AI법(AI Act)·GDPR·저작권 기준에 맞춰 설계
[제공 방식] 가중치를 공개해 고객이 자기 서버에 설치하고, 외국 기업의 통제 없이 운영
외국의 통제 없이, 전체 파이프라인을 우리가 소유한다 (Aleph Alpha, 2026.10.3)
활성 파라미터가 3.46B라 같은 품질을 더 적은 GPU로 서빙할 수 있고, 그래야 공공기관과 제조사가 직접 설치해 운영하기 쉽다는 설명이에요.
한국 독자 AI 모델과 비교
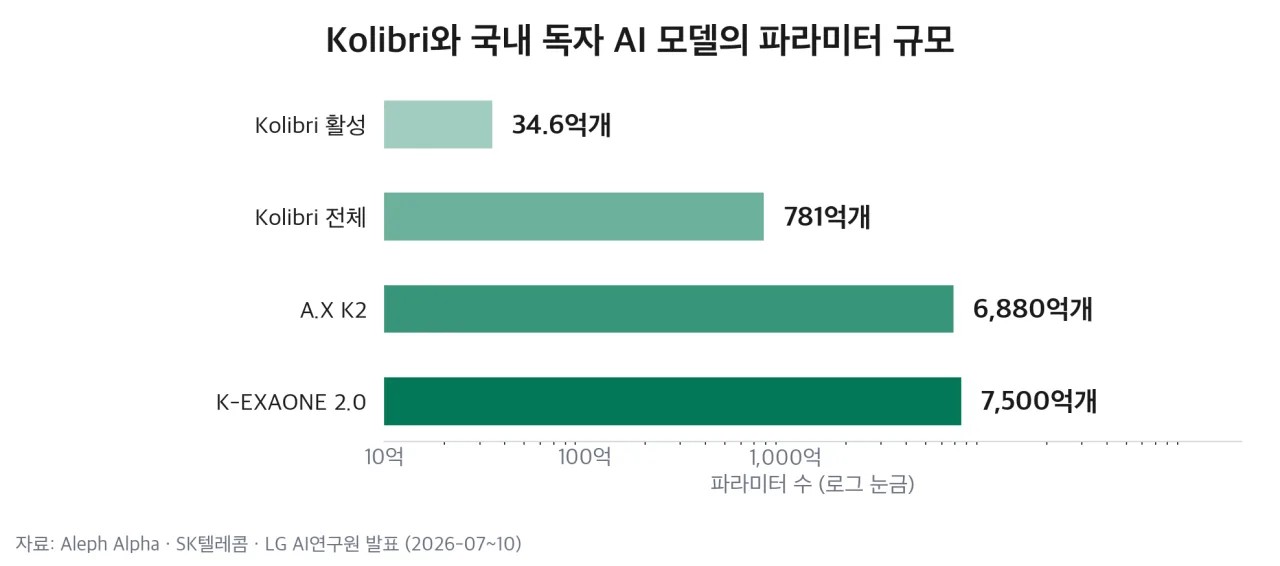 Kolibri와 국내 독자 AI 모델의 파라미터 규모 비교 차트 — 출처: 각 사 발표 기반 자가 렌더
과학기술정보통신부는 2026년 8월 19일 독자 AI 파운데이션 모델 프로젝트 2차 단계평가에서 SK텔레콤(70.6점)·업스테이지(69.9점)·LG AI연구원(69.0점)을 다음 단계 대상으로 선정했고, 세 팀에 6개월간 GPU 임차비 약 1,200억 원을 지원합니다. 모티프테크놀로지스는 탈락했어요.
| 항목 | Kolibri | 국내 2차 모델 |
|---|---|---|
| 개발 방식 | 기업 단독 | 정부 지원 정예팀 |
| 전체 파라미터 | 78.1B | 688B·750B |
| 학습 언어 | 영어·독일어 | 한국어 중심 다국어 |
| 공개 방식 | Apache 2.0 | Hugging Face 공개 |
SK텔레콤 A.X K2는 6,880억 개, LG AI연구원 K-EXAONE 2.0은 7,500억 개로 Kolibri 전체 파라미터의 약 9~10배입니다. K-EXAONE 2.0은 Kolibri처럼 Apache 2.0으로 라이선스를 바꿔 상업적 이용을 허용했고, 업스테이지 Solar Open 2는 최대 100만 토큰 문맥을 지원해요.
국내 모델은 국제 벤치마크 순위에서 미국·중국 모델과 경쟁하는 규모 경쟁에 가깝고, Kolibri는 특정 언어와 규제 산업에 맞춘 작은 모델로 설치 비용을 낮추는 쪽입니다.
국내에서 쓸 때
Kolibri는 한국어를 학습 대상 언어에 포함하지 않았습니다. 영어·독일어 문서 업무나 연구용 비교 모델로는 쓸 수 있지만, 한국어 서비스에 그대로 쓰기는 어려워요.
가중치는 FP8 형식이라 781억 파라미터 기준 약 78GB입니다(1파라미터 1바이트 계산). Aleph Alpha는 vLLM 기반 전용 패키지 aleph-alpha-inference로 서빙하도록 안내했어요.
라이선스가 Apache 2.0이라 국내 기업도 상업 서비스에 쓰거나 수정해 배포할 수 있습니다. 한국어 추가 학습의 초기 모델로 활용할 수 있는 구조지만, 독일어에 맞춘 토크나이저(tokenizer, 문장을 토큰으로 자르는 규칙)가 한국어에서 효율이 떨어질 수 있는 점은 변수예요.
앞으로 주목할 점
- Artificial Analysis 등 독립 기관의 Kolibri 벤치마크 결과
- 독일 연방·주 정부 기관의 실제 도입 사례 발표
- 과학기술정보통신부의 독자 AI 3차 단계 일정과 새 지원 체계
- 국내 정예팀이 Kolibri처럼 작은 경량 모델을 함께 공개하는지
참고 출처
- [Aleph Alpha] Kolibri Has Landed: A Sovereign Open-Weight Model (2026-10-03)
- [Hugging Face] Aleph-Alpha/Kolibri-1 모델 저장소
- [대한민국 정책브리핑] 독자 AI 파운데이션모델 프로젝트 2차 단계평가 결과 (2026-08-19)
- [아시아경제] 독자 AI 파운데이션 모델 2차 평가 팀별 성과 (2026-08-18)
- [Light Reading] SK Telecom A.X K2 공개 (2026-07)
- [부산일보] LG AI연구원 K-엑사원 2.0 라이선스 개방 (2026-07-31)