OpenAI가 ChatGPT 사용자 데이터를 다루는 저장소 플랫폼 Habitat을 Python에서 Rust로 다시 쓴 과정을 2026년 9월 공개했습니다. 새 Rust 서비스가 운영 요청의 95%를 처리하고, Python 버전보다 CPU 효율은 6배, 메모리 효율은 15배 높다고 밝혔어요.
흥미로운 점은 Python이 처리량 때문이 아니라 요청 사이의 조율 문제로 한계에 도달했다는 대목입니다. OpenAI 엔지니어링 블로그의 Habitat 1편에는 대규모 서비스에서 언어를 바꿀 시점을 어떻게 판단했는지도 담겨 있습니다.
 OpenAI 로고 — 출처: OpenAI
Habitat의 역할
Habitat은 ChatGPT 제품과 실제 저장소(Azure Cosmos DB·캐시·블롭 저장소) 사이에 놓인 계층입니다. 사용자 설정을 읽고 대화 기록을 가져오는 요청이 여기를 거치고, 라우팅·권한 확인·암호화·캐싱·데이터 레지던시(data residency, 데이터를 특정 국가 안에 저장)·요청 제한을 맡아요.
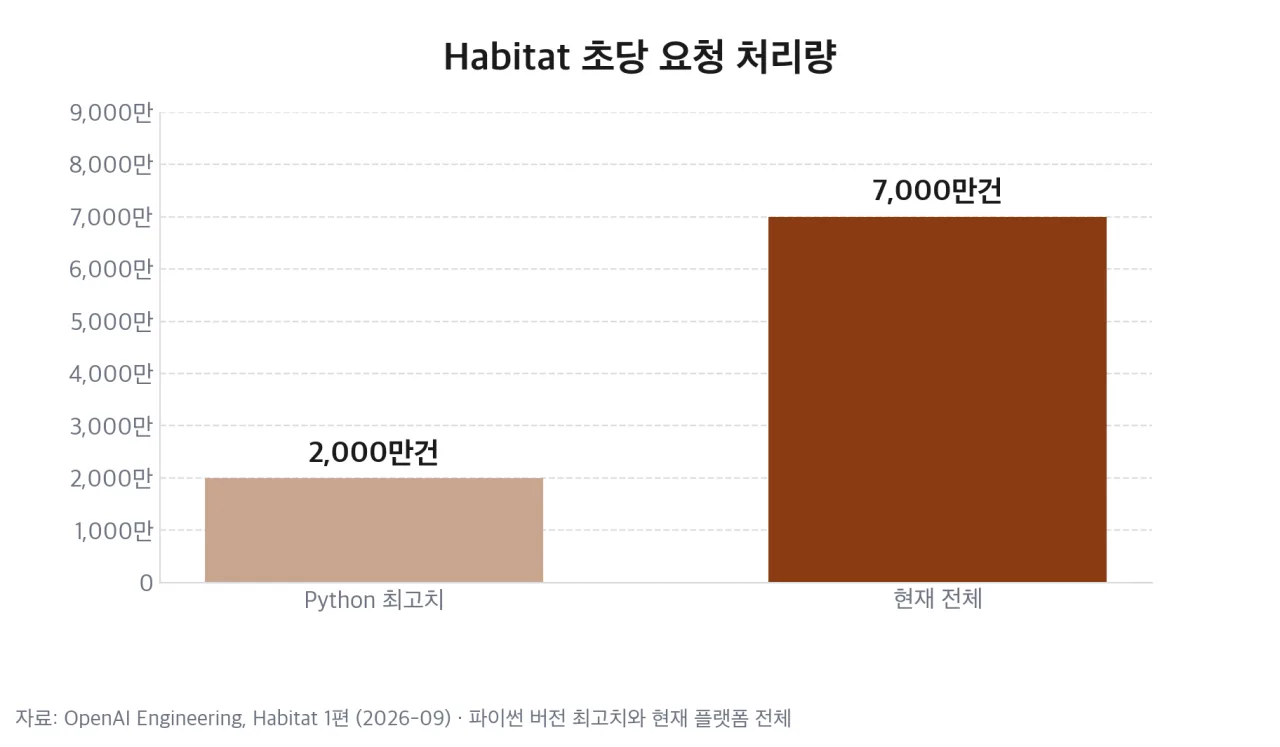 Habitat 초당 요청 처리량 — 출처: OpenAI Engineering 발표 수치 기반 자가 렌더
- 규모: 500PB(페타바이트) 이상, 약 40개 리전
- 처리량: 초당 7,000만 건 이상
- 성장: 3년 연속 해마다 10배 이상
- Python 시절 최고치: 초당 2,000만 건 이상
Python이 막힌 네 가지
 이벤트 루프 병목 개념 컷 — 출처: 개념 컷 · agy 자가 생성
OpenAI가 든 장애는 모두 CPU나 서버 대수가 모자라서가 아니라, 하나의 이벤트 루프(event loop, 비동기 작업을 차례로 처리하는 반복 구조) 안에서 작업이 서로 실행 시간을 점유한 문제였습니다.
| 문제 | 원인 | 증상 |
|---|---|---|
| 스케줄링 지연 | 설정 JSON 파싱 같은 배경 작업 | 응답 도착 뒤 처리 지연 |
| 동시 폴링 | 60초마다 기능 플래그 조회, 지터 없음 | 8개 프로세스가 동시에 멈춤 |
| LIFO 연결 풀 | 가장 최근 연결부터 재사용 | 느린 서버로 요청이 쏠림 |
| 연결 증식 | 프로세스마다 따로 연결 풀 | 동시 요청 6건에 연결 18개 |
스케줄링 지연
백엔드의 응답이 이미 도착했는데도, 이벤트 루프가 배경 작업을 돌리는 동안에는 그 응답을 꺼내 처리하지 못했어요. 대시보드에는 백엔드가 빨리 응답한 것으로 찍혀서 원인을 찾기 어려웠다고 OpenAI는 적었습니다.
동시 폴링
기능 플래그 SDK가 60초마다 설정을 새로 받았는데, 파드(pod) 하나에 뜬 8개 프로세스가 무작위 간격(jitter) 없이 같은 순간에 움직였습니다. 그 순간마다 모든 프로세스의 지연이 함께 급증했어요.
LIFO 연결 풀
aiohttp 연결 풀은 가장 최근에 반납된 연결을 먼저 다시 씁니다. 느린 서버일수록 연결을 늦게 반납해 다음 요청을 또 받게 되고, 이미 부하가 큰 파드에 요청이 집중되는 악순환이 생겼어요.
연결 증식
Python은 프로세스마다 연결 풀을 따로 두기 때문에, 동시 요청 6건을 처리하는 데 연결이 18개까지 늘었습니다.
재작성 과정과 결과
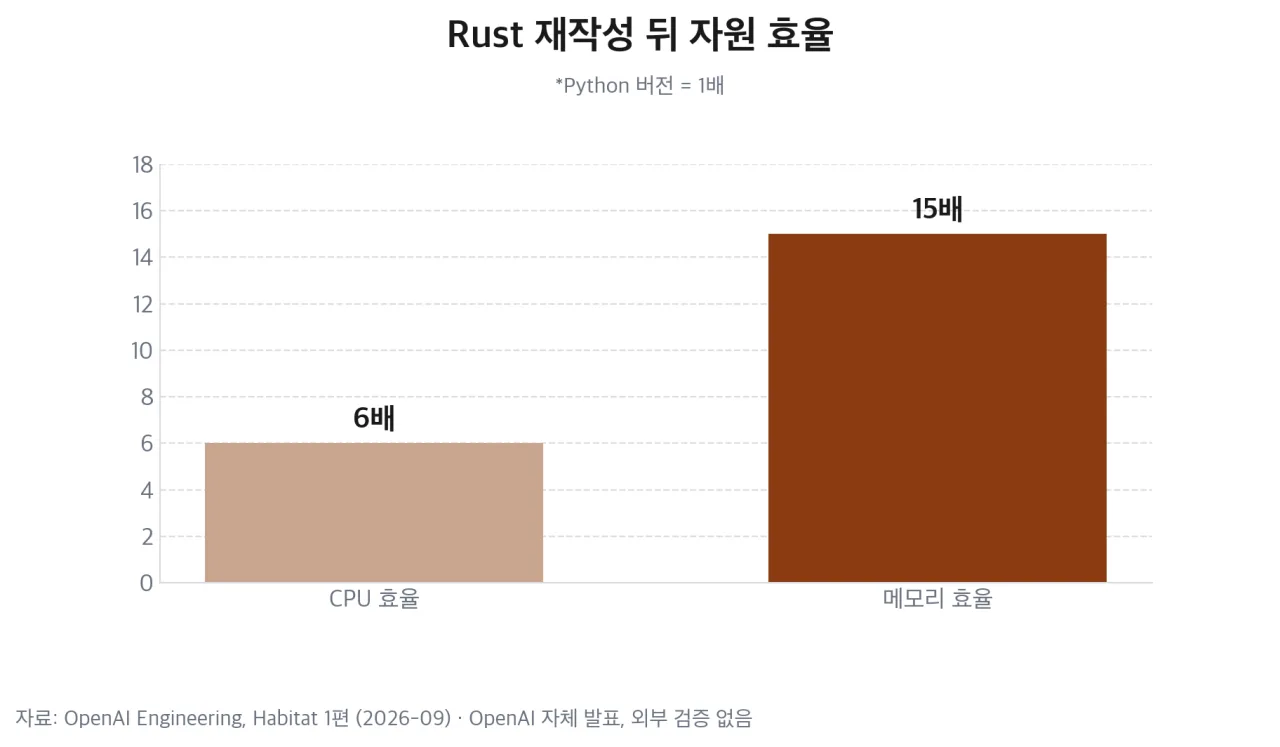 Rust 재작성 뒤 자원 효율 — 출처: OpenAI Engineering 발표 수치 기반 자가 렌더
OpenAI는 Python의 비효율이 100배 규모에서는 받아들일 수 없어 재작성이 결국 필요하다는 것을 알면서도, 한동안 일부러 Python을 유지했다고 밝혔습니다. 사내 코딩 모델이 발전하면 재작성 비용이 낮아질 것으로 보고, 기술 부채를 전략적으로 감수했다고 설명했어요.
2026년 2분기에 엔지니어 2명이 Codex와 GPT-5.5를 써서 서비스 전체를 Rust로 다시 썼습니다. Rust 버전은 운영 요청의 95%를 처리하고, CPU 효율 6배·메모리 효율 15배에 평균·꼬리 지연(tail latency, 가장 느린 일부 요청의 응답 시간)도 크게 낮아졌다고 OpenAI는 밝혔어요.
1편에는 지연 시간의 구체 수치와 재작성 검증 방식(병행 운영·결과 비교 등)이 나오지 않습니다. 모든 수치는 OpenAI 자체 발표이고, explainx는 엔지니어 2명이라는 대목을 홍보 성격이 섞인 주장으로 보고 기술적 교훈과 구분해 읽어야 한다고 짚었어요.
언어를 바꿀 시점
Habitat 사례에서 읽을 수 있는 판단 기준은 세 가지입니다.
[규모가 10배씩 커지는가] 해마다 10배씩 늘면 현재 구조도 2~3년 안에 100배 부하를 처리해야 해요. OpenAI가 재작성을 불가피하다고 본 근거가 이 성장 속도였습니다.
[병목이 연산인가 조율인가] 연산이 무거우면 C 확장이나 일부 모듈만 옮겨도 되지만, 이벤트 루프와 연결 풀의 조율 문제는 런타임 구조에서 발생해 부분 수정으로 해결하기 어렵습니다.
[재작성 비용이 감소했는가] OpenAI는 코딩 모델 덕분에 2명이 한 분기에 끝냈다고 밝혔어요.
국내 접점
OpenAI는 한국·일본·인도·싱가포르에 데이터 레지던시를 제공해, ChatGPT Enterprise·Edu 워크스페이스의 대화·파일을 해당 국가에 저장할 수 있게 했습니다. 이런 지역별 저장 규칙을 요청 경로에서 지키는 것이 Habitat 같은 저장소 계층의 역할이에요.
국내 서비스에서 Python 백엔드를 Rust로 전면 재작성한 사례를 공개한 곳은 확인되지 않았습니다.
정리
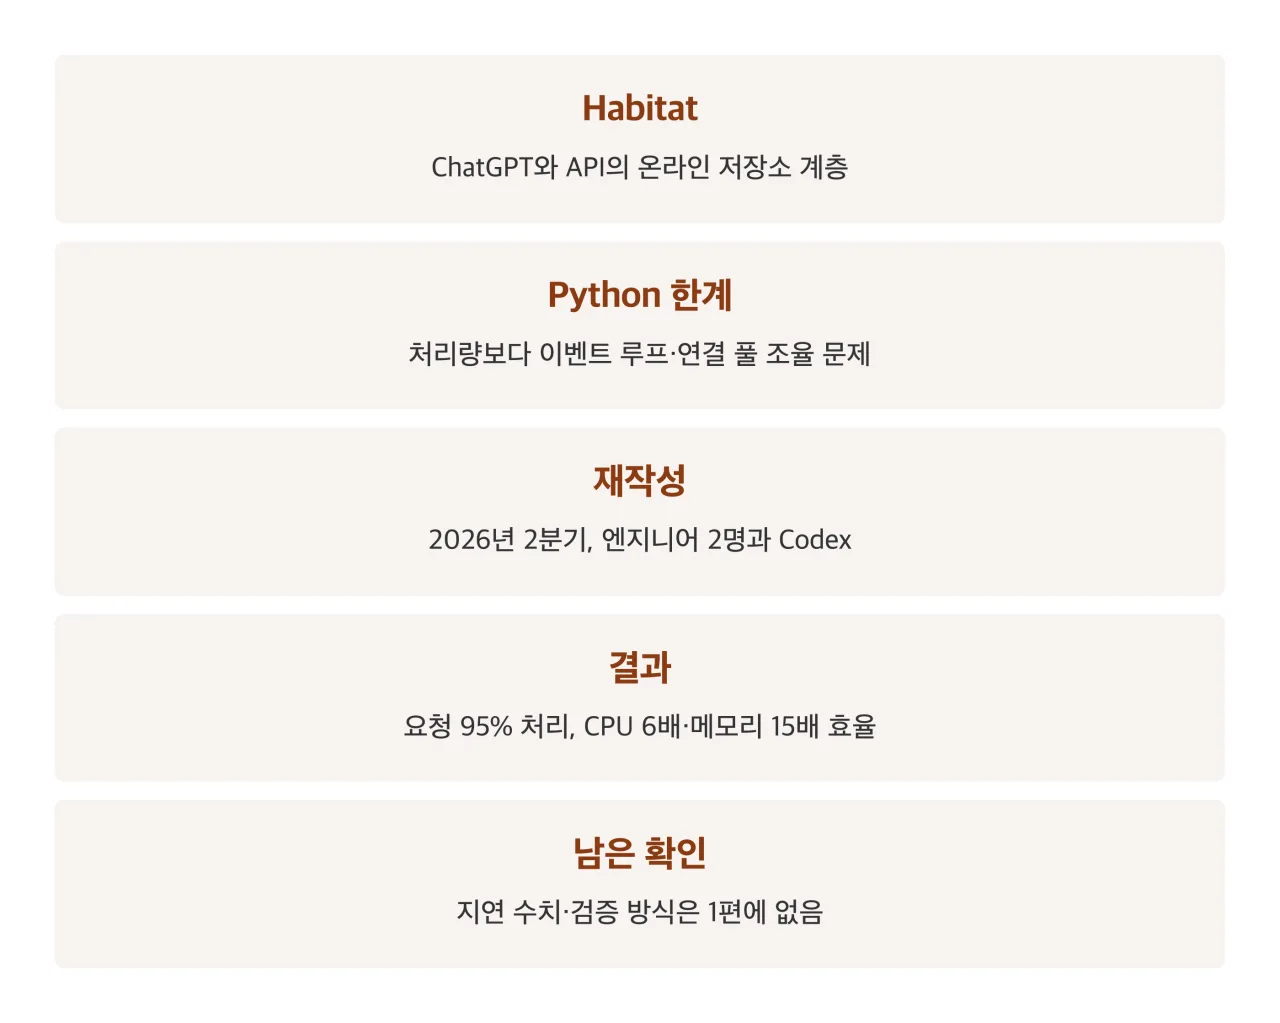 Habitat Rust 재작성 정리 카드 — 출처: OpenAI Engineering 발표 기반 자가 렌더
OpenAI는 후속 2편에서 500PB 이상의 데이터를 보관하는 저장 계층을 다룰 예정이라고 밝혔어요.