서버가 다운됐다는 말은 대개 서버 컴퓨터의 전원이 꺼졌다는 뜻이 아닙니다. 요청을 보낸 사용자에게 정해진 시간 안에 응답을 돌려주지 못하는 상태를 넓게 부르는 말이에요.
2026년 9월 11일 수시 원서접수 마감 10분 전에 유웨이어플라이가 멈춘 사건도 이 경우입니다. 사건 경과와 구제 결과는 따로 정리했어요.
수시 원서접수 먹통 — 마감 10분 전 멈춘 유웨이어플라이
 요청이 한꺼번에 몰린 서버 개념 컷 — 출처: 개념 컷 · agy 자가 생성
서버 다운의 모습과 대기 시간
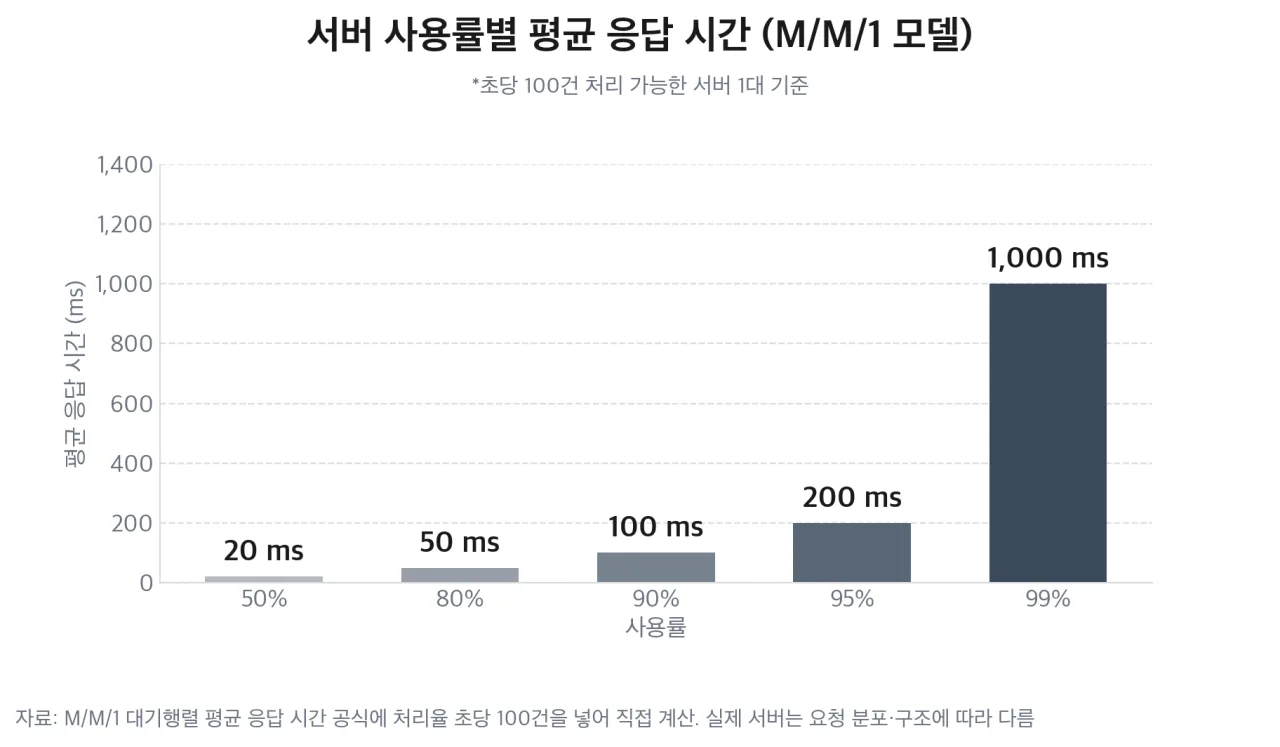 사용률별 평균 응답 시간 — 출처: M/M/1 대기행렬 공식으로 직접 계산 · 자가 렌더
사용자 화면에 나타나는 모습
사용자가 버튼을 누르면 브라우저가 서버에 요청을 보내고, 서버는 CPU·메모리·스레드(동시에 일을 처리하는 작업 단위)·네트워크 연결을 써서 응답을 생성합니다. 이 자원은 서버마다 양이 정해져 있어요. 사용자 화면에서 서버 다운은 보통 세 가지 형태로 나타납니다.
[응답 지연] 화면이 멈춘 채 대기 상태가 이어지다가 시간 초과로 끝남
[오류 응답] 서버가 요청을 거절하고 503 같은 오류 코드를 돌려줌
[프로세스 종료] 서버 프로그램이 멈추거나 재시작을 반복해 연결 자체가 안 됨
셋은 이어서 나타나기도 해요. 응답이 늦어지면 처리 중인 요청이 쌓이고, 쌓인 요청이 메모리를 채우면 프로세스가 비정상 종료됩니다.
대기열이 길어지는 속도
서버는 들어온 요청을 처리할 틈이 없으면 대기열에 넣고 순서를 기다리게 해요. 대기행렬 이론의 가장 단순한 모델인 M/M/1에서 평균 응답 시간은 1/(μ−λ)입니다. μ는 서버가 1초에 처리할 수 있는 요청 수, λ는 1초에 들어오는 요청 수예요.
- 초당 50건이 들어올 때(사용률 50%) 평균 응답 20ms
- 초당 90건(90%)이면 100ms
- 초당 99건(99%)이면 1,000ms, 50%일 때의 50배
사용률이 50%에서 99%로 두 배가 채 안 되게 늘었는데 응답 시간은 50배가 됐어요. 들어오는 양이 처리 용량에 가까워질수록 대기열이 빠르게 길어지기 때문입니다. 들어오는 요청이 처리 용량을 넘으면(λ>μ) 대기열은 줄어들 틈 없이 계속 길어지고, 결국 메모리나 시간 제한에 걸려요.
접수 마감 직전, 티켓 예매 시작 시각, 수강 신청 시작 시각처럼 정해진 시각에 사람이 몰리는 서비스가 이 구간에 들어갑니다. 평소 사용률이 낮아도 그 몇 분 동안만 λ가 μ를 넘으면 충분해요.
과부하가 연쇄 장애로 확산되는 과정
 과부하가 서버에서 서버로 번지는 연쇄 장애 개념 컷 — 출처: 개념 컷 · agy 자가 생성
Google의 운영 방법론을 정리한 책 Site Reliability Engineering(이하 SRE 책)은 연쇄 장애의 대부분이 서버 과부하에서 직접 시작하거나 그 변형이라고 설명합니다. 한두 대가 과부하로 중단되면 남은 서버에 부하가 몰려 그 서버들도 중단되는 식으로 확산돼요.
재시도가 부하를 키우는 구조
사용자가 새로고침을 누르거나 프로그램이 실패한 요청을 자동으로 다시 보내면, 거절된 요청이 다음 순간의 부하에 더해집니다. SRE 책은 초당 1만 건이 한계인 백엔드에 초당 1만 100건을 보내는 경우를 예로 듭니다.
| 시점 | 백엔드가 받는 요청 (초당) |
|---|---|
| 처음 | 10,100건 (100건 거절) |
| 1초 뒤 | 10,200건 (재시도 100건 추가) |
| 2초 뒤 | 10,300건 (재시도 200건) |
처음에 1%만 넘쳤는데 재시도가 초마다 쌓이면서 첫 시도에 성공하는 요청은 줄고, 백엔드는 자원이 고갈되어 멈춥니다.
끝나지 않는 요청이 자원을 점유하는 구조
SRE 책의 또 다른 계산은 스레드 1,000개로 초당 1,000건(요청당 100ms)을 처리하는 서버를 가정합니다. 요청의 5%가 응답 없이 100초 제한 시간까지 대기 상태로 남으면, 그 5%가 스레드 5,000개 분량을 차지해 서버는 요청의 19.6%만 처리하게 돼요. 95%는 정상 요청인데도 처리율이 5분의 1로 줄어드는 셈입니다.
변경 직후에 잦은 장애
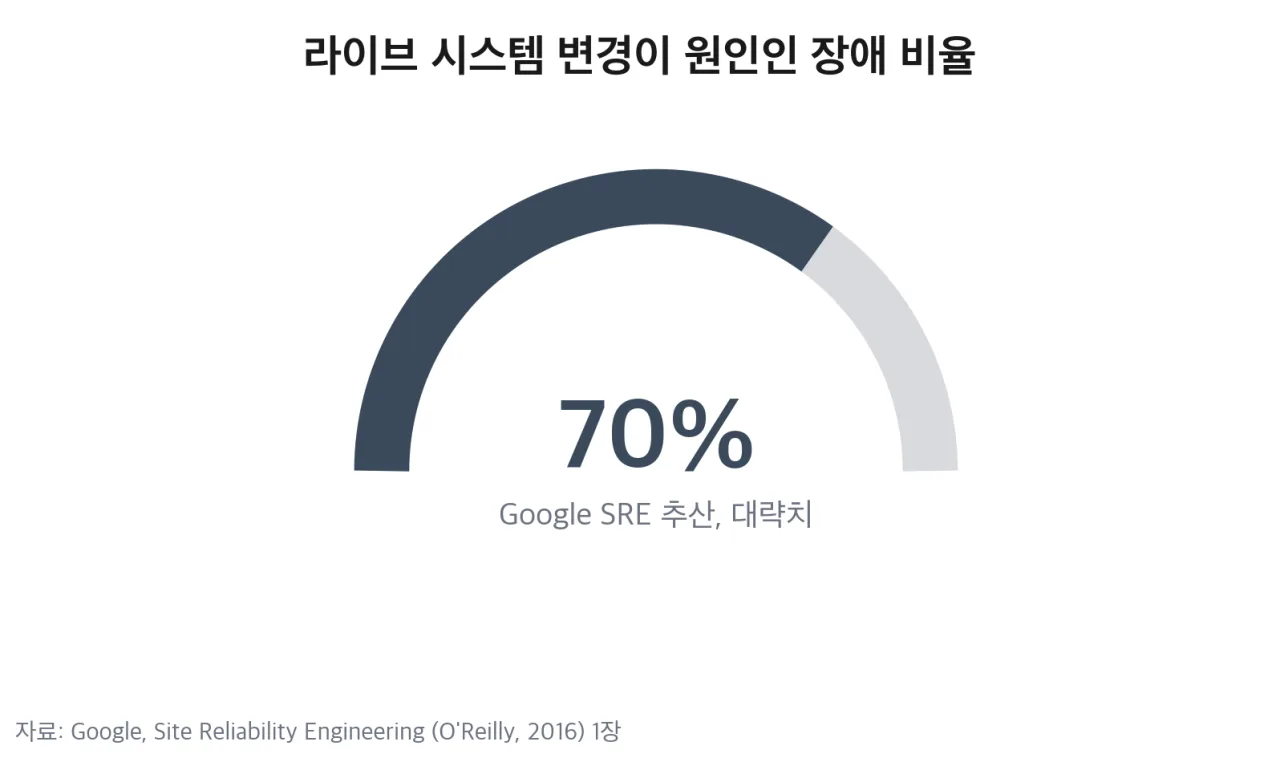 라이브 시스템 변경이 원인인 장애 비율 — 출처: Google SRE 책 수치 기반 자가 렌더
접속이 몰리는 것만으로 서버가 멈추지는 않아요. 평소와 같은 부하를 견디던 시스템이 멈추는 흔한 계기는 변경입니다. SRE 책은 Google의 경험상 장애의 약 70%가 운영 중인 시스템을 바꾸는 과정에서 생긴다고 적었어요.
장비를 옮기거나 프로그램을 업그레이드하면 평소 트래픽에서는 드러나지 않던 버그가 최대 부하에서 처음 드러날 수 있습니다. 유웨이는 9월 14일 원인을 설명하면서 최근 장비 이전과 프로그램 업그레이드 과정에서 버그 확인이 미흡했다고 밝혔고, 같은 증상이 마감 전날인 9월 10일 밤에도 나타났다고 했어요.
SRE 책이 권하는 대응은 세 가지입니다.
- 변경을 한 번에 전부가 아니라 일부 서버부터 점진적으로 배포
- 문제를 빠르고 정확하게 감지
- 문제가 생기면 안전하게 되돌리기
서버 다운을 막는 방법
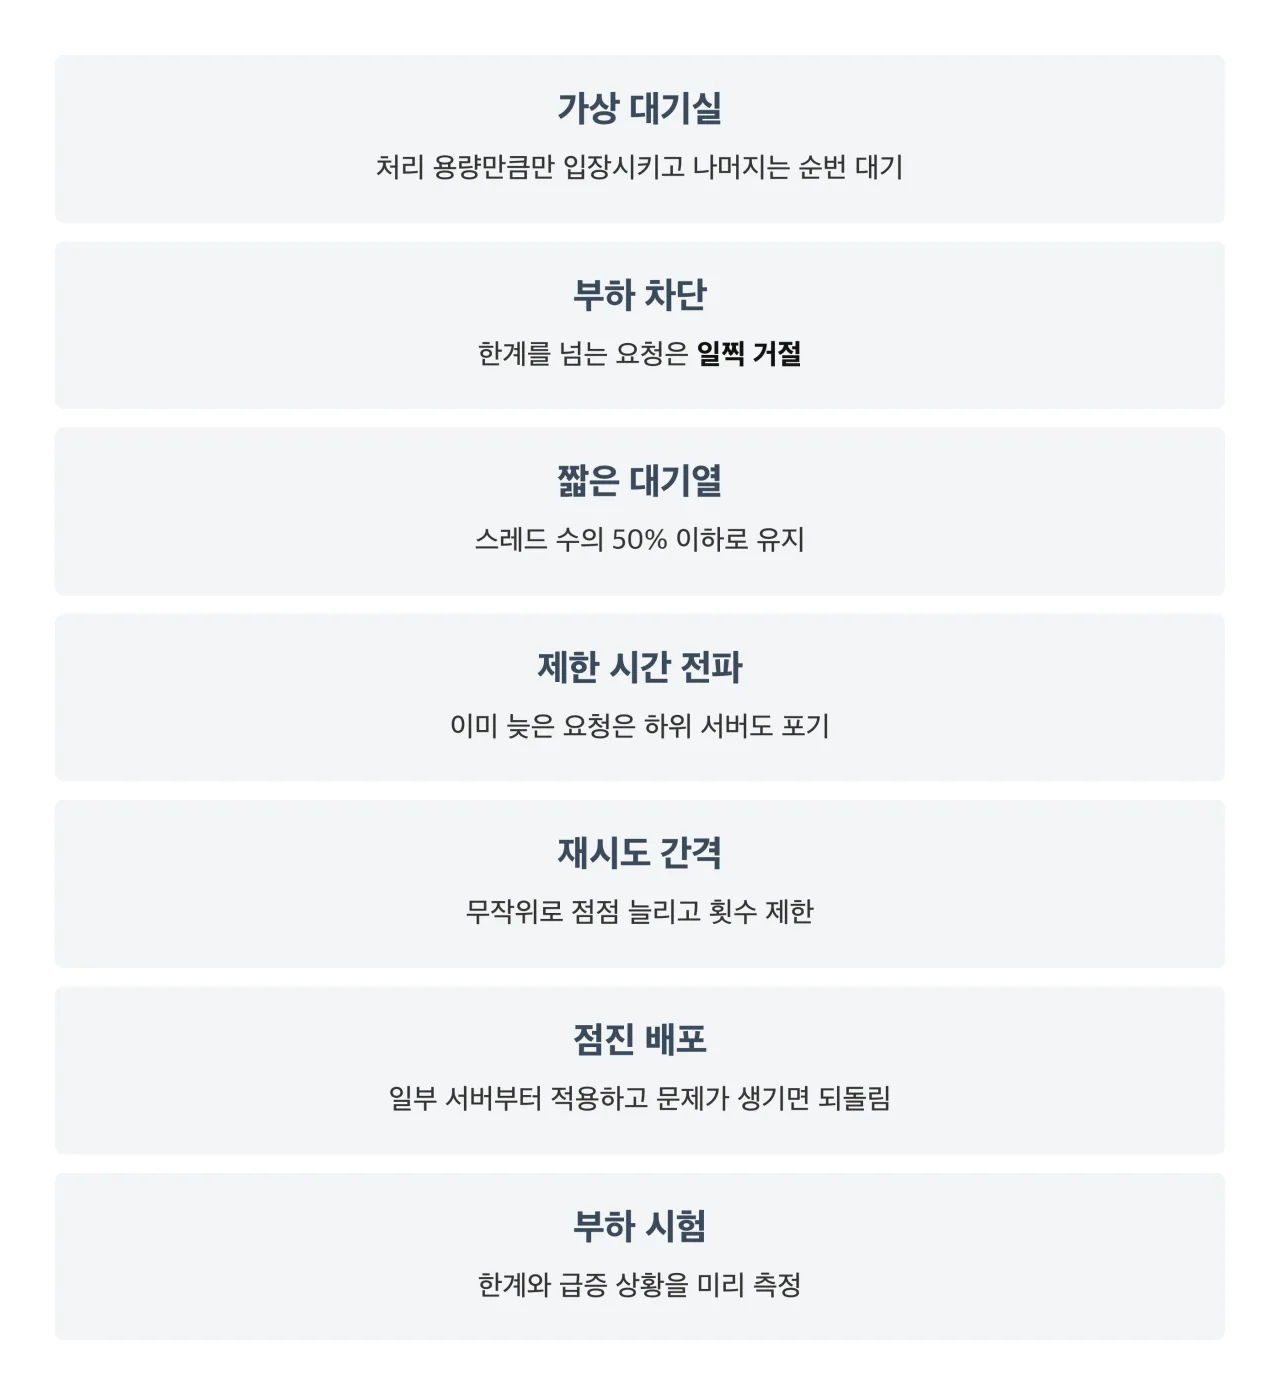 서버 다운을 막는 방법 정리 — 출처: 본문 정리 · 자가 렌더
접속이 몰리는 시각이 미리 정해진 서비스는 가상 대기실을 둡니다. 국내 대기열 솔루션인 NetFUNNEL을 만든 STCLab은 이 방식을 시스템의 처리 용량에 맞춘 진입 허용 수를 정해 트래픽을 제어하는 방식이라고 설명해요. 들어오지 못한 사용자는 순번과 예상 대기 시간을 보며 기다리고, 서버 안의 λ는 μ 아래로 유지됩니다.
SRE 책이 꼽는 서버 쪽 방어는 부하 차단, 짧은 대기열, 제한 시간 전파, 재시도 간격 조절, 부하 시험이에요. 특히 대기열은 트래픽이 꾸준한 시스템이라면 스레드 수의 50% 이하로 짧게 두어, 감당하지 못할 요청을 일찍 거절하는 편이 낫다고 설명합니다.
부하 차단은 요청 일부를 버리는 방법이라 불편해 보이지만, 전부 받다가 서버 전체가 멈추는 것보다 나머지 사용자의 요청을 정상 처리할 수 있습니다. 사용자 쪽에서는 멈춘 화면에서 새로고침을 연달아 누르는 행동이 재시도 폭증에 더해진다는 점을 알아 두면 돼요.
참고 출처
- [Google SRE] Site Reliability Engineering, Addressing Cascading Failures (재시도 증폭·5% 지연 계산·대응법)
- [Google SRE] Site Reliability Engineering, Introduction (변경이 원인인 장애 약 70%·점진 배포)
- [Google SRE] Site Reliability Engineering, Handling Overload (과부하 처리)
- [Wikipedia] M/M/1 queue (평균 응답 시간 공식)
- [STCLab] 넷퍼넬 가상 대기실 순번 정보가 정확할 수 있나요 (진입 허용 수 방식)
- [한국대학신문] 수시 접수 먹통 유웨이, 전날도 서버 불안정 (장비 이전·업그레이드 원인 설명, 2026-09-14)