ChatGPT 개발에 참여한 연구자가 세운 TypeSafe AI가 2026년 9월 15일 Jev라는 모델을 공개했어요. 질문을 입력하면 문장이 아니라 선택지별 확률과 신뢰도 점수를 반환하는 모델입니다.
회사는 기존 LLM(대규모 언어모델)보다 40~200배 빠르고 40~400배 싸다고 밝혔고, Vercel AI Gateway에서는 출시 24시간 만에 유료 팀의 약 13%가 이 모델을 호출했어요.
 TypeSafe AI 공식 대표 이미지 — 출처: TypeSafe AI
Jev 개요
 문장을 생성하지 않고 정해진 선택지 가운데 하나를 고르는 결정 모델 개념 — 출처: 개념 컷 · agy 자가 생성
TypeSafe AI는 2024년 샌프란시스코에서 세워진 회사로, OpenAI에서 약 4년간 InstructGPT·ChatGPT·GPT-4의 RLHF(인간 피드백 기반 강화학습)를 맡았던 Diogo Almeida가 CEO예요. 2년간 외부 공개 없이 개발한 첫 모델이 Jev이고, 공개와 함께 DCVC가 주도한 약 560억 원(4,000만 달러) 시드 투자를 발표했습니다.
회사는 이 모델 계열을 System One Model이라 불러요. Daniel Kahneman이 『생각에 관한 생각』에서 나눈 빠르고 직관적인 시스템 1, 느리고 숙고하는 시스템 2 구분에서 따온 이름입니다. 모델명 Jev는 효율이 높아지면 소비가 오히려 늘어난다는 제번스의 역설(Jevons paradox)을 제시한 19세기 경제학자 William Stanley Jevons에서 왔어요.
| 항목 | 내용 |
|---|---|
| 개발사 | TypeSafe AI (미국) |
| 공개 | 2026년 9월 15일, 대기자 명단 |
| 시드 투자 | 약 560억 원(4,000만 달러), DCVC 주도 |
| 입력 요금 | 100만 토큰당 59원 |
| 출력 요금 | 무료 |
| 요청당 입력 | 최대 64k 토큰 |
| 현재 버전 | jev-1.13.0 |
가중치는 공개하지 않아 직접 설치해 돌릴 수 없고, TypeSafe API나 Vercel AI Gateway 같은 호스팅 경로로 호출해요.
요청과 응답 구조
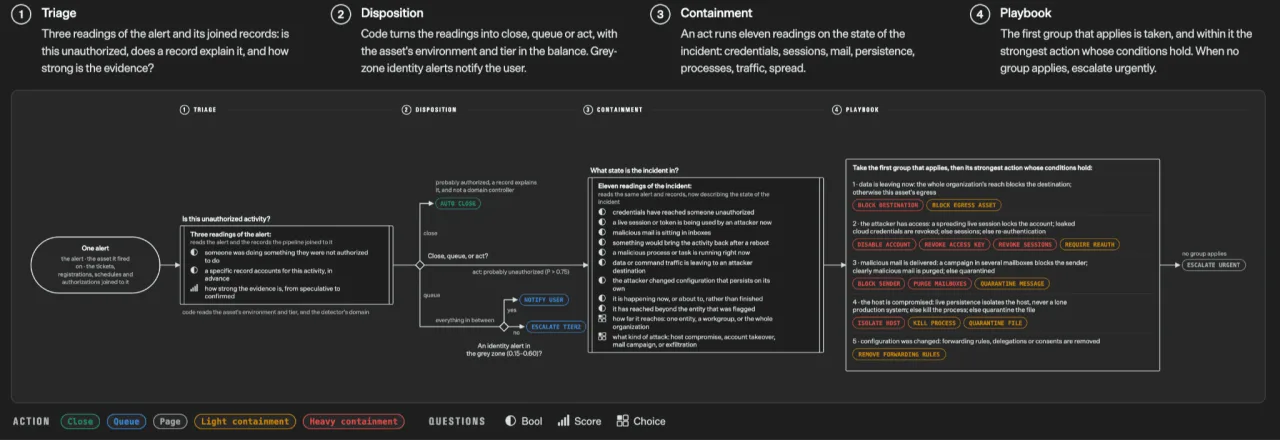 TypeSafe가 공개한 보안 사고 워크플로, 분류·처리·격리·대응 네 단계에 질문을 붙인 구조 — 출처: TypeSafe AI
LLM은 다음 토큰(token, 모델이 처리하는 글자 조각)을 하나씩 이어 붙여 문장을 만들어요. Jev는 문장을 만들지 않고, 개발자가 미리 적어 둔 답안 틀(스키마) 안에서 값을 고릅니다. 질문 형식은 세 가지예요.
| 형식 | 묻는 것 | 돌려주는 값 |
|---|---|---|
| Choice | 목록에서 하나 고르기 | 선택지·확률·신뢰도 |
| Score | 등급표로 점수 매기기 | 등급·확률·신뢰도 |
| Noul | 문장이 참인가 | 0~1 사이 확률 |
Choice는 선택지를 최대 255개까지 받고, 질문 여러 개를 한 요청에 넣으면 같은 입력(state)을 두고 병렬로 평가해요. TypeSafe가 공개한 보안 사고 워크플로는 경보 하나를 분류, 처리 방식, 격리, 대응 절차 네 단계로 나누고 단계마다 고르기·점수·참거짓 질문을 붙였습니다.
공식 문서의 예시는 고객 문의를 담당 부서로 보내는 요청이에요. 운동화 사이즈가 잘못 왔으니 10 사이즈로 바꿔 달라는 문장을 state에 넣고, 반품·배송·결제 세 부서 설명을 선택지로 줍니다.
💻 [소스코드: Jev Choice 요청 (공식 예시 축약)]
from typesafe_sdk import (
    Choice, TypeSafeClient)

with TypeSafeClient() as client:
  r = client.system_one(
    state="Wrong size. Swap for 10?",
    questions={"dept": Choice(
      instructions="Which team?",
      criteria={
        "returns": "Exchanges",
        "shipping": "Delivery",
        "billing": "Payments",
      })})
  print(r.answers["dept"].choice)
공식 예시의 응답은 choice: returns, confidence: 1.0 이고, 확률은 반품 1.0·배송 0.0·결제 0.0이었어요.
신뢰도(confidence)는 확률이 한 선택지에 몰렸는지 흩어졌는지로 계산해요. MarkTechPost가 인용한 예에서는 결제가 0.84로 1위였지만 기술 지원이 0.159를 가져가 신뢰도는 0.596에 그쳤습니다. 답과 별개로 이 값을 보고 자동 처리할지 사람 검토로 전환할지를 코드에서 결정할 수 있어요.
속도와 비용
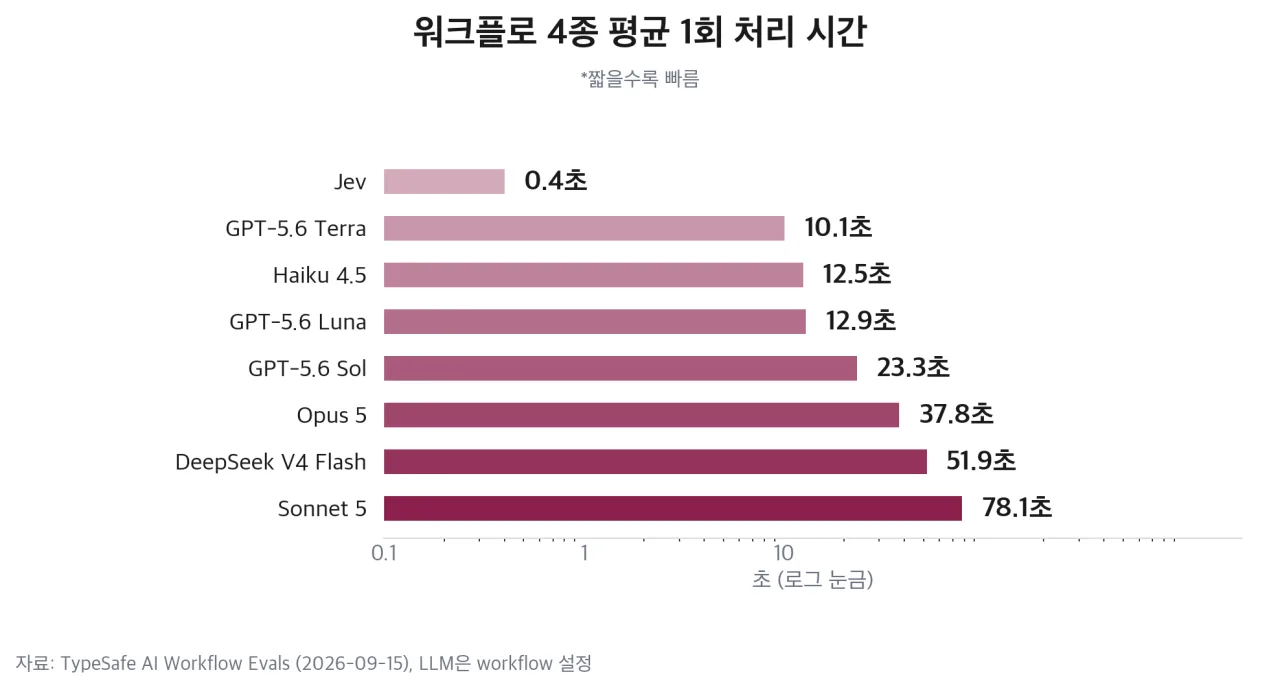 워크플로 4종 평균 1회 처리 시간, Jev와 LLM 7종 — 출처: TypeSafe AI Workflow Evals 기반 자가 렌더
TypeSafe는 요청부터 응답까지 70~500밀리초가 걸린다고 밝혔고, 비교한 LLM은 같은 워크플로에 3초에서 329초가 걸렸어요. 모델 구조는 공개하지 않았지만, 토큰을 하나씩 생성하는 방식(autoregressive) 대신 모든 출력을 한 번에 생성하는 병렬 샘플러를 쓴다고 설명했습니다. 출력이 선택지 이름과 확률 몇 개뿐이라 생성할 문장이 없어요.
학습은 합성 데이터만 썼고, RLHF 대신 RLCD(Reinforcement Learning for Calibrated Decisions)라는 방식으로 모델이 내는 확률이 실제 정답률과 맞도록 학습했다고 해요. The Register가 전한 공식 데모 한 건에서는 Jev가 0.114초·0.11원, GPT-5.6 Terra가 8.566초·19.4원이 들었습니다.
| 모델 | 입력 (원/100만 토큰) | 출력 (원/100만 토큰) |
|---|---|---|
| Jev | 59 | 0 |
| GPT-5.6 Luna | 280 | 1,680 |
| GPT-5.6 Terra | 2,800 | 16,800 |
| GPT-5.6 Sol | 7,000 | 42,000 |
출력이 무료라 비용은 입력 길이로만 정해져요. 요청당 입력은 64k 토큰까지이고, 분당 1,200건·초당 25만 토큰의 속도 제한이 있습니다. TypeSafe는 이 요금을 오래 유지할 수 있을지는 장담할 수 없다고 발표문에 직접 적었어요.
공식 벤치마크 수치
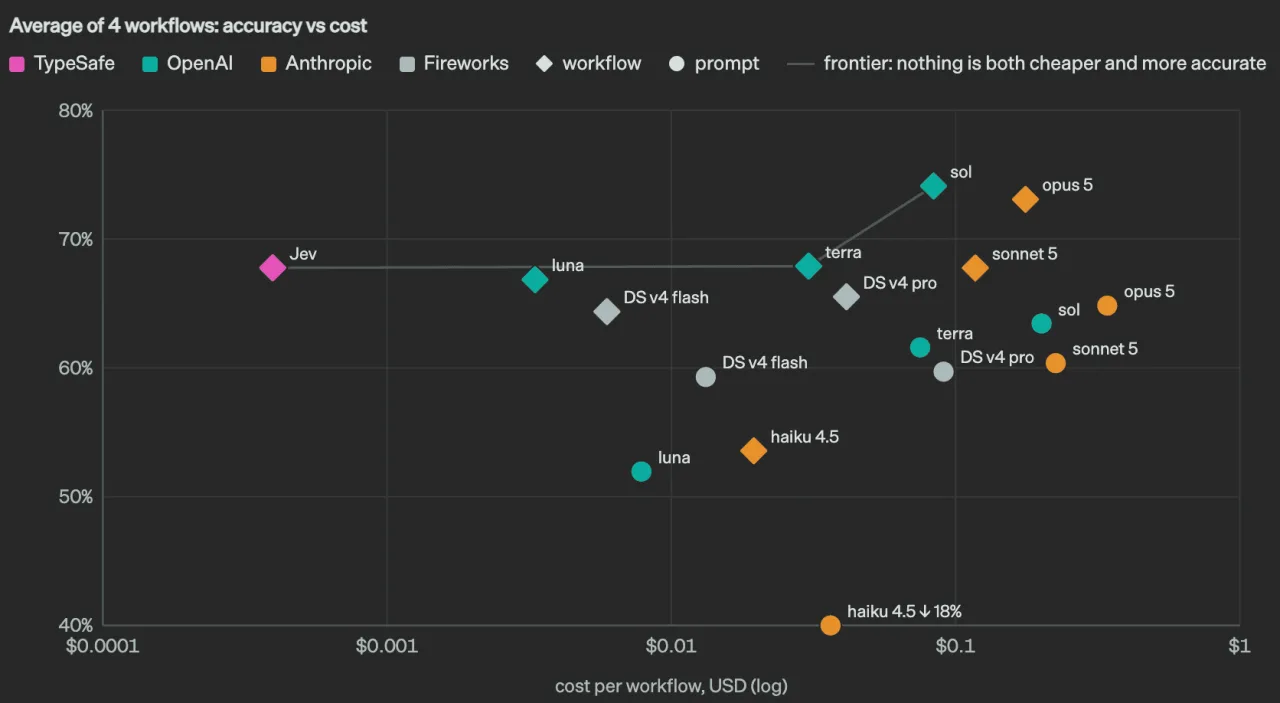 워크플로 4종 평균 정확도와 1회 비용 산점도, Jev·OpenAI·Anthropic·DeepSeek 모델 — 출처: TypeSafe AI
TypeSafe는 보안 사고 분류, 에이전트 실행 기록 점검, 송장 처리, 고객 응대의 네 가지 업무 흐름(워크플로)으로 모델을 비교했어요. 정답 라벨은 GPT-6 Astra와 Claude Fable 5.1을 높은 추론 설정으로 실행해 두 모델이 합의한 답을 썼습니다.
| 모델 | 평균 정확도 (%) | 1회 비용 (원) |
|---|---|---|
| Jev | 67.8 | 0.56 |
| GPT-5.6 Terra | 67.9 | 42.6 |
| GPT-5.6 Luna | 66.8 | 4.6 |
| GPT-5.6 Sol | 74.1 | 117 |
| Claude Opus 5 | 73.1 | 246.5 |
| DeepSeek V4 Flash | 64.4 | 8.3 |
평균 정확도로는 Jev가 GPT-5.6 Terra와 0.1%포인트 차이로 같은 수준이고, 1위 GPT-5.6 Sol보다 6.3%포인트 낮아요. 홈페이지에 적힌 193.6배 빠르고 444.6배 싸다는 수치는 가장 느리고 비싼 비교 대상과 견준 배수라고 지디넷코리아 칼럼이 짚었고, 정확도가 같은 Terra와 견주면 약 25배 빠르고 76배 싸요.
업무별 편차
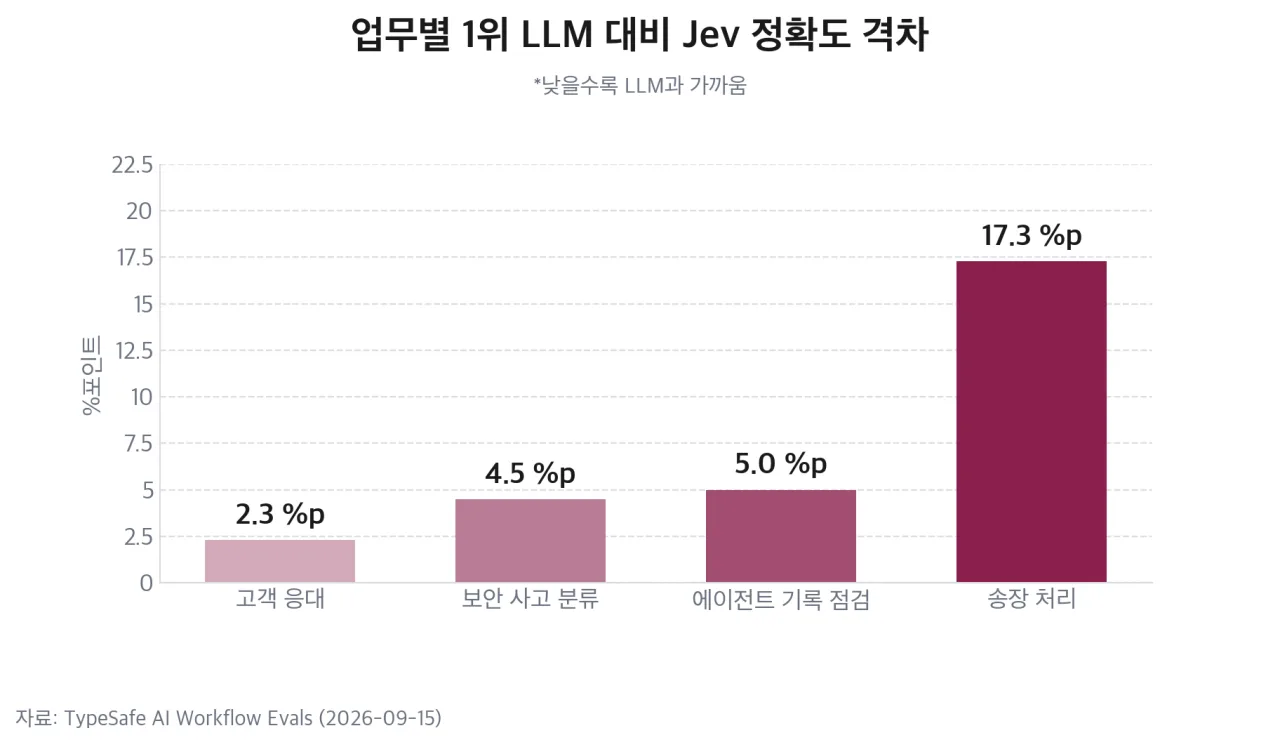 업무별 1위 LLM 대비 Jev 정확도 격차 — 출처: TypeSafe AI Workflow Evals 기반 자가 렌더
고객 응대에서는 Jev 76.0%, 1위 GPT-5.6 Sol 78.3%로 2.3%포인트 차이지만, 송장 처리에서는 Jev 61.8%, Sol 79.1%로 17.3%포인트 차이가 났습니다. 보안 사고 분류는 Claude Opus 5(66.2%)와 4.5%포인트, 에이전트 기록 점검은 Sol(76.6%)과 5.0%포인트 차이였어요.
TypeSafe는 이 워크플로를 자사 모델 역량 팀원들이 만들었고, 데모는 미국 서부의 노트북에서 실행했으며, 제시한 배수가 실제 이득을 높게 잡은 수치라고 발표문에서 밝혔어요. 비교 대상도 OpenAI·Anthropic 모델 위주라 DeepSeek 대비 성능은 과소평가됐을 수 있다고 적었습니다.
도입 현황과 쓰임새
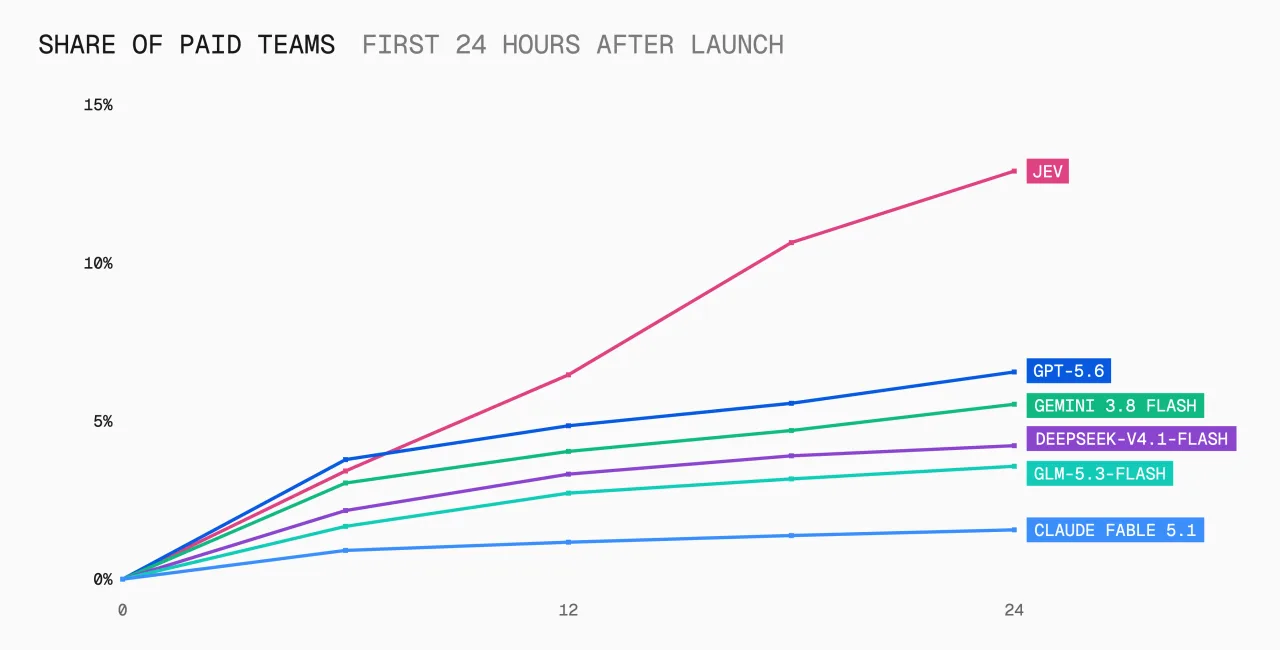 Vercel AI Gateway 출시 후 24시간 유료 팀 채택률, Jev와 최근 모델 비교 — 출처: Vercel
Vercel은 9월 18일 블로그에서 Jev가 AI Gateway 출시 18시간 만에 유료 팀의 10%, 24시간 만에 약 13%에 도달했다고 밝혔어요. 같은 기간 GPT-5.6 계열의 약 2배, Claude Fable 5.1의 6배가 넘는 비율이고, 게이트웨이에서는 9월 25일까지 무료로 제공됩니다.
Vercel CEO Guillermo Rauch는 자사 도구 fx의 자동 모드에서 모든 명령을 검사하는 안전 검토 단계를 GPT-5.6 Luna에서 Jev로 바꿔 시험했고, p95 기준 최대 18배 빨라지면서 정확도도 높았다고 X에 적었어요. 측정 방법은 공개하지 않았습니다.
공식 문서와 Vercel이 꼽은 쓰임새는 정해진 답이 있는 반복 판단이에요.
- 고객 문의·티켓을 담당 부서로 분류
- 에이전트가 다음에 호출할 도구나 하위 에이전트 선택
- 게시물 검수와 위험도 점수 매기기
- 다른 LLM의 출력이 규칙을 지켰는지 확인하는 가드레일
신뢰도 기준 분기
공식 문서는 신뢰도를 답과 별도의 판단 기준으로 쓰라고 권해요. 0.6 미만은 사람 검토로 전환하고, 틀렸을 때 피해가 큰 작업일수록 자동 처리 기준을 높입니다.
| 신뢰도 | 잔액 조회 | 송금 |
|---|---|---|
| 0.85 초과 | 자동 처리 | 자동 처리 |
| 0.6~0.85 | 자동 처리 | 사용자 확인 |
| 0.6 미만 | 사람 검토 | 사람 검토 |
한계와 반론
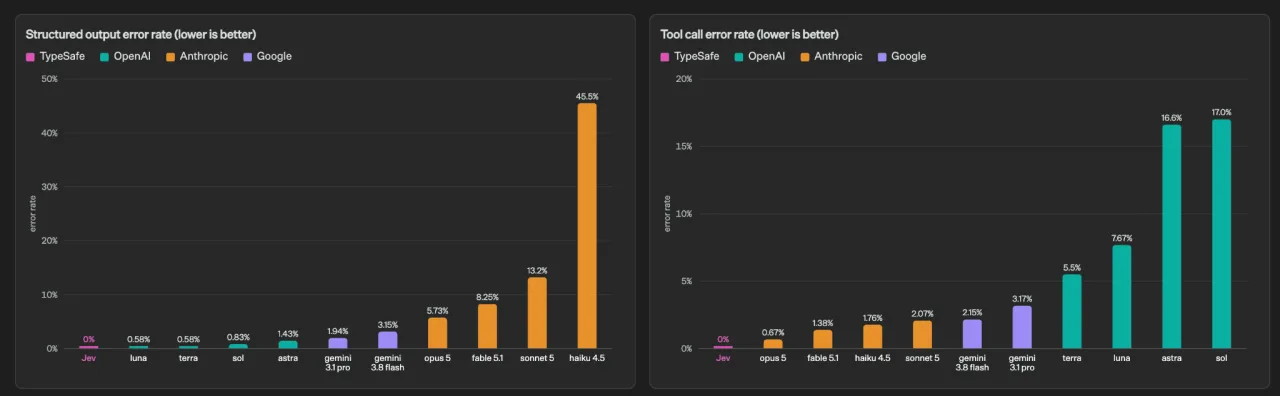 구조화 출력 오류율과 도구 호출 오류율, Jev 0% — 출처: TypeSafe AI
환각 0%의 범위
TypeSafe는 Jev의 구조화 출력 오류율과 도구 호출 오류율을 0%로 제시했어요. 목록에 없는 답이나 형식이 틀린 값을 낼 수 없다는 뜻이고, 틀린 선택지를 고를 확률이 0이라는 뜻은 아닙니다. MarkTechPost도 이 0%는 측정값이 아니라 스키마 일치가 보장된다는 의미라고 정리했고, 같은 모델의 워크플로 평균 정확도는 67.8%예요.
확률 보정 검증
RLCD의 핵심 주장은 0.85라고 답한 판단이 실제로 85% 정도 맞는다는 보정(calibration)이에요. 출시 시점까지 보정 곡선, ECE(기대 보정 오차) 같은 수치, 논문은 공개되지 않았고, Hacker News 출시 글타래에서도 이 부분에 대한 질문이 답을 받지 못했습니다.
분류 모델과의 차이
Hacker News와 Reddit에서는 이미 있는 제로샷 분류 모델과 무엇이 다르냐는 반응이 나왔어요. KDnuggets 칼럼은 분류·의도 판별은 오래된 문제이고, TypeSafe가 새로 만든 것은 그 문제를 푸는 구조와 개발 경험이라고 봤습니다. 공개 1주일 사이 Qwen3.5 기반으로 Jev와 같은 응답 형식을 따르는 오픈소스 Kev(0.8B·4B·9B)와 비교용 벤치마크 JevBench도 공개됐어요.
점수만으로 확인하기 어려운 편향
Simon Willison은 샌프란시스코 베이 지역 도시마다 좋은 도시인지를 참거짓 질문으로 물었고, Jev는 Cupertino를 가장 높게, East Palo Alto를 가장 낮게 매겼어요. 그는 근거 문장 없이 숫자 하나만 반환되니 편향 검토가 먼저이고, 채용 같은 판단에는 쓰지 말라고 했습니다. 호출 한 번이 1원도 안 되니 수백~수천 건의 실험으로 먼저 검증하라는 조언도 붙였어요.
국내에서는 2026년 1월 22일 시행된 AI 기본법이 채용·대출 심사 등을 고영향 인공지능으로 정하고, 결과 도출의 주요 기준을 설명할 방안과 사람의 관리·감독을 사업자에게 요구해요. 확률만 내는 Jev를 이런 판단에 쓰려면 신뢰도 분기에 사람 검토를 포함하는 설계가 필요합니다.
한국어 성능과 폐쇄형 운영
공식 문서는 영어가 주 학습 언어이고 정확도도 가장 높으며, 한국어를 포함한 한중일 문자는 처리하지만 같은 수준은 아니라고 적었어요. 국내 서비스에 넣으려면 한국어 데이터로 정확도와 보정 수준을 다시 측정해야 합니다.
가중치가 비공개라 판단할 데이터를 외부 API로 보내야 한다는 점도 도입 전에 확인할 부분입니다.
정리
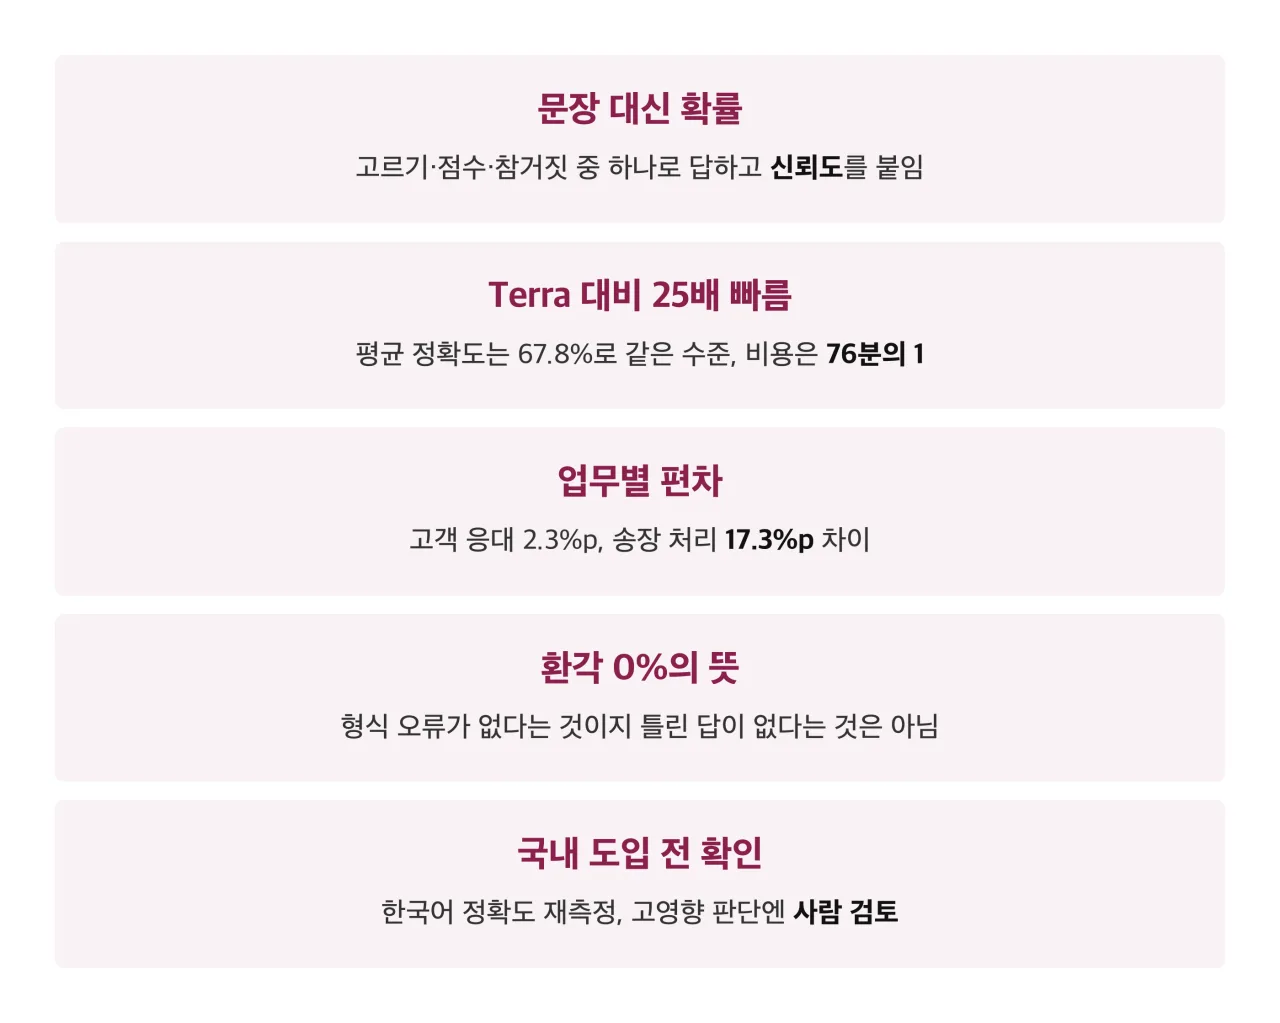 Jev 핵심 정리 다섯 가지 — 출처: TypeSafe AI·Vercel 공개 자료 기반 자가 렌더
참고 출처
- [TypeSafe AI] Introducing System One Models & Jev (공식 발표·벤치마크·한계)
- [TypeSafe AI] Workflow Evals (워크플로별 정확도·비용·처리 시간)
- [TypeSafe AI Docs] Models (요금·입력 한도·속도 제한·언어 지원)
- [TypeSafe AI Docs] Choice (요청·응답 예시)
- [TypeSafe AI Docs] Confidence-gated routing (신뢰도 기준 분기)
- [Vercel] Jev is the fastest-adopted model in AI Gateway history (채택률)
- [X] Guillermo Rauch 게시물 (fx 안전 검토 교체 결과)
- [The Register] TypeSafe AI debuts model for machines (데모 수치)
- [MarkTechPost] TypeSafe AI Releases Jev (신뢰도 계산·0%의 의미)
- [Simon Willison] Jev introduces a new shape of LLM (편향 실험)
- [KDnuggets] What Everyone Is Getting Wrong About TypeSafe AI’s Jev (분류 모델 비교)
- [지디넷코리아] 안광섭 AI 진테제, Jev 칼럼 (배수 산정 기준)
- [Wikipedia] Jev (AI model) (창업자·투자·이름 유래)
- [GitHub] jaredpalmer/kev (오픈소스 Kev)
- [Finout] GPT-5.6 Pricing 2026 (GPT-5.6 요금)
- [국가법령정보센터] 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법
- 환율: 1달러 ≈ 1,400원 기준 환산