AI Hub에 2026년 6월 올라온 판결서 익명처리 데이터로 판결문 RAG를 직접 만들었습니다. 판결문에 등장하는 사람·조직·주소를 가명으로 바꾸는 라벨이 붙은 데이터셋이고, 이 라벨을 적용하면 같은 사람이 한 문서 안에서도, 여러 문서에 걸쳐서도 같은 가명으로 연결된 학습용 코퍼스가 생성돼요.
그 코퍼스를 임베딩해 검색하고, 로컬 LLM이 비슷한 판결을 근거로 가상 판결문의 이유 초안을 쓰게 했습니다. 모든 과정은 이 PC 한 대에서 실행했고, 판결문은 외부로 전송되지 않았어요.
 AI Hub 판결서 익명처리 데이터 소개 화면 — 출처: AI Hub
데이터셋 구성
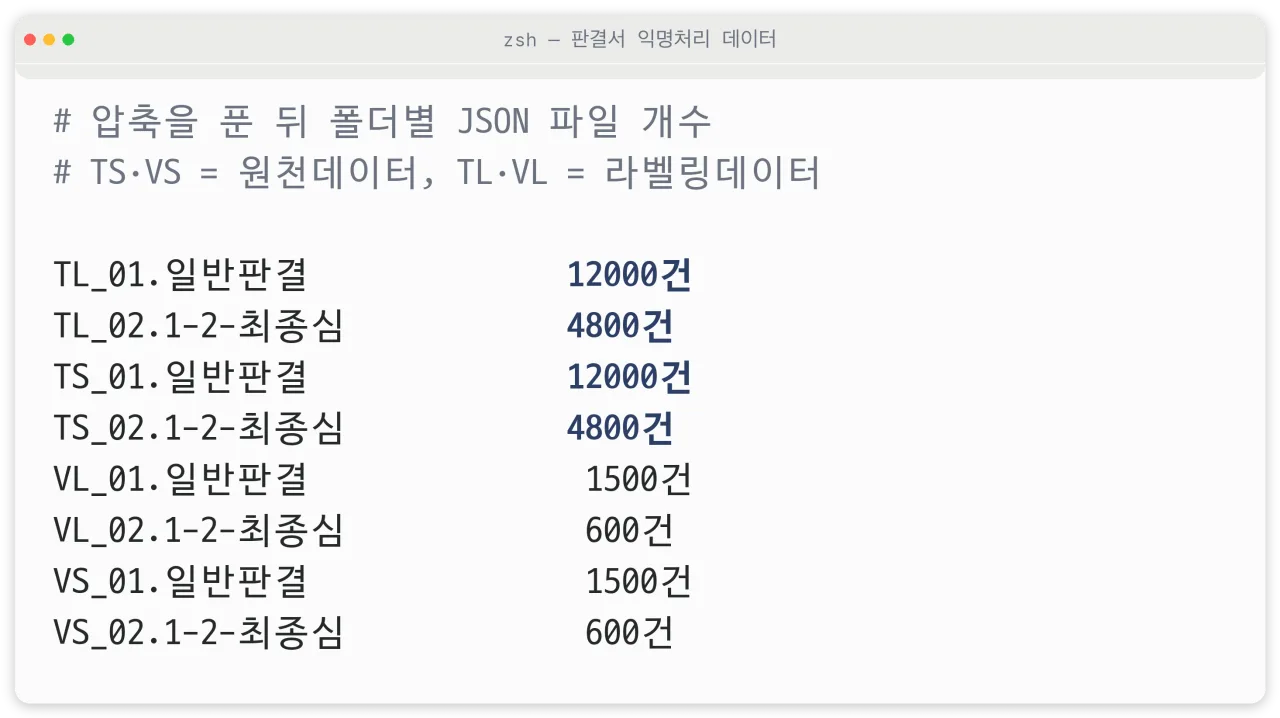 폴더별 JSON 파일 개수 — 출처: AI Hub 데이터 직접 집계 · 자가 렌더
주식회사 에이뉴트가 주관하고 피씨엔·한국아이티법학연구소가 참여해 구축했습니다. AI Hub 기준 전체 21,000건이고, 개방된 압축 파일은 학습셋 16,800건과 검증셋 2,100건으로 모두 18,900건이에요.
| 구분 | 학습셋 | 검증셋 |
|---|---|---|
| 일반판결 | 12,000 | 1,500 |
| 1·2·최종심 | 4,800 | 600 |
일반판결은 민사 3,400건, 일반행정 3,200건, 형사 2,400건이 중심이고 근로자·특허·금융조세·개인정보·가사·기업 판결이 400~600건씩 포함돼 있습니다. 1·2·최종심은 한 사건의 1심·2심·3심 판결 세 건을 한 폴더에 모은 형태로, 학습셋에 1,600개 사건이 있어요.
한 건은 info(사건 정보)·sections(판시사항·판결요지·이유 등 본문 구역)·annotations(익명처리 라벨) 세 부분으로 된 JSON입니다. 일반판결 학습셋의 본문 길이는 중앙값 4,531자, 가장 긴 판결은 28만 3,031자였어요.
익명처리 라벨
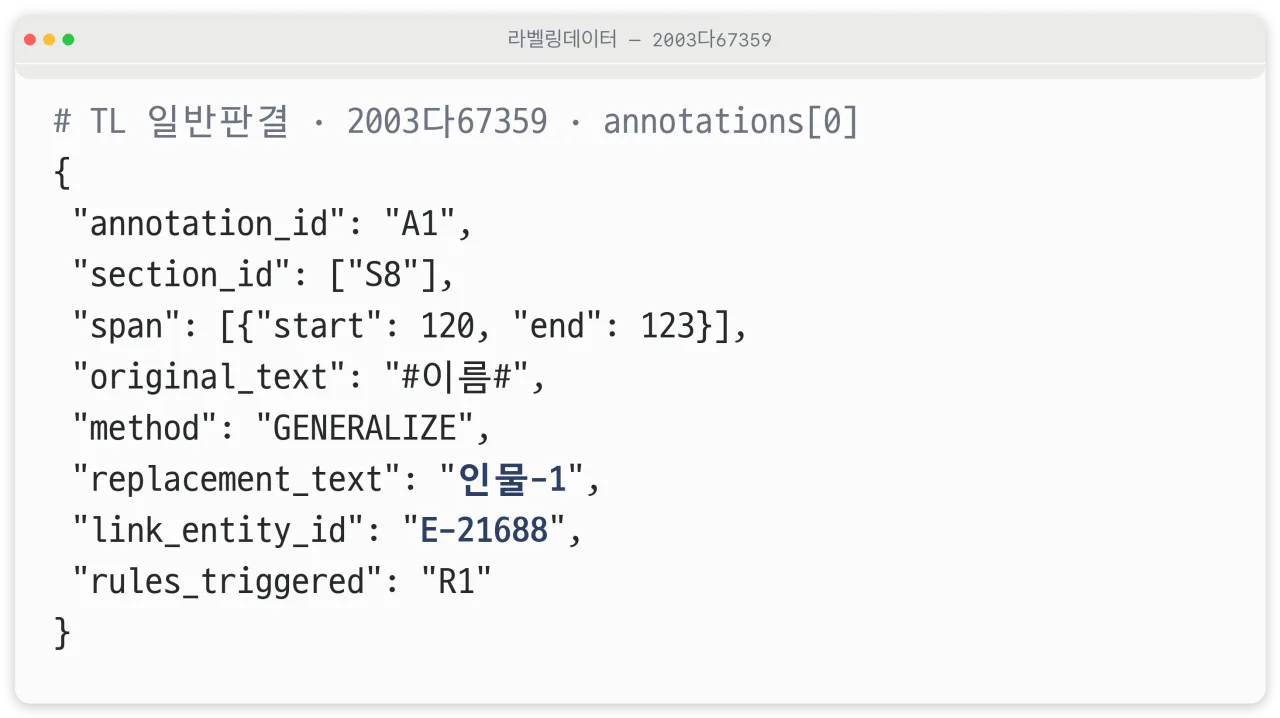 라벨 한 건의 구조 — 출처: AI Hub 라벨링데이터 · 자가 렌더
라벨 한 건은 본문의 어느 위치(span)에 있는 원문을 어떤 가명(replacement_text)으로 바꿀지, 그 근거 규칙과 판단 이유를 적습니다. 모든 라벨의 처리 방식은 GENERALIZE(일반화) 하나였어요.
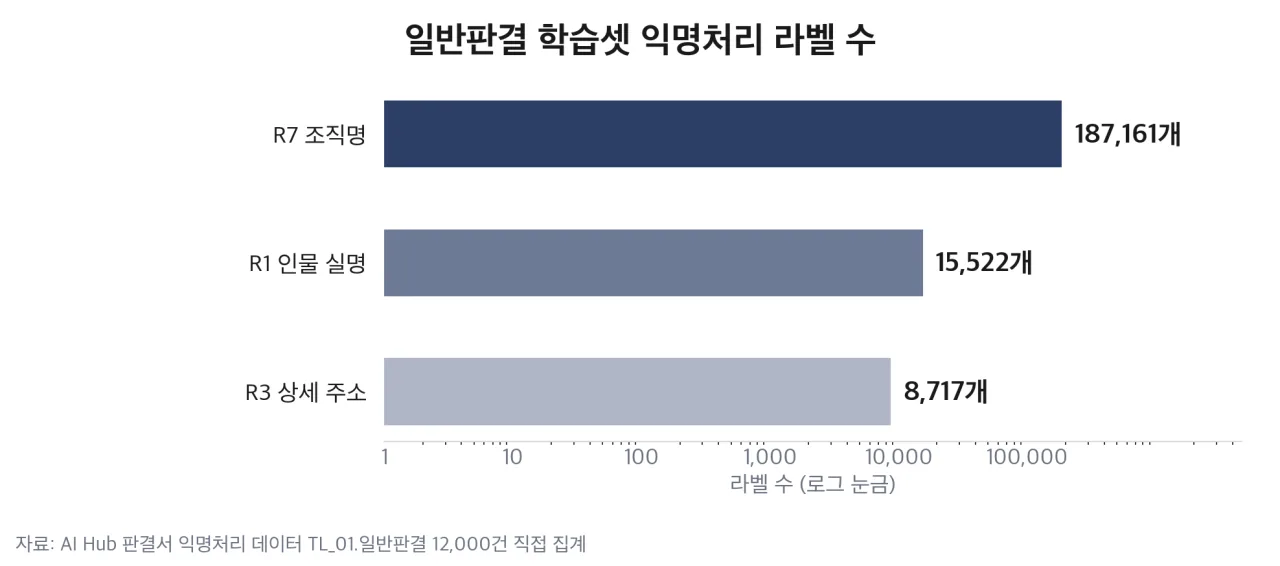 일반판결 학습셋 규칙별 라벨 수 — 출처: AI Hub 데이터 직접 집계 · 자가 렌더
일반판결 학습셋 12,000건의 라벨 211,400개 가운데 88.5%가 조직명(R7)입니다. 기업명뿐 아니라 대법원·특허심판원 같은 기관명도 조직명으로 처리돼 조직-4 같은 가명이 됩니다. 사람 이름(R1)은 인물-1·원고-1·피해자-1처럼 역할을 반영한 가명으로, 상세 주소(R3)는 서울특별시 은평구 A처럼 시·군·구 단위로 바뀌어요.
직접 확인한 데이터 특성
- 라벨의 약 13%는 span 위치가 본문과 한두 칸 어긋나 있어, 원문 문자열로 위치를 다시 찾아야 함
- 판결문 공개 때 가려진 이름은 원문부터 #이름#으로 표기돼 있음
- 학습셋 16,800건 중 15,640건에서 주문(主文) 구역 제목까지 #이름#으로 가려져 있음
가명 코퍼스 만들기
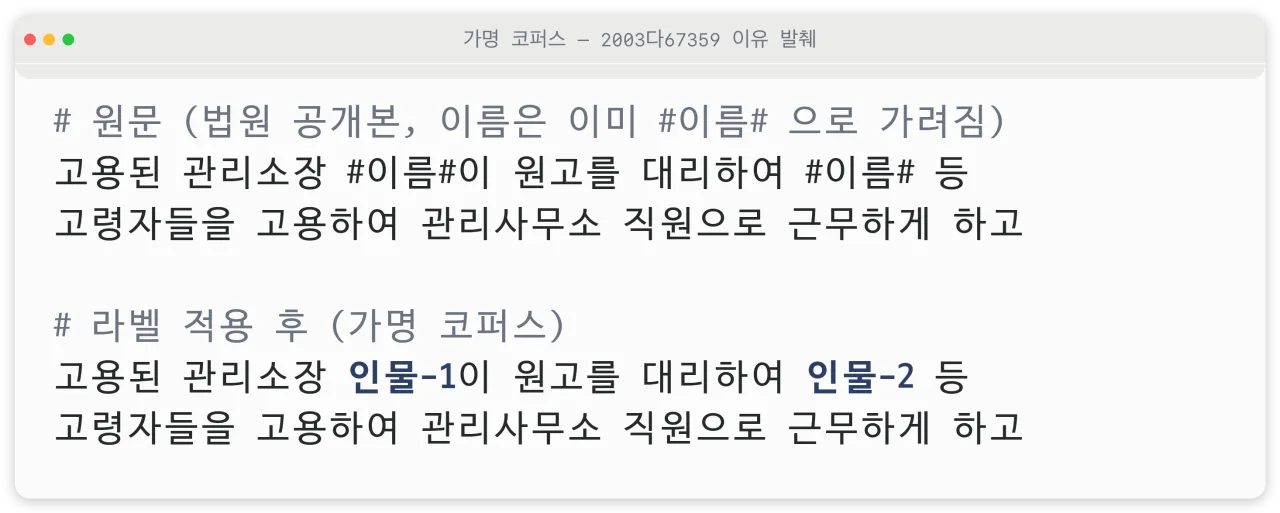 라벨 적용 전후 비교 — 출처: AI Hub 데이터 · 자가 렌더
라벨을 본문에 적용하면 원문에서 #이름# 하나로 가려져 있던 두 사람이 인물-1과 인물-2로 구분됩니다. 가명 처리를 하면서도 인물 간 구분은 유지돼요.
첫 구현에서는 위치가 어긋난 라벨을 문서 전체 문자열 치환으로 처리했다가, #이름#이 모두 첫 번째 가명으로 치환되는 문제가 생겼습니다. 라벨마다 원래 위치에서 가장 가까운 한 곳만 바꾸도록 고친 뒤 위 결과를 얻었어요.
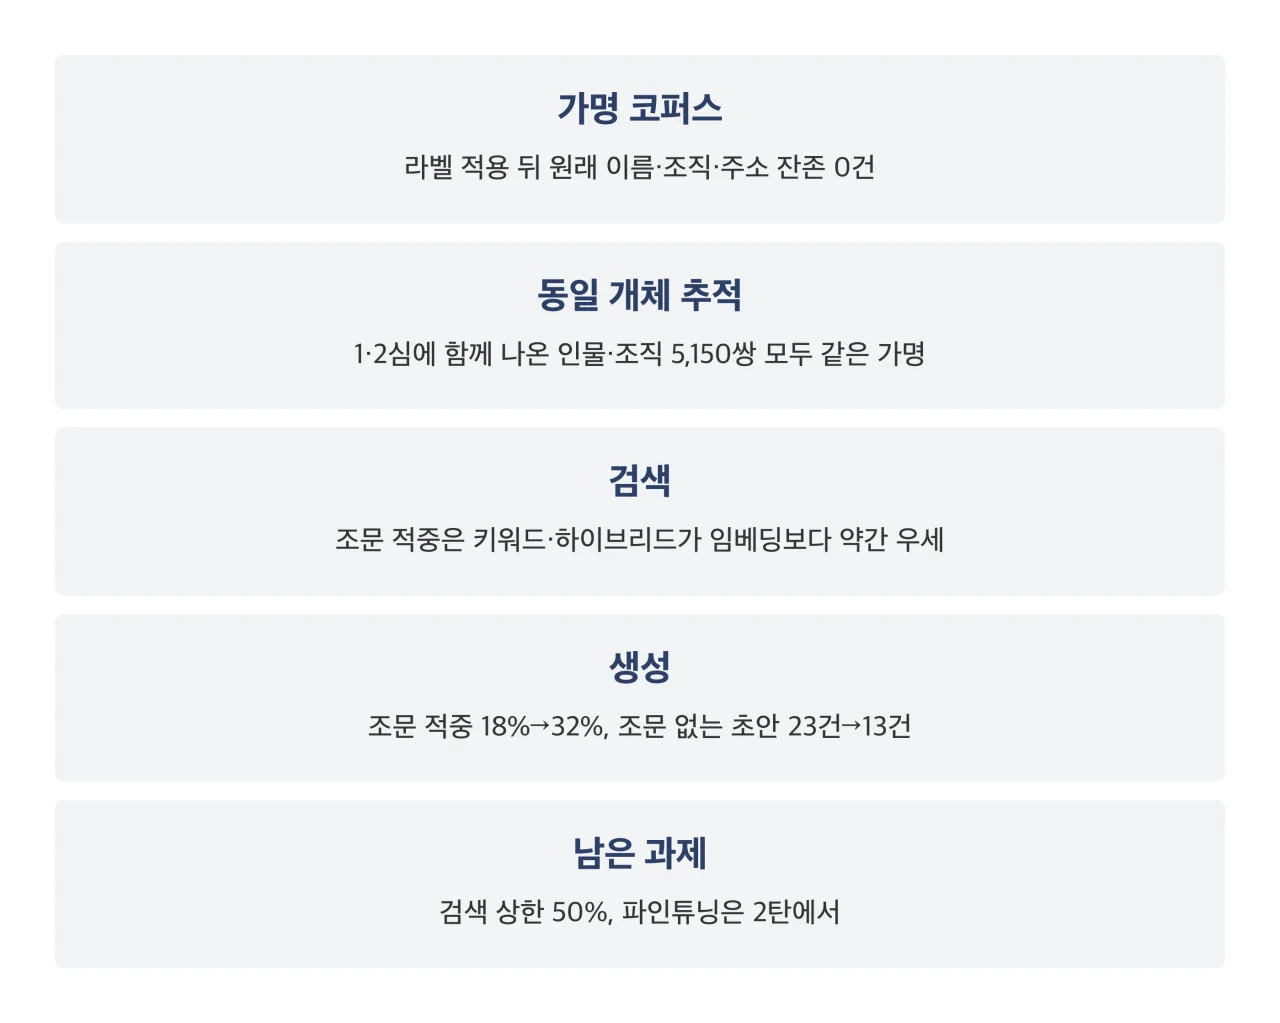
라벨이 한 위치에만 지정된 이름이 다른 위치에 다시 나오면 같은 가명으로 한 번 더 바꿨습니다. 이 2차 치환이 1,061곳이었고, 적용 뒤 학습셋 16,800건에서 원래 이름·조직·주소가 남은 문서는 0건이었어요.
심급 간 동일 개체 추적
라벨의 link_entity_id는 같은 사람·조직을 가리키는 식별자입니다. 1·2·최종심 학습셋 1,600개 사건에서 1심과 2심에 함께 나온 식별자가 있는 사건은 1,476개(92.3%), 세 심급 모두에 나온 사건은 1,370개(85.6%)였어요.
1심과 2심에 함께 나온 5,150쌍은 전부 같은 가명을 받았습니다. 1심의 원고-1이 2심·3심에서도 원고-1이어서, 심급별로 같은 인물의 주장과 판단을 추적할 수 있어요.
초간단 RAG 구성
| 단계 | 사용한 것 |
|---|---|
| 검색 단위 | 판결 1건 = 벡터 1개 |
| 임베딩 | BAAI/bge-m3 |
| 생성 | Qwen3-4B-Instruct-2507 4bit |
| 실행 환경 | Apple M3 Pro 36GB · MLX |
판결 한 건마다 사건명·판시사항·판결요지와 이유 앞부분을 이어 붙여 최대 1,800자로 제한한 뒤 벡터 하나로 만들었습니다. 문단 단위로 나누는 chunking은 하지 않았어요.
bge-m3는 BAAI가 2024년 2월 공개한 다국어 임베딩 모델로, 100개 이상 언어를 지원하고 최대 8,192토큰까지 처리합니다. 받은 모델 파일 기준 파라미터는 5억 6,775만 개(float32, 2.27GB)이고 라이선스는 MIT예요.
학습셋 16,800건 임베딩에는 5,041초(84분)가 걸렸습니다. 다른 작업을 할 수 있게 배치를 8건으로 줄이고 배치 사이에 0.5초씩 쉬게 한 저부하 설정에서 1회 잰 시간이에요.
검색 방식 비교
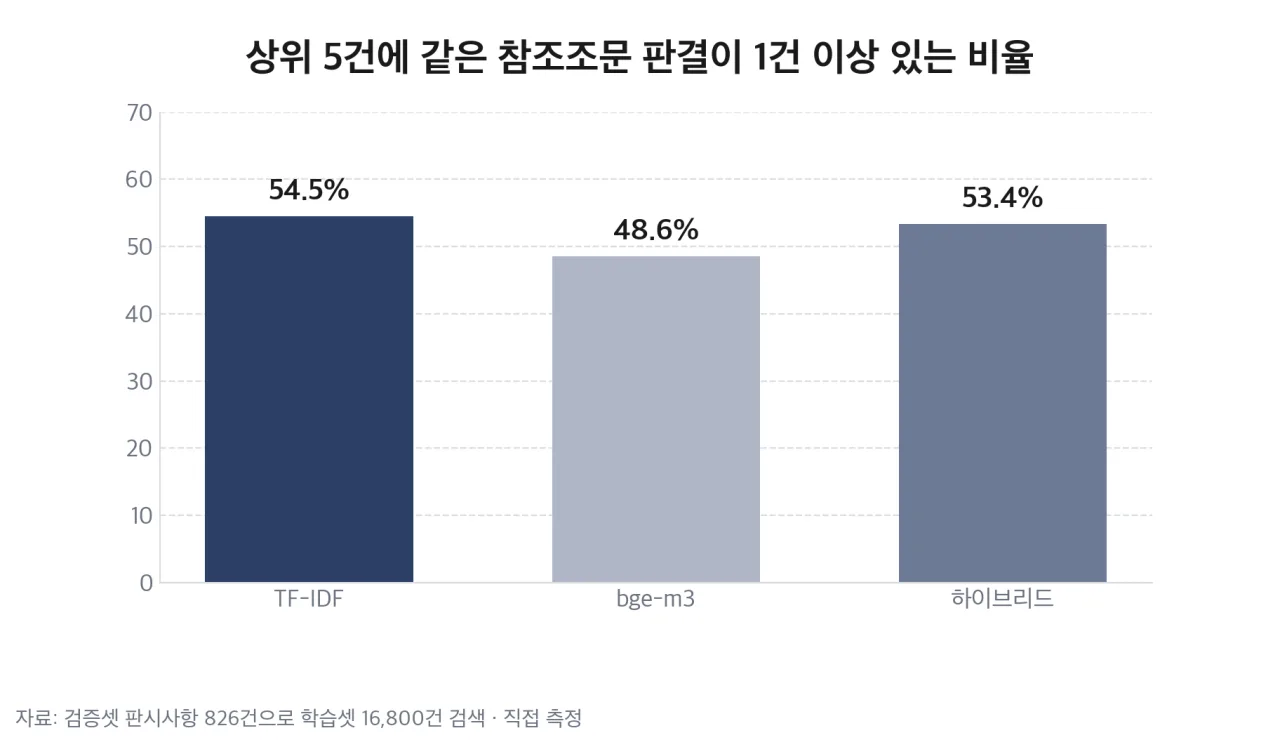 검색 방식별 참조조문 적중 비율 — 출처: 직접 측정 · 자가 렌더
검증셋에서 판시사항과 참조조문이 모두 있는 826건의 판시사항을 질의로 넣고, 학습셋에서 찾은 상위 5건이 같은 법령 조문을 참조하는지 셌습니다. 대조군은 글자 2~3개 단위 TF-IDF, 세 번째 조건은 두 순위를 합친 하이브리드(RRF)예요.
| 지표 (상위 5건) | TF-IDF | bge-m3 | 하이브리드 |
|---|---|---|---|
| 같은 조문 판결 비율 | 20.6% | 17.9% | 20.9% |
| 1건 이상 적중 | 54.5% | 48.6% | 53.4% |
| 같은 분야 비율 | 69.9% | 69.6% | 71.9% |
조문 적중률은 키워드 방식이 임베딩보다 높았습니다. 판시사항에 법령명과 조문 번호가 그대로 포함돼 있어, 글자가 겹치는 문서를 찾는 방식이 유리했던 것으로 보여요.
학습셋 가운데 참조조문이 적힌 판결은 6,579건(39%)뿐이라, 조문이 없는 판결이 검색되면 그만큼 적중률이 낮아집니다. 질의 1건 검색 시간은 bge-m3 71.6ms, TF-IDF 459.9ms로 bge-m3가 6배가량 빨랐어요(5회 중앙값).
임베딩 공간의 참조조문 분포
 bge-m3 임베딩 3D 지도 회전 — 출처: AI Hub 데이터 · UMAP 3D · 자가 렌더
참조조문이 있는 판결 6,579건마다 원래 공간에서 가장 가까운 이웃 10건을 뽑아, 조문이 하나 이상 겹치는 비율을 셌습니다. bge-m3는 21.5%, TF-IDF는 24.8%였고 무작위로 고른 두 판결은 0.72%였어요.
같은 조문을 쓰는 판결끼리 무작위보다 30배가량 모이지만, 글자로 비교하는 쪽이 조금 더 촘촘했습니다. 3차원으로 줄인 지도에서도 행정소송법·형법 판결은 따로 모이는 반면, 가장 많은 민법 판결 1,040건은 지도 전체에 퍼져 있어요.
🔗 링크 첨부 - https://no1joon.github.io/oh-my-notebooks/legal-rag-map/
가상 판결 이유 초안
검증셋 대법원 판결 50건의 판시사항을 쟁점으로 주고, 같은 모델에 두 번씩 이유 초안을 쓰게 했습니다. 한 번은 근거 없이, 한 번은 bge-m3로 찾은 참고 판결 3건을 함께 입력했어요.
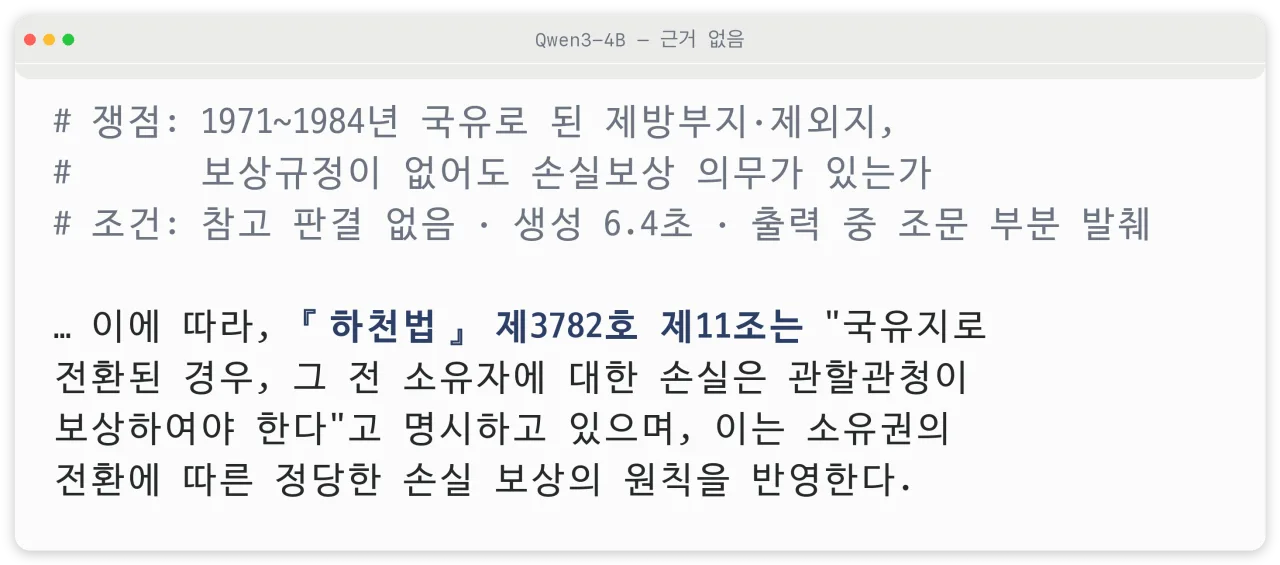 근거 없이 쓴 이유 초안 — 출처: Qwen3-4B 실제 출력 · 자가 렌더
근거 없이 쓴 초안은 존재하지 않는 조문을 만들고, 그 조문의 문구까지 따옴표로 지어냈습니다. 다른 쟁점에서는 우리 법에 없는 해상운송법 제12조를 근거로 든 초안도 생성됐어요.
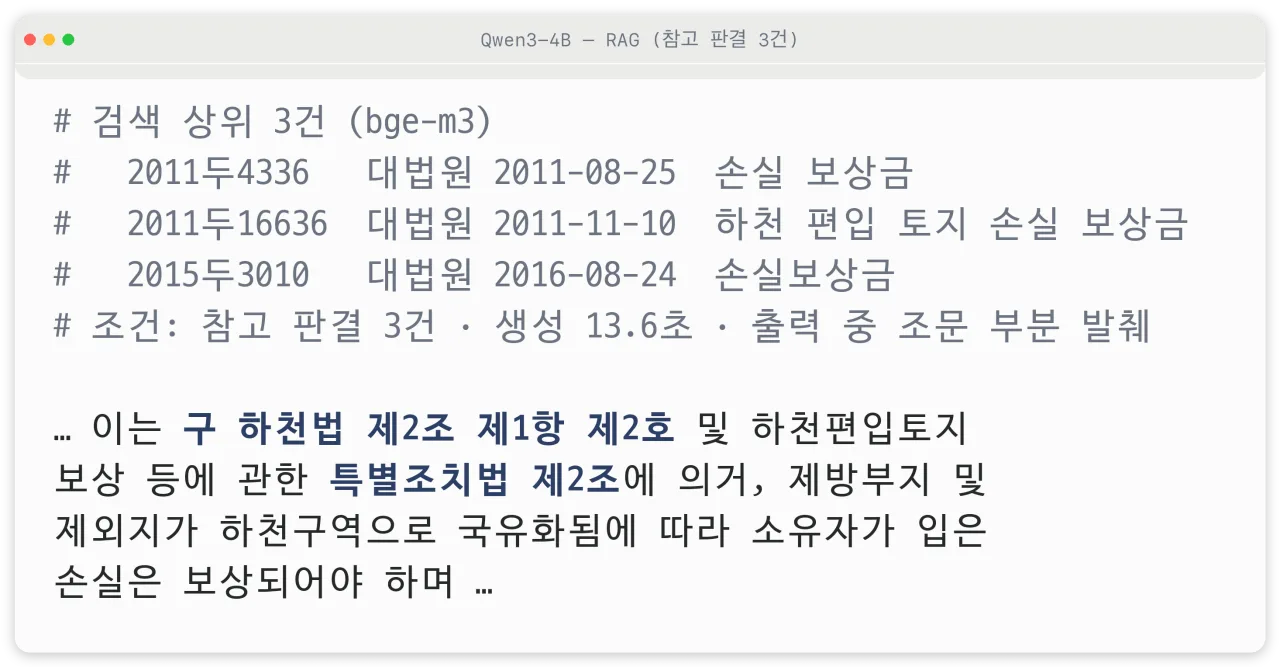 RAG로 쓴 이유 초안 — 출처: Qwen3-4B 실제 출력 · 자가 렌더
참고 판결을 입력하자 실제 참조조문인 구 하천법 제2조와 하천편입토지 보상 등에 관한 특별조치법 제2조를 짚었습니다. 이 쟁점은 학습셋에 판시사항이 거의 같은 판결(2011두4336)이 있어서 검색이 쉬웠던 사례예요.
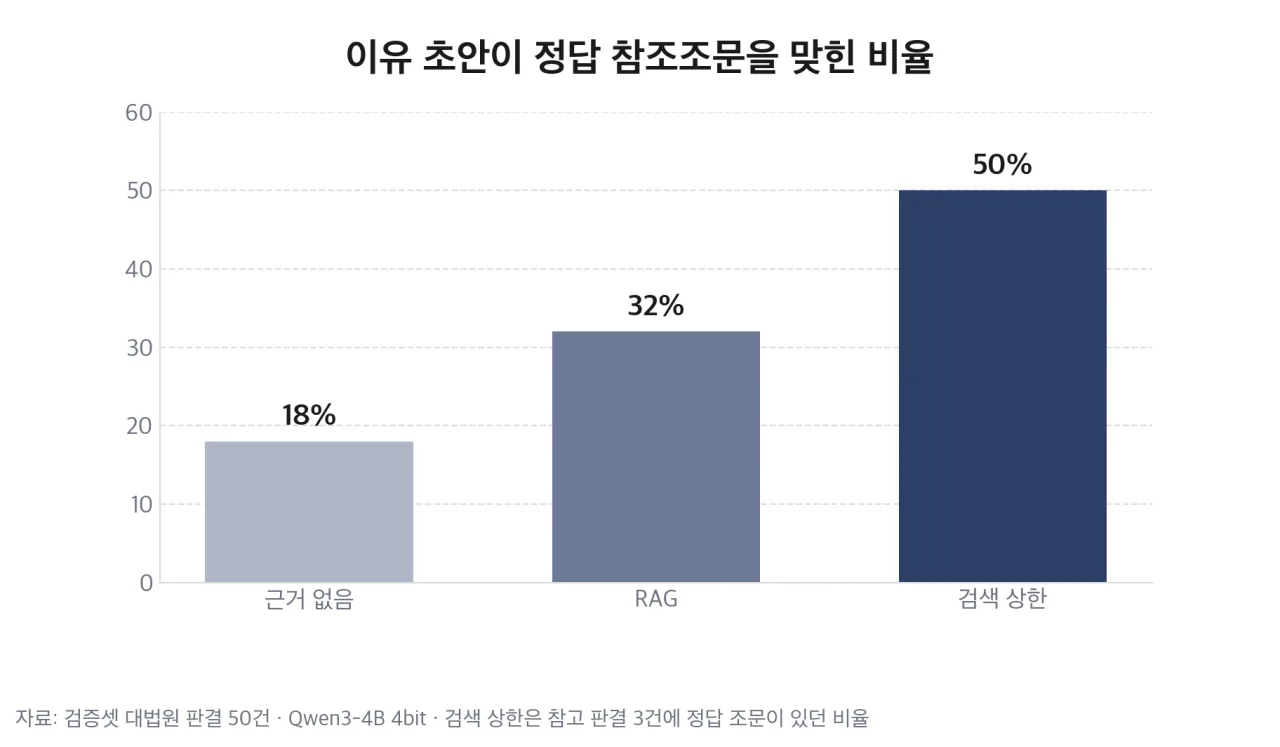 정답 참조조문 적중 비율 — 출처: 직접 측정 · 자가 렌더
| 조건 | 조문 적중 | 조문 없는 초안 | 생성 시간 |
|---|---|---|---|
| 근거 없음 | 9건 | 23건 | 5.8초 |
| RAG | 16건 | 13건 | 15.0초 |
50건 중 RAG에서만 맞힌 쟁점이 8건, 근거 없이만 맞힌 쟁점은 1건이었습니다. 위 예시처럼 판시사항이 거의 같은 판결이 있던 1건을 빼고 49건으로 세도 9건 대 15건이에요.
검색 결과가 상한을 결정합니다. 참고 판결 3건 안에 정답 조문이 들어 있던 쟁점이 50건 중 25건이라, 이 구성에서 RAG가 맞힐 수 있는 최대치는 50%였어요. 두 조건 모두 코퍼스에 없는 사건번호를 인용한 초안은 없었고, 생성 시간은 긴 참고 판결을 처리하느라 RAG가 2.6배 길었습니다.
이용 조건
AI Hub 데이터는 내국인만 신청할 수 있고 승인을 받아야 내려받을 수 있습니다. 데이터 자체는 인공지능 학습용으로만 쓸 수 있고, 이를 활용해 만든 2차 저작물(학습된 서비스·챗봇 등)은 영리·비영리로 활용할 수 있어요.
국외 반출은 별도 합의가 필요합니다. AI Hub 안내에 따르면 해외 서버·클라우드로 전송·저장하거나 그 환경에서 학습하는 것도 국외 반출에 해당해, Colab 같은 해외 클라우드에서는 실행할 수 없어요. 이 실습을 로컬 PC 한 대로 구성한 이유입니다.
데이터를 제3자에게 제공하는 것도 금지돼, 함께 공개하는 노트북에는 데이터가 들어 있지 않습니다. 직접 신청해 받은 폴더 경로를 지정해 로컬 Jupyter에서 실행해요.
노트북 기본값(fp16, 배치 16)으로 같은 M3 Pro에서 1회 돌렸을 때 임베딩은 55.4분, 코퍼스 생성부터 초안 생성까지 전체는 59분이 걸렸습니다.
🔗 링크 첨부 - https://github.com/No1Joon/oh-my-notebooks/blob/main/notebooks/legal-rag-01.ipynb
지금 정리
 1탄 정리 — 출처: 본문 정리 · 자가 렌더
다음 편
- 2탄: 같은 가명 코퍼스로 Qwen3-4B를 LoRA 파인튜닝해 가상 판결문 문체 학습
- 3탄: RAG와 파인튜닝, 둘을 합친 구성의 조문 적중·생성 시간 비교
- 검색 상한 50%를 올리는 방법: 판결요지·참조조문 우선 검색, 하이브리드 검색
참고 출처
- [AI Hub] 판결서 익명처리 데이터 (데이터 구성·구축기관·이용 조건)
- [AI Hub] 데이터 이용정책 (제3자 제공·국외 반출)
- [Hugging Face] BAAI/bge-m3 모델 카드 (공개일·지원 언어·최대 길이·라이선스)
- [arXiv] BGE M3-Embedding (2402.03216)
- [Hugging Face] mlx-community/Qwen3-4B-Instruct-2507-4bit (생성 모델)
- 이 글은 과학기술정보통신부와 한국지능정보사회진흥원의 사업결과로 구축된 AI Hub 판결서 익명처리 데이터를 활용했습니다.