Anthropic이 8월 11일 Claude가 쓴 글에 눈에 보이지 않는 워터마크를 넣겠다고 알렸고, 14일에는 작동 방식을 설명하는 글을 올렸습니다. 숨은 문자나 메타데이터를 붙이는 방식이 아니라 단어를 고르는 과정 자체에 표시를 남기는 방식인데, Anthropic은 이것이 Google DeepMind가 2024년 Nature에 낸 SynthID-Text 방식의 한 버전이라고 적었습니다.
흔히 Claude가 Google 논문으로 워터마크를 만들었다는 말로 퍼졌지만, 만든 주체는 모델이 아니라 회사 Anthropic이고, 원 논문에서 무엇을 바꿨는지는 공개하지 않았습니다. 그래서 공개된 쪽인 원 논문을 읽는 것이 Claude 글에 무엇이 심기는지 알아볼 수 있는 가장 직접적인 방법입니다.
 Nature 논문 Scalable watermarking for identifying large language model outputs 제목·저자·초록 — 출처: Nature / Dathathri et al. (CC BY 4.0, 하이라이트 추가)
Claude 워터마크는 어디서 왔나
Anthropic 설명글의 문장은 짧습니다. Claude’s text watermark is a version of the SynthID-Text approach published by Google DeepMind in a Nature paper in 2024. 같은 계열의 출발점으로는 2022년 Scott Aaronson의 제안을 들고, 이 계열이 공유하는 원리를 단어를 고를 때 쓰는 무작위성의 출처만 바꾼다로 요약했습니다.
 Anthropic 설명글 중 SynthID-Text 방식을 쓴다고 밝힌 문단 — 출처: Anthropic (하이라이트 추가)
Claude 도움말 센터에 정리된 적용 범위를 보면, 2026년 8월 2일 이후 출시된 모델부터 출시와 함께 적용되고, 지금 해당하는 모델은 Fable 5.1과 Mythos 5.1입니다. 그 전에 나온 모델은 몇 달에 걸쳐 순차 적용하며, Claude 앱·API·Claude Code·Claude Cowork·Claude Tag와 AWS·Google Cloud·Microsoft Foundry를 거친 호출까지 전 세계에 똑같이 붙습니다.
이미지 파일(.png·.jpg·.svg)은 방식이 달라요. 파일 메타데이터에 C2PA 표준의 서명된 출처 정보를 붙이는 것이고, Anthropic도 이것은 워터마크와는 별개 방식이라고 밝혔습니다.
탐지 API는 비공개 프리뷰예요. 규제 기관·수사 기관·언론·팩트체커·연구자·교육 기관·EU 시민단체, 그리고 EU 규정 준수 의무가 있는 기업이 신청 대상이고, 일반 사용자가 붙여 넣어 확인하는 공개 도구는 없습니다. 배경에는 Anthropic을 포함해 약 190곳이 7월에 서명한 EU의 AI 생성 콘텐츠 투명성 행동강령이 있습니다.
바탕 논문의 원문 제목은 Scalable watermarking for identifying large language model outputs이고, 대형 언어 모델이 쓴 글을 가려내는 워터마크를 규모 있게 운영하는 방법이라는 뜻입니다.
| 항목 | 내용 |
|---|---|
| 저널 | Nature 634권 |
| 온라인 게재 | 2024년 10월 23일 |
| 저자 | Google DeepMind·Google 24명 |
| 교신저자 | Sumanth Dathathri·Pushmeet Kohli |
| 논문 유형 | 실험 논문 (Gemini 실서비스 실험 포함) |
| 공개 | 오픈 액세스, CC BY 4.0 |
논문이 짚은 문제, 기존 판별법은 왜 부족했나
논문은 AI가 쓴 글을 가려내는 기존 방법을 세 갈래로 나눕니다. 모든 생성물을 저장해 두고 대조하는 검색 방식은 모든 대화를 보관해야 해 개인정보 문제가 생기고, 글의 통계적 특징으로 판별하는 사후 탐지기는 학습하지 않은 분야의 글에서 성능이 떨어지며 비원어민이 쓴 글을 AI 글로 잘못 짚는 경향이 보고됐습니다.
세 번째가 워터마크예요. 그중 이 논문이 다루는 것은 글을 만드는 순간에 표시를 심는 생성 워터마크(generative watermarking)로, 모델 학습은 건드리지 않고 다음 단어를 뽑는 단계만 바꿉니다. 저자들은 이 방식이 품질·탐지력·연산 효율 요구가 까다로워 그때까지 실서비스에 들어간 적이 없다고 초록에 적었습니다.
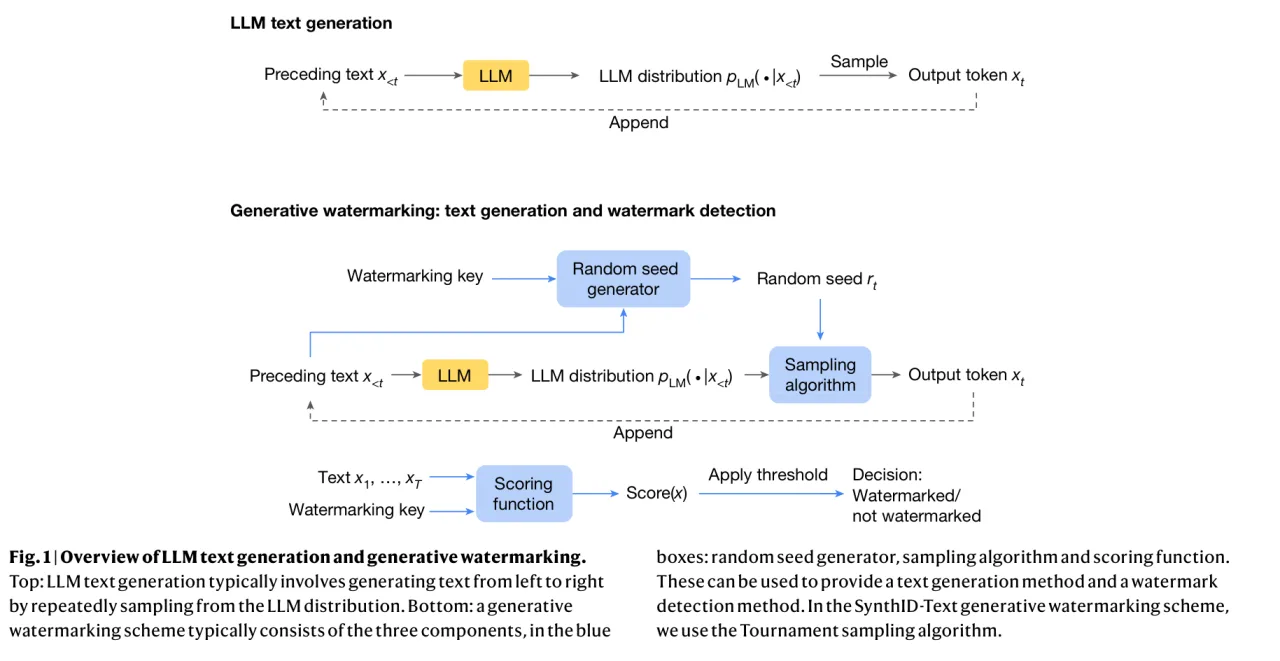 일반 LLM 생성 과정과 생성 워터마크의 구성 요소 셋(시드 생성기·샘플링 알고리즘·점수 함수)을 비교한 Fig. 1 — 출처: Nature / Dathathri et al. (CC BY 4.0)
언어 모델은 앞 문장을 보고 다음에 올 토큰(token), 곧 단어나 단어 조각마다 확률을 매긴 뒤 그 확률대로 하나를 뽑습니다. 이 뽑기에는 원래 무작위 수가 쓰이는데, 생성 워터마크는 그 무작위 수를 비밀 키와 앞 문맥으로 정해지는 값으로 바꿔요. 그러면 뽑힌 단어와 그 값 사이에 상관관계가 생기고, 키를 가진 쪽은 나중에 그 상관관계를 재서 워터마크 여부를 판단합니다.
구성 요소는 셋이에요. 키와 앞 문맥으로 무작위 값을 만드는 시드 생성기, 그 값을 써서 실제로 단어를 고르는 샘플링 알고리즘, 완성된 글에서 상관관계를 재는 점수 함수입니다. SynthID-Text가 새로 내놓은 것은 이 중 가운데 요소입니다.
논문이 내놓은 답, 토너먼트 샘플링
시드는 기존 방식을 그대로 써요. 바로 앞 토큰 4개와 워터마크 키를 해시해 이번 자리의 무작위 값을 만들고(논문 표기 H = 4), 이 값으로 g 함수 여러 개가 후보 단어마다 0 또는 1을 매깁니다. g값은 반반 확률로 나오도록 설계돼 있어서, 워터마크가 없는 글이라면 평균이 0.5 근처에 머뭅니다.
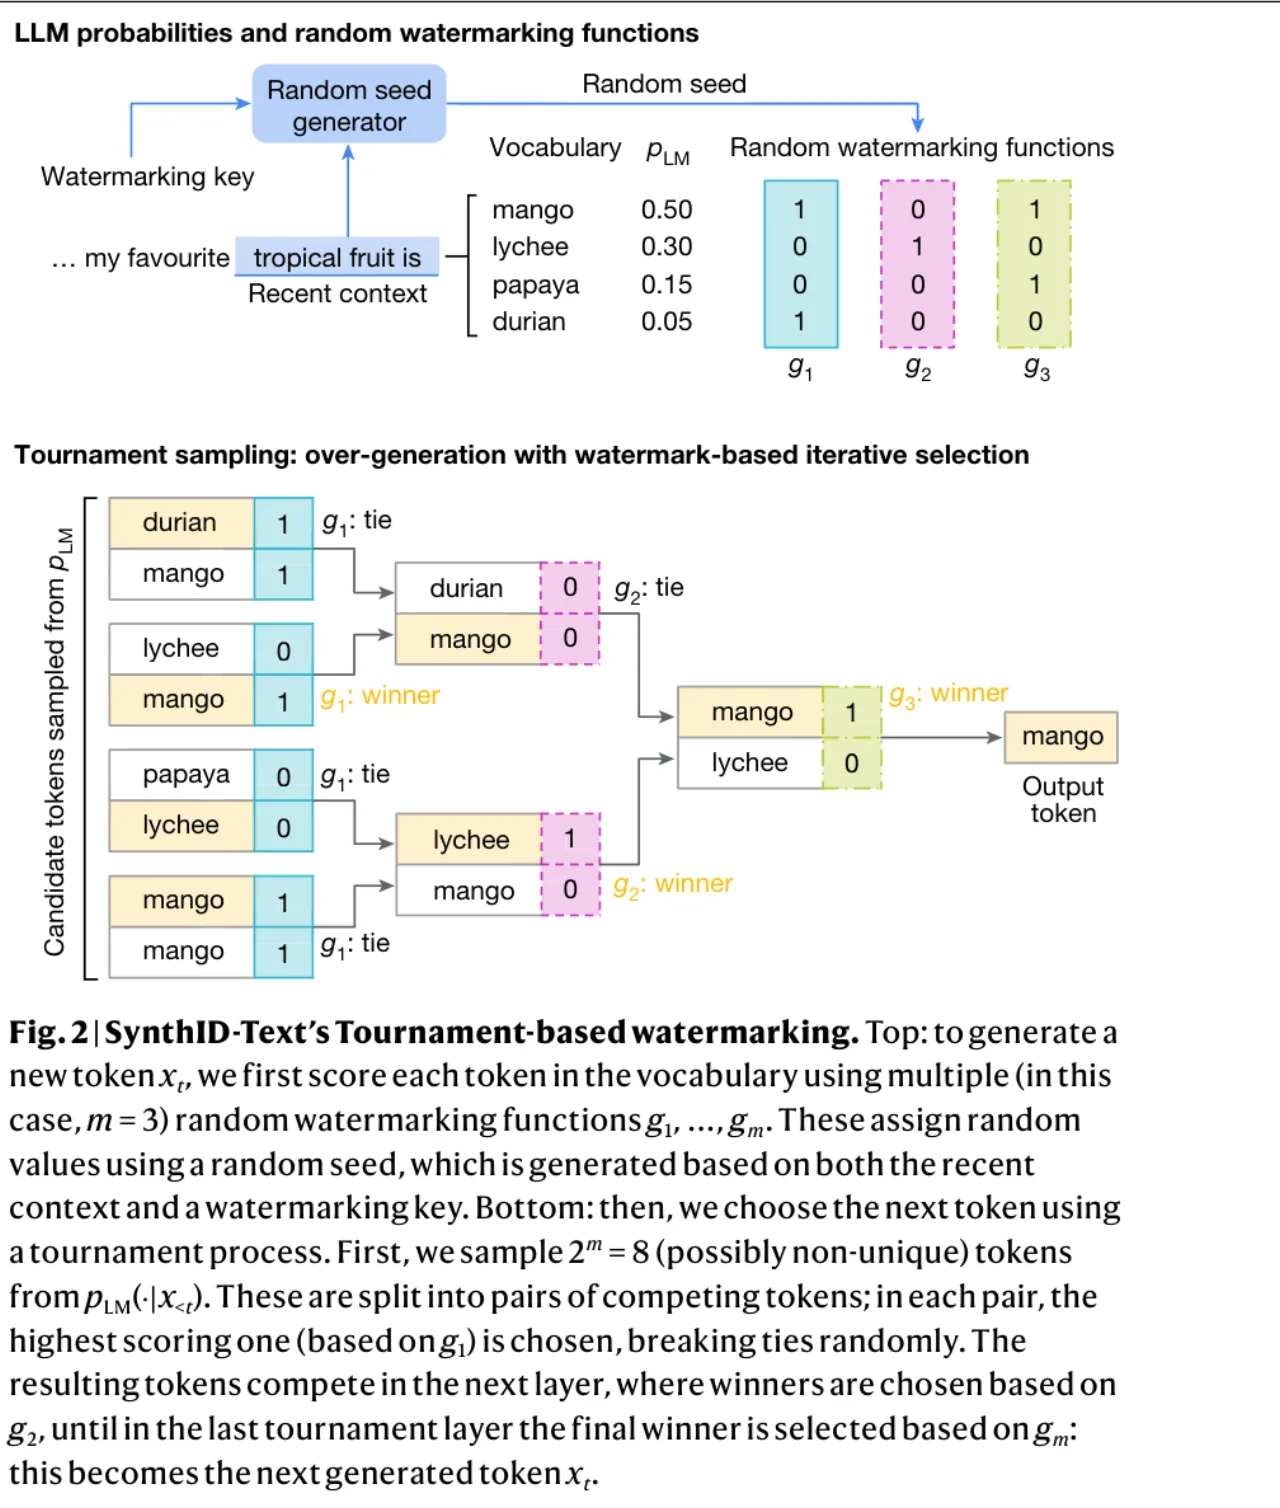 토너먼트 샘플링 예시 Fig. 2, 망고·리치·파파야·두리안 후보가 g1~g3로 겨뤄 망고가 남는 과정 — 출처: Nature / Dathathri et al. (CC BY 4.0)
고르는 과정이 토너먼트예요. 모델의 확률 분포에서 후보를 여러 개 뽑아 두 개씩 짝을 짓고, 첫 판에서는 g1값이 높은 쪽이, 둘째 판에서는 g2값이 높은 쪽이 올라가며, 동점이면 무작위로 정합니다. 마지막 판까지 살아남은 단어가 실제로 출력됩니다.
논문 그림의 예에서 my favourite tropical fruit is 다음 자리는 망고 확률이 0.50, 리치 0.30, 파파야 0.15, 두리안 0.05예요. 층을 3개(m = 3) 두면 후보 8개를 뽑아 세 판을 치르고, 이 예에서는 망고가 남습니다. 실험 기본값은 30층입니다.
요점은 후보가 모두 모델이 원래 뽑았을 법한 단어라는 데 있어요. 한 판에 두 후보만 겨루게 하면 수학적으로 단어 하나의 출력 확률은 평균적으로 원래 분포와 같게 유지되고, 논문은 이 성질을 non-distortionary(분포를 바꾸지 않는)라고 부릅니다. 같은 문맥 4토큰이 한 응답 안에서 다시 나오면 그 자리에는 워터마크를 걸지 않는 repeated context masking을 더해, 응답 한 편 단위로도 원래 분포를 지키게 했습니다.
탐지력을 더 원하면 한 판에 세 후보 이상을 겨루게 하는 distortionary 설정도 있습니다. 탐지는 잘되지만 글이 원래 분포에서 조금 벗어나고, Gemini에 들어간 것은 분포를 바꾸지 않는 쪽입니다.
층을 늘리면 단어 하나에 담기는 증거가 늘지만 끝없이 늘지는 않는다고 저자들은 적었습니다. 층마다 모델 분포의 여유(엔트로피)를 조금씩 쓰기 때문에 뒤쪽 층일수록 표시가 약해집니다.
탐지는 모델 없이 점수로
가장 단순한 점수는 글 전체의 모든 자리, 모든 층에서 나온 g값의 평균입니다. 워터마크를 건 글은 g값이 높은 단어가 토너먼트에서 이겨 왔으니 평균이 0.5보다 높게 나오고, 이 값을 기준선과 비교해 판정합니다. 필요한 것은 글과 워터마크 키, 시드 생성기뿐이라 원래 언어 모델을 다시 돌리지 않습니다.
논문은 평균 점수 말고도 층마다 가중치를 다르게 주는 가중 평균, 워터마크 글과 일반 글을 학습해 확률을 내는 베이지안 점수 함수를 함께 제안했습니다. Hugging Face에 공개된 구현도 탐지기로 이 베이지안 방식을 쓰고, 학습에 워터마크 글과 일반 글을 합쳐 최소 1만 건을 권합니다.
탐지 성능을 좌우하는 것은 둘로, 글이 길수록 증거가 쌓이고 모델이 다음 단어를 고를 여유가 클수록 표시를 넣을 자리가 늘어납니다. 답이 거의 정해진 사실 문장이나 코드처럼 선택지가 좁은 글에서는 표시가 적게 들어갑니다.
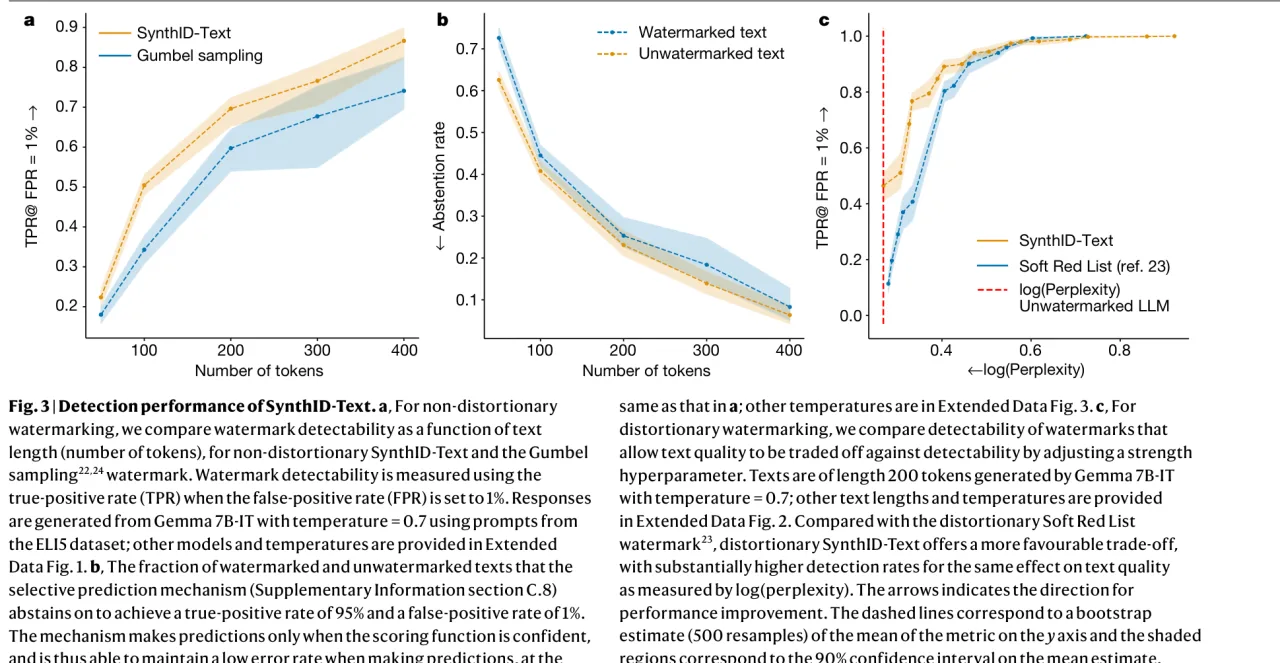 글 길이별 탐지율(a), 판정 보류 비율(b), 품질과 탐지력 교환(c)을 보인 Fig. 3 — 출처: Nature / Dathathri et al. (CC BY 4.0)
성능은 오탐률(FPR)을 1%로 묶었을 때의 탐지율(TPR)로 쟀어요. 사람이 쓴 글 100편 중 1편만 AI 글로 잘못 짚도록 기준선을 잡았을 때 워터마크 글을 몇 편이나 잡아내는지를 뜻합니다. 조건은 Gemma 7B-IT, 온도 0.7, 설명형 질문 모음인 ELI5입니다.
| 글 길이 (토큰) | SynthID-Text | Gumbel 샘플링 |
|---|---|---|
| 100 | 약 0.50 | 약 0.34 |
| 200 | 약 0.70 | 약 0.60 |
| 400 | 약 0.87 | 약 0.74 |
주: 값은 Fig. 3a 그래프를 읽은 근삿값입니다. 논문은 이 수치를 표로 따로 싣지 않았습니다.
100토큰이면 한국어 기준 짧은 문단 한두 개 분량인데, 이 길이에서는 워터마크 글의 절반만 잡힙니다. 그래서 논문은 점수가 애매한 글에는 판정을 보류하는 방식도 함께 보였고(Fig. 3b), 탐지율 95%와 오탐률 1%를 동시에 맞추려면 100토큰에서는 워터마크 글의 약 40%를 보류해야 하지만 400토큰에서는 약 7%로 줄어듭니다. Anthropic이 짧은 글에서는 탐지가 잘 안 된다고 적은 것도 같은 이유입니다.
품질과 속도, 숫자로 보면
논문에서 가장 큰 실험은 실서비스입니다. Gemini(당시 Bard)로 들어온 요청 일부를 워터마크 모델로, 같은 수를 워터마크 없는 모델로 보내 약 2,000만 건의 응답에 달린 좋아요·싫어요 비율을 비교했습니다.
| 지표 | 워터마크 모델과의 차이 |
|---|---|
| 좋아요 비율 | 0.01% (워터마크 쪽이 높음) |
| 싫어요 비율 | 0.02% (워터마크 쪽이 낮음) |
| 통계적 유의성 | 없음 (95% 신뢰구간 안) |
평가자가 두 응답을 나란히 놓고 고르는 통제 실험에서도 문법·일관성·관련성 등 다섯 항목 모두 선호 차이가 없었고, 이 결과를 근거로 SynthID-Text는 Gemini와 Gemini Advanced 응답에 실제로 적용됐습니다.
속도 비용도 작습니다. TPU v5e 4개로 돌린 Gemma 7B-IT는 토큰 하나를 만드는 데 15.527ms가 걸렸고, 30층 토너먼트 샘플링을 켜면 15.615ms가 됐습니다.
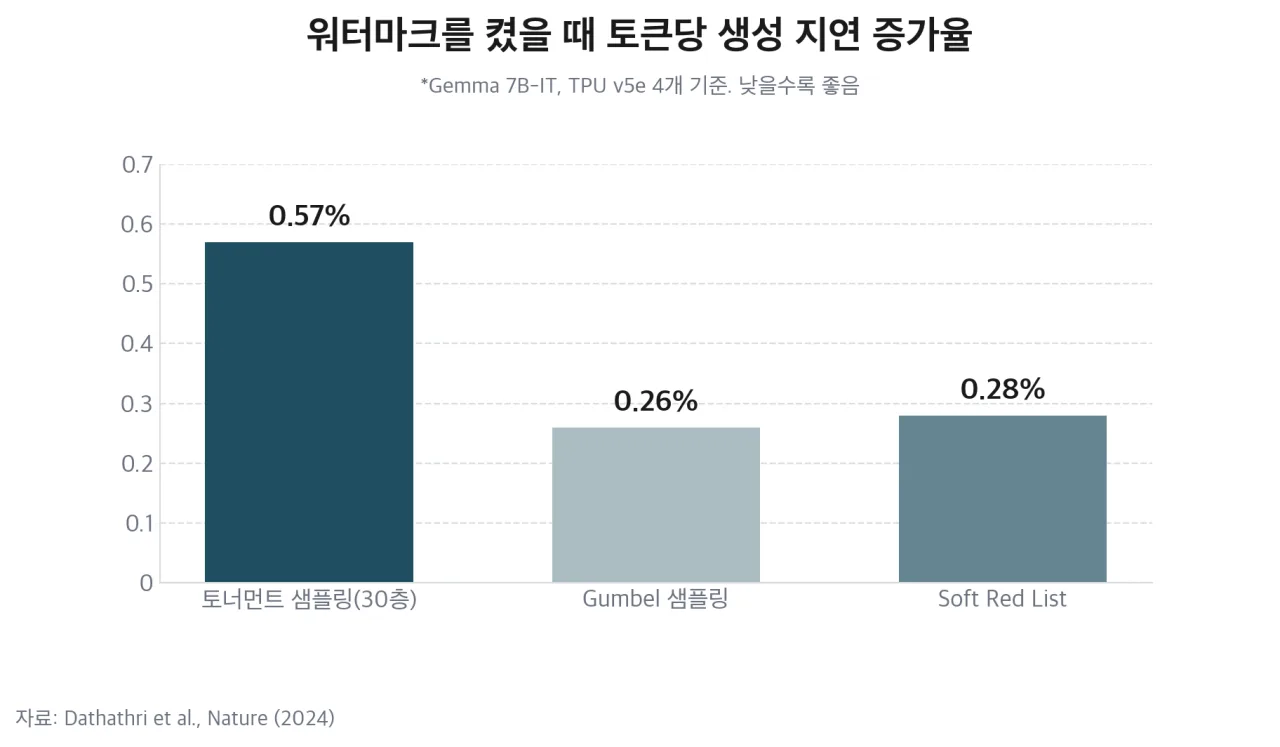 워터마크 방식별 토큰당 생성 지연 증가율 막대 차트 — 출처: Dathathri et al., Nature (2024) 기반 자가 렌더
토너먼트 샘플링은 비교 대상보다 두 배 남짓 느리지만 차이는 0.3%포인트 안쪽이고, 저자들은 모델이 커질수록 샘플링 단계가 차지하는 몫은 더 작아진다고 설명합니다.
작은 모델이 초안을 먼저 쓰고 큰 모델이 검사하는 가속 기법인 speculative sampling과 워터마크를 함께 쓰는 알고리즘도 이 논문이 따로 제안했는데, 실서비스에 넣으려면 이 결합이 필요했기 때문입니다.
Anthropic의 설명도 같은 방향이에요. 워터마크 때문에 추가 토큰이 생기지 않아 가격이 같고, 속도 영향은 무시할 만하며, 내부 테스트에서 내용·창의성·가독성 차이가 없었다고 밝혔습니다. 다만 Anthropic은 자체 측정 수치를 공개하지 않았고, 품질 근거로 이 논문의 Gemini 실험을 인용했습니다.
Claude 버전은 원 논문과 어디가 같고 다른가
Anthropic은 원 논문 대비 바꾼 점을 밝히지 않았습니다. 설명글에서 확인되는 것은 키와 앞에 온 단어 몇 개로 이번에 고를 단어를 정한다는 원리 수준이고, 층 수·문맥 길이·점수 함수·오탐률 같은 설정값은 나오지 않습니다.
| 항목 | 원 논문 | Claude |
|---|---|---|
| 시드 | 직전 4토큰 + 키 | 직전 단어 몇 개 + 키 |
| 층 수 | 기본 30층 | 비공개 |
| 점수 함수 | 평균·베이지안 등 | 비공개 |
| 품질 검증 | Gemini 약 2,000만 응답 | 내부 테스트, 수치 비공개 |
| 추가 토큰 | 없음 | 없음 |
| 탐지 수단 | 공개 구현(Transformers) | 비공개 프리뷰 API |
같은 것은 원리예요. Anthropic이 적은 한계는 논문이 적은 한계와 거의 겹칩니다. 짧은 글에서는 잘 안 잡히고, 사실 위주 문단과 코드에는 표시가 드물게 들어가며, 가볍게 고친 글에는 남지만 모든 단어를 새로 쓰면 사라진다고 했습니다.
 생성된 단어 조각들 중 일부에만 같은 규칙의 표시가 섞여 있고 렌즈로만 보이는 개념 컷 — 출처: 개념 컷 · agy 자가 생성
Anthropic이 못 한다고 밝힌 것도 있어요. 워터마크는 사람이 쓴 글을 가려내지 못하고, 다른 AI가 쓴 글과 워터마크 없는 글을 구분하지 못합니다. 표시가 나와도 Claude를 거쳤을 수 있다는 뜻일 뿐 Claude가 원저자라는 증거가 아니고, 표시가 없다고 AI가 쓰지 않았다는 뜻도 아니라고 도움말 센터에 적혀 있습니다.
번역은 방향에 따라 달라요. Anthropic은 Claude가 번역한 글에는 워터마크가 들어간다고 했는데, 번역문의 단어를 전부 Claude가 골랐기 때문입니다. 반대로 Claude가 쓴 글을 다른 번역기로 옮기면 단어를 고른 주체가 바뀌어 표시가 흐려지고, Hugging Face의 SynthID-Text 안내도 철저히 고쳐 쓰거나 다른 언어로 옮긴 글에서는 탐지 신뢰도가 크게 떨어진다고 적었습니다.
저자가 남긴 숙제, 그리고 외부 검증
저자들이 한계 절에 직접 적은 것은 넷입니다.
[서비스마다 따로 걸어야 한다] 워터마크를 걸지 않은 서비스가 만든 글은 잡을 수 없어 사후 탐지 같은 다른 방법이 여전히 필요함
[오픈소스 모델에는 강제하기 어렵다] 각자 내려받아 돌리는 모델에는 워터마크를 켜 두라고 요구할 방법이 없음
[탈취·위조·제거 공격] stealing·spoofing·scrubbing 공격에 약하다는 점을 인정하고 연구가 진행 중이라고 적음
[의역하면 약해진다] LLM으로 의역하면 표시가 약해지되, 그 경우 대개 글 자체도 크게 바뀐다고 덧붙임
저자들은 SynthID-Text를 AI 글 판별의 완결된 해법이 아니라 다른 방법을 보완하는 수단으로 규정했고, 의역과 편집에 대한 수치는 본문이 아니라 보충 자료에 두었습니다.
외부 연구자들은 공개 구현을 직접 공격해 봤습니다. 캐나다 퀸스대 연구진은 13억 개 파라미터 모델 Sheared-LLaMA-1.3B에 SynthID-Text를 걸고, 뜻은 지키면서 겉모양을 바꾸는 공격 네 가지를 시험했습니다.
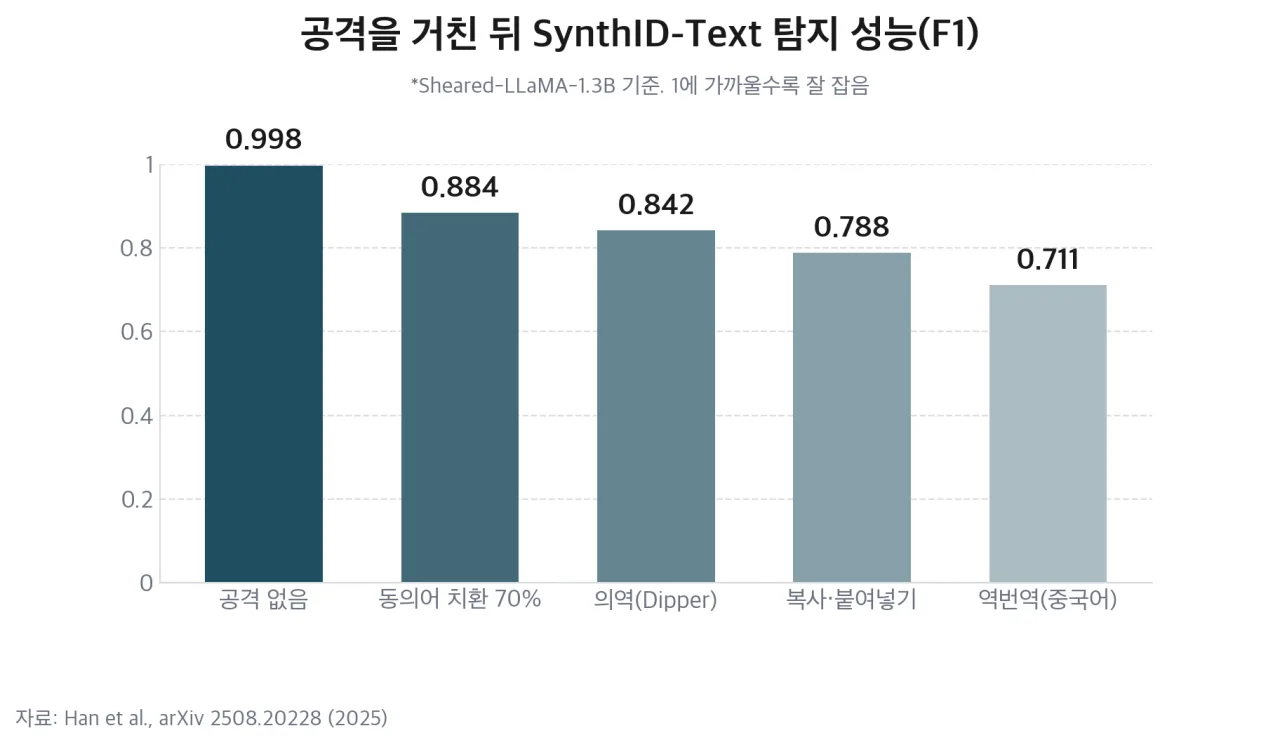 공격 종류별 SynthID-Text 탐지 F1 막대 차트 — 출처: Han et al., arXiv 2508.20228 (2025) 기반 자가 렌더
F1은 잡아낸 비율과 잘못 짚지 않은 비율을 함께 반영한 점수로, 1이면 완벽합니다. 공격이 없을 때 0.9975였고 단어 70%를 문맥에 맞는 동의어로 바꿔도 0.884를 유지했지만, 중국어로 옮겼다가 영어로 되돌리는 역번역에서는 0.711까지 떨어졌어요. 복사·붙여넣기 공격은 워터마크 글 사이에 사람 글을 섞는 방식인데, 워터마크 글 길이의 10배만큼 사람 글을 덧붙였을 때 오탐률이 0.53까지 올라 사람 글 절반 이상을 AI 글로 짚었습니다.
역번역은 경유 언어에 따라 달랐어요. 이탈리아어는 0.813, 프랑스어는 0.738, 일본어는 0.819로 가장 높았고, 한국어는 시험하지 않았습니다. 연구진은 번역 품질이 낮을수록 표시가 더 흐려진다는 상관관계도 보고했습니다.
다른 두 연구도 결과가 같은 방향이에요. 취리히 연방공대 SRI 연구실은 2024년 12월, 시중의 의역 모델만 써도 SynthID-Text의 탐지를 90% 넘게 피할 수 있다고 발표했습니다. 일리노이 공대 연구진은 2026년 3월 논문에서 평균 점수를 쓰면 층을 덧붙이는 공격으로 탐지율이 약 88%에서 13%로 떨어지지만, 베이지안 점수 함수에는 이 약점이 없다고 증명했습니다.
제 관점을 덧붙이면, 세 연구 모두 공개 구현을 작은 모델에 걸어 시험한 것이라 Claude에 그대로 옮길 수는 없습니다. Claude가 어떤 점수 함수를 쓰는지에 따라 일리노이 공대가 짚은 약점이 해당하는지부터 갈리는데, 탐지기와 설정이 공개되지 않아 지금은 외부에서 검증할 방법이 없습니다.
국내에는 무슨 의미인가
2026년 1월 22일 시행된 AI 기본법은 생성형 AI 결과물에 AI가 만들었다는 표시를 요구해요. 딥페이크는 사람이 알아볼 수 있는 표시만 허용하지만, 그 밖의 생성물은 기계가 읽는 워터마크나 메타데이터로도 표시할 수 있고, 텍스트도 외부로 나가 유통되면 대상입니다.
| 구분 | 허용되는 표시 |
|---|---|
| 딥페이크 | 사람이 인식하는 가시적 표시만 |
| 그 밖의 생성물 | 가시적 표시 또는 기계 판독 방식 |
| 서비스 안에서만 쓰는 결과물 | 화면 안내·로고 표출 등 |
Claude 텍스트 워터마크는 이 중 기계 판독 방식에 해당하는 형태예요. 국내 기업이 Claude API로 만든 서비스라면 8월 이후 출시 모델의 출력에는 이미 표시가 섞여 나오지만, 이것을 AI 기본법상 표시로 인정할지에 대한 과학기술정보통신부의 해석은 확인되지 않았고, 과태료는 1년 이상의 계도 기간 동안 매기지 않습니다. 탐지 권한이 Anthropic에 있고 서비스 운영자가 직접 확인할 수 없다는 점도 법이 말하는 표시와 성격이 다릅니다.
교육 현장에서 기대하는 과제 판별과도 거리가 있습니다. 교육 기관은 탐지 API 신청 대상에 들어 있지만 비공개 프리뷰라 교사 개인이 쓸 수 있는 도구는 아니고, 과제 분량의 짧은 글에서는 논문 기준으로도 탐지율이 절반 수준입니다.
한국어 성능은 따로 확인되지 않았습니다. 논문 본문은 여러 언어에서 일관되게 작동한다고만 적고 세부는 보충 자료로 넘겼으며, 역번역 실험의 경유 언어에도 한국어는 없었습니다.
앞으로 볼 것
첫째는 탐지 API가 누구에게 열리는가입니다. 신청 대상 목록에 지역 제한은 EU 시민단체에만 붙어 있어서 국내 언론·연구 기관이 받을 수 있는지가 첫 확인 지점입니다.
둘째는 설정값 공개입니다. Claude가 쓰는 점수 함수와 오탐률이 나와야 외부 연구가 Claude 버전을 두고 검증할 수 있습니다.
셋째는 호환성입니다. 같은 행동강령에 서명한 다른 AI 기업도 각자 워터마크를 넣기로 했는데, 탐지에는 회사마다 다른 키가 필요해서 한 도구로 여러 회사의 글을 한꺼번에 확인할 방법은 아직 없습니다.
정리
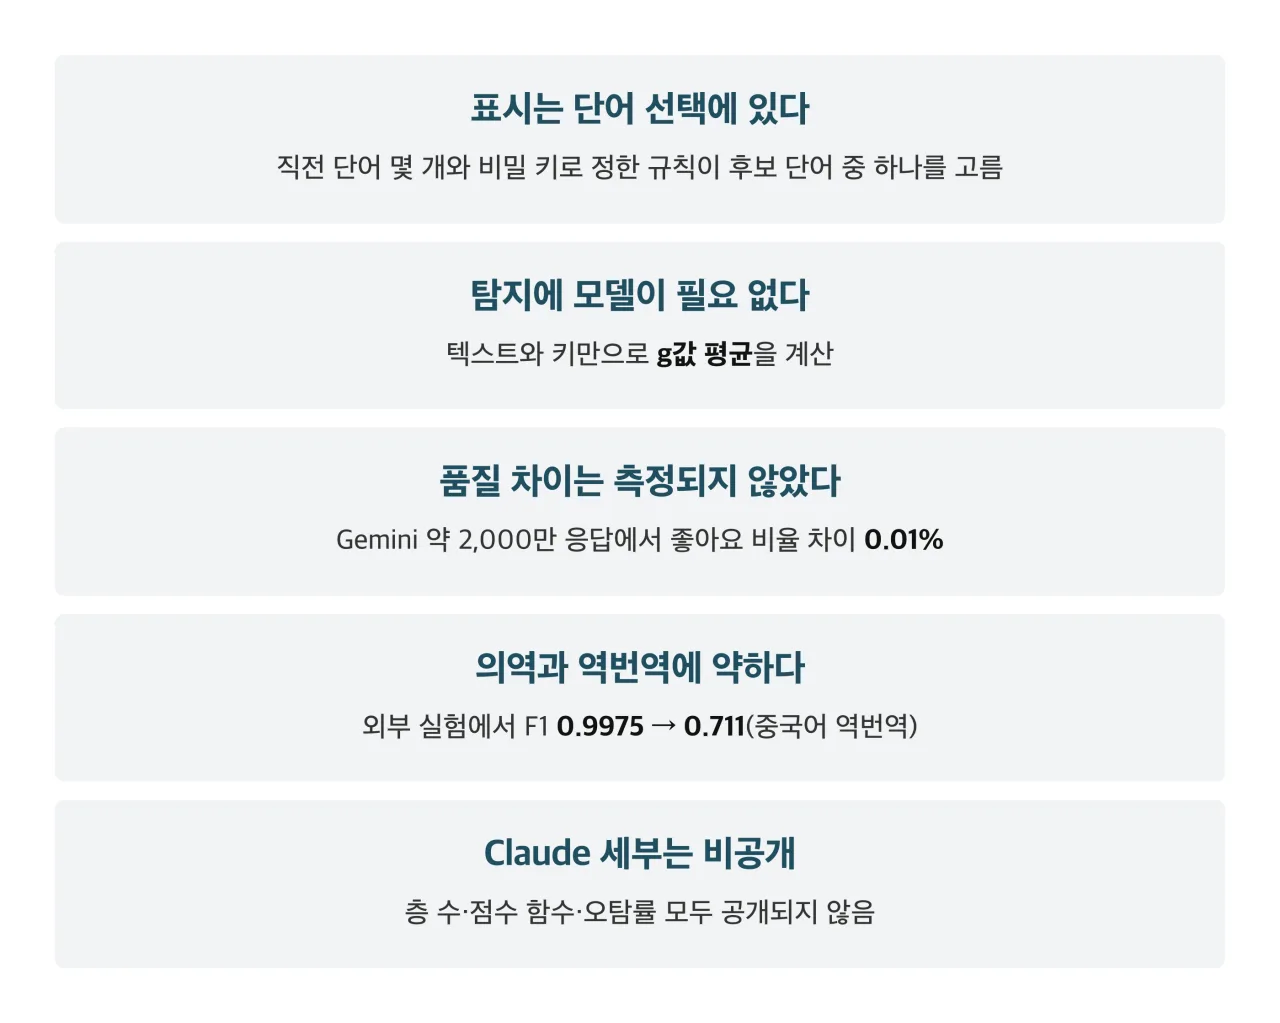 Claude 텍스트 워터마크와 SynthID-Text 정리 카드 — 출처: Dathathri et al. (2024)·Anthropic·Han et al. (2025) 기반 자가 렌더
Claude의 표시는 원 논문이 설계한 대로 단어 선택의 통계에 들어 있어서, 긴 글을 Claude가 그대로 쓴 경우에 가장 잘 잡히고 짧은 글이나 다른 도구로 다시 쓴 글에서는 약해집니다.
참고 출처
- [Nature] Dathathri et al., Scalable watermarking for identifying large language model outputs (2024, 본문 이미지 4점 출처)
- [Anthropic] How Claude’s text watermarking works (2026-08-14, 적용 방식·한계)
- [Claude Help Center] How Claude marks AI-generated content (적용 모델·제품·탐지 신청 대상)
- [TechCrunch] Anthropic shares more details about how Claude’s new watermarks will work (2026-08-15)
- [Hugging Face] SynthID Text 공개 구현 안내 (Transformers 4.46.0, 탐지기 학습 조건)
- [arXiv] Han et al., Robustness Assessment and Enhancement of Text Watermarking for Google’s SynthID (2025, 공격별 F1 차트 출처)
- [arXiv] Omidi et al., On Google’s SynthID-Text LLM Watermarking System (2026, 층 덧붙이기 공격)
- [ETH Zurich SRI Lab] Probing Google DeepMind’s SynthID-Text Watermark (2024-12-20)
- [대한민국 정책브리핑] 인공지능기본법 시행, 생성형 AI 결과물 워터마크 표시 의무