OpenAI가 2026년 9월 22일 GPT-6 Sol과 GPT-6 Luna를 공개했습니다. 9월 초 나온 GPT-6 Astra의 하위 등급인 두 모델로, Sol은 코딩처럼 복잡한 작업을, Luna는 목표가 분명한 대량 작업을 맡아요.
API 요금은 GPT-5.6 할인가보다 50% 인하됐습니다. GPT-6 Sol의 100만 토큰당 출력 요금은 14,000원(10달러)으로, 같은 날 90분 먼저 출시된 Anthropic Claude Opus 5.5의 절반이에요.
 GPT-6 Sol and Luna 공식 발표 키 비주얼 — 출처: OpenAI
발표 요지
OpenAI는 두 모델을 GPT-6 Astra와 비슷한 방법으로 학습해, 업무 처리·사실 정확도·코딩·컴퓨터 조작·정렬(alignment)에서 Astra가 이룬 개선을 더 빠르고 싼 모델에도 적용했다고 설명했습니다. 요금 인하는 캐싱과 추론(inference) 효율을 높여 서빙 비용이 줄어든 결과라고 밝혔어요.
- 요금: Sol 입력 2,800원·출력 14,000원, Luna 입력 140원·출력 700원 (100만 토큰당)
- 사실 정확도: 사용자가 오류를 신고한 대화로 만든 내부 평가에서 Sol의 오류가 GPT-5.6 Sol의 약 절반
- 코딩: DeepSWE v1.1에서 Sol 68.8%, Claude Fable 5 최고점(69.9%)과 1.1%포인트 차이
- 제공처: ChatGPT Work·Codex(Plus·Pro·Business·Enterprise·Edu), API, GitHub Copilot
- 무료 이용: Free·Go 사용자는 데스크톱 앱에서 Luna만 사용 가능
- 최고 성능 모델: 여전히 GPT-6 Astra
Sol과 Luna의 차이
 Sol과 Luna의 역할 분담 개념 컷 — 출처: 개념 컷 · agy 자가 생성
OpenAI는 Sol을 코딩 같은 복잡한 작업에, Luna를 문서 요약·정보 추출·짧은 질문처럼 목표가 분명한 대량 작업에 권합니다. 두 모델 모두 텍스트와 이미지를 입력받아 텍스트를 출력하고, 추론 강도(reasoning effort)는 none·low·medium·high·xhigh·max 여섯 단계이며 기본값은 medium이에요.
| 항목 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| 권장 용도 | 코딩·복잡한 작업 | 요약·추출·짧은 질문 |
| 입력 (100만 토큰) | 2,800원 | 140원 |
| 캐시 입력 (100만 토큰) | 280원 | 14원 |
| 출력 (100만 토큰) | 14,000원 | 700원 |
| 컨텍스트 윈도 | 105만 토큰 | 105만 토큰 |
| 학습 데이터 기준일 | 2026-04-20 | 2026-05-18 |
| Free·Go 요금제 | 미제공 | 데스크톱 앱 |
컨텍스트 윈도(context window, 한 번에 받는 입력 길이)는 둘 다 105만 토큰이고 최대 출력은 12만 8,000토큰입니다. Luna는 이 가운데 입력을 최대 92만 2,000토큰까지 받아요. 학습 데이터 기준일은 Luna가 한 달가량 늦습니다.
OpenAI에 따르면 Luna는 높은 추론 강도에서 사실 정확도가 GPT-5.6 Sol과 같고 비용은 약 100분의 1이며, DeepSWE에서는 max 설정으로 66.6%를 기록해 medium 설정의 Claude Opus 5·Fable 5와 비슷했어요.
요금
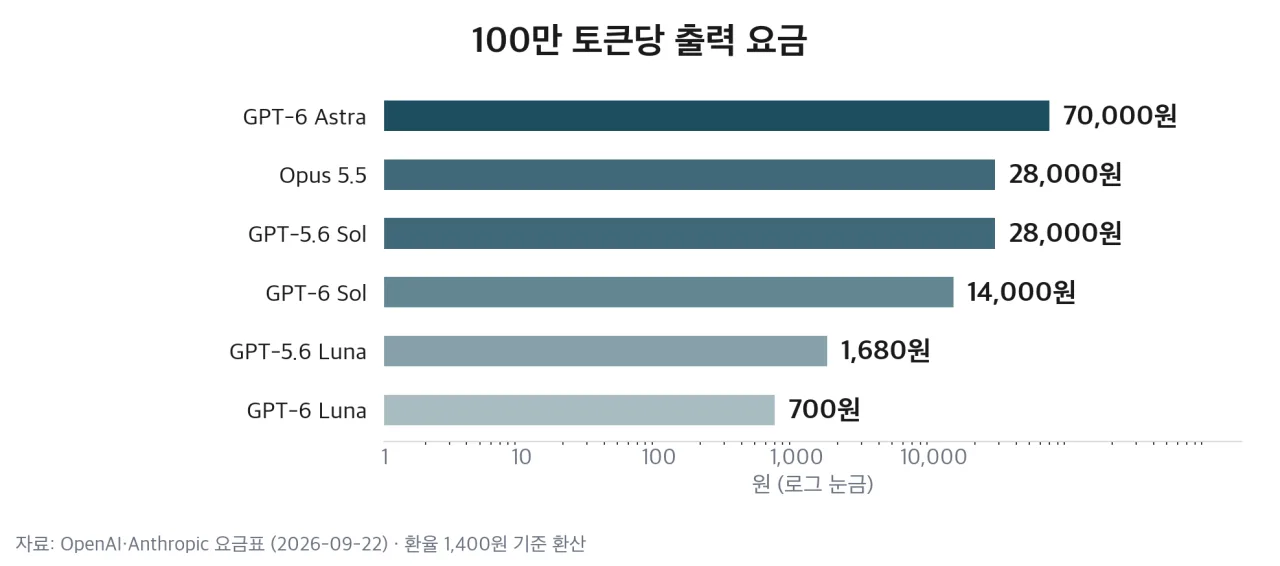 모델별 100만 토큰당 출력 요금 — 출처: OpenAI·Anthropic 요금표 기반 자가 렌더
출력 요금 기준으로 GPT-6 Astra는 Sol의 5배, Sol은 Luna의 20배입니다. Sol의 입력·출력 요금(2달러·10달러)은 같은 날 나온 Claude Opus 5.5(4달러·20달러)의 정확히 절반이에요.
- 캐시 입력: 기본 입력의 10%, Sol 280원·Luna 14원
- Luna 캐시 쓰기: 100만 토큰당 175원(0.125달러)
- Batch·Flex: 표준 요금의 50%
- Fast mode: 해당 요금의 2배
인하 기준은 GPT-5.6 정가가 아니라 할인가입니다. GPT-5.6 Sol은 입력 5,600원(4달러)·출력 28,000원(20달러), GPT-5.6 Luna는 입력 280원(0.20달러)·출력 1,680원(1.20달러)에서 내려왔어요.
OpenAI는 GPT-6의 기본 캐시 적중률을 높였고, 대화 중에 추론 강도를 바꾸거나 도구를 켜고 꺼도 앞선 캐시가 유지되게 했어요. 캐시 구간이 끝나는 지점을 개발자가 직접 정하는 명시적 중단점(explicit breakpoints)과 캐싱 대시보드·진단 도구도 함께 나왔습니다. GitHub는 이 개선으로 새로 처리해야 하는 프롬프트 토큰 비율이 50% 넘게 줄었다고 밝혔어요.
API 요금은 달러로 청구돼, 국내 사용자의 원화 부담은 환율에 따라 달라집니다.
벤치마크 수치
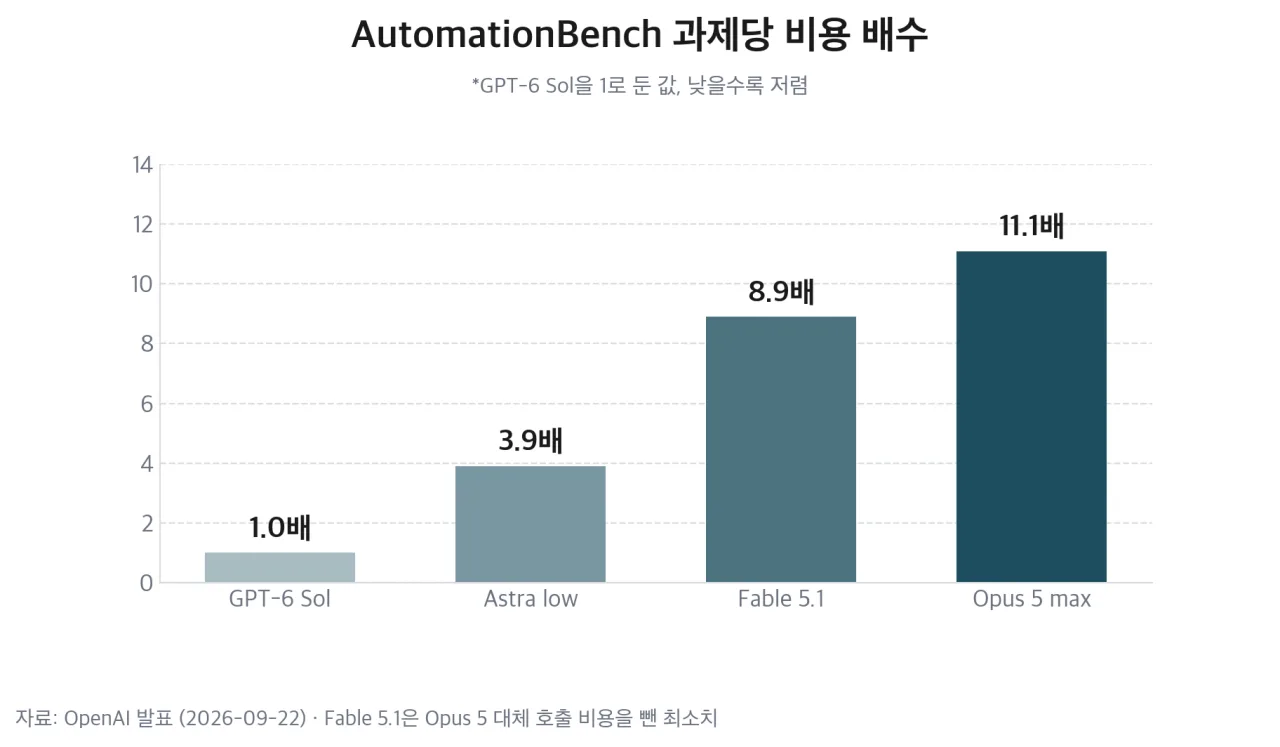 AutomationBench 과제당 비용 배수 — 출처: OpenAI 발표 수치 기반 자가 렌더
AutomationBench는 영업·마케팅·운영·고객지원·재무·인사 업무를 47개 도구로 처리하는 워크플로 벤치마크입니다. xhigh 설정의 GPT-6 Sol은 33.2%를 과제당 378원(0.27달러)에 기록했어요.
| 모델 (설정) | 점수 (%) |
|---|---|
| GPT-6 Sol (xhigh) | 33.2 |
| Claude Fable 5.1 (max) | 31.4 |
| GPT-6 Astra (low) | 30.3 |
| Claude Opus 5 (max) | 26.9 |
Sol은 low 설정의 Astra보다 높은 점수를 3.9분의 1 비용으로, max 설정의 Claude Opus 5보다 높은 점수를 약 9% 비용으로 기록했습니다. Fable 5.1은 과제의 약 40%가 Opus 5로 라우팅됐고 그 비용이 제외돼 있어, 실제 비용 배수는 8.9배보다 큽니다.
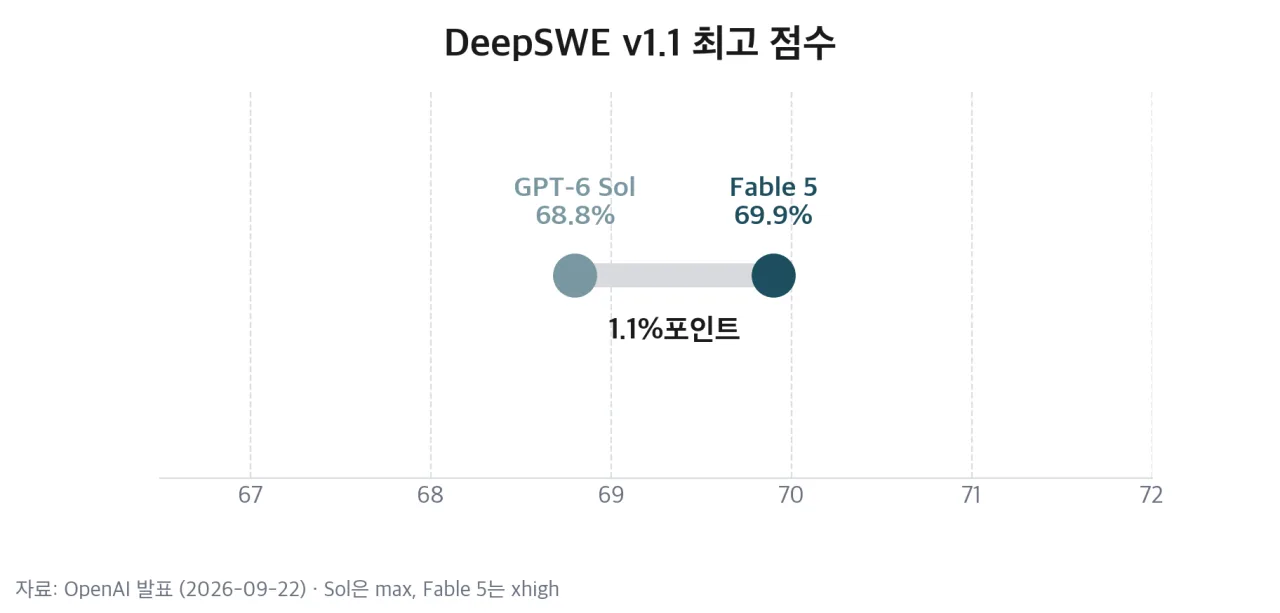 DeepSWE v1.1 최고 점수 비교 — 출처: OpenAI 발표 수치 기반 자가 렌더
실제 코드베이스에서 긴 소프트웨어 과제를 푸는 DeepSWE v1.1에서는 max 설정의 Sol이 68.8%로, xhigh 설정의 Claude Fable 5(69.9%)와 1.1%포인트 차이였습니다. 과제당 비용은 약 80% 낮았어요.
- Agents’ Last Exam: Sol(max) 56.4%, Claude Opus 5 최고점보다 높고 과제당 비용 60% 낮음
- FrontierCode 1.1: Sol이 xhigh 설정의 Claude Fable 5.1과 같은 수준, 비용은 훨씬 낮음
- OSWorld 2.0 오프라인: Sol(xhigh) 60.5%, medium 설정의 Claude Opus 5(60.3%)와 비슷하고 비용 약 80% 낮음
- AutomationBench: Luna(high)가 GPT-5.6 Luna보다 5.4%포인트 높고 과제당 비용 58% 낮음
Codex에서 쓰기
 OpenAI 로고 — 출처: OpenAI
Codex는 2026년 9월 22일 배포된 CLI 0.156.0부터 두 모델을 지원합니다. 앱에서는 모델 선택 메뉴에서 고르고, CLI에서는 실행할 때 모델을 지정하거나 세션 안에서 /model로 바꿔요.
💻 [소스코드: Codex CLI에서 모델 지정]
codex --model gpt-6-sol
codex --model gpt-6-luna
API 모델 ID는 gpt-6-sol·gpt-6-luna이고, Chat Completions·Responses 엔드포인트와 web_search·file_search·code_interpreter·computer_use·mcp 같은 도구를 지원합니다.
GitHub Copilot에서는 Sol이 Pro+·Max·Business·Enterprise 요금제에, Luna가 Pro까지 포함한 요금제에 포함되며, VS Code·JetBrains·Xcode·Copilot CLI 등에서 고를 수 있습니다.
ChatGPT 쪽은 국내 Plus 구독자도 같은 조건이라 ChatGPT Work와 Codex에서 바로 쓸 수 있고, 일반 대화 화면(Chat)에는 아직 제공되지 않습니다.
OpenAI는 GPT-6 Astra의 대화 방식도 두 모델에 적용했다고 밝혔습니다. 전문 용어와 부수적인 설명을 줄이고, 무엇을 확인했고 무엇을 확인하지 않았는지 더 분명히 말하며, 답이 전체적으로 조금 짧아졌어요.
비교의 한계
 Anthropic 로고 — 출처: Anthropic
OpenAI가 비교한 Anthropic 모델은 Claude Opus 5와 Fable 5.1(값이 없으면 Fable 5)이고, 90분 먼저 나온 Opus 5.5는 들어 있지 않습니다. 경쟁사 수치는 공개 보고서에서 가져왔다고 각주에 적었어요.
두 회사가 각자 발표한 수치를 직접 비교하면 AutomationBench에서 Anthropic이 밝힌 Opus 5.5 점수는 40.0%, OpenAI가 밝힌 GPT-6 Sol(xhigh)은 33.2%입니다. 측정 주체와 설정이 달라 그대로 비교할 수는 없고, 요금은 Sol이 절반이에요.
OpenAI는 사실 정확도 평가가 사용자가 이전 모델의 오류를 신고한 대화로 구성돼 일반적인 사용을 대표하지 않는다고 밝혔어요. 정렬 평가 역시 일부러 어려운 상황을 만든 시험이라 일상 사용에서의 실패율을 측정하는 것이 아니라고 적었습니다.
고르는 법
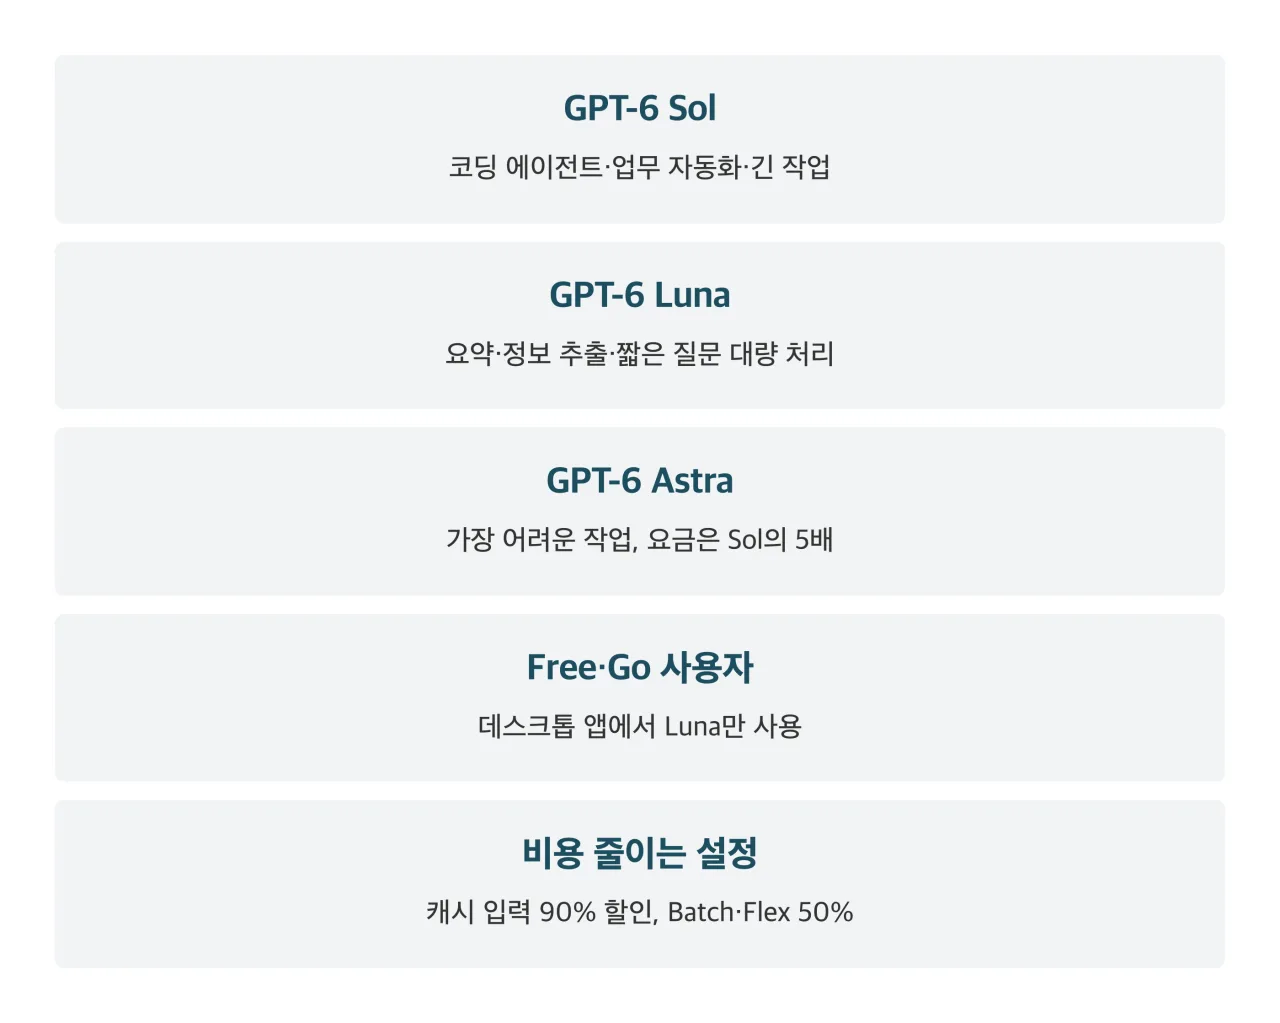 모델별 용도 정리 카드 — 출처: OpenAI 발표 기반 자가 렌더
앞으로 주목할 점
- ChatGPT 일반 대화 화면(Chat) 적용 시점
- 경쟁 모델: Anthropic Sonnet 5.5·Haiku 5.5, 수 주 안 출시 예고
참고 출처
- [OpenAI] Introducing GPT-6 Sol and Luna (2026-09-22, 요금·벤치마크·제공 범위)
- [OpenAI API Docs] GPT-6 Sol (컨텍스트·요금·추론 강도·도구)
- [OpenAI API Docs] GPT-6 Luna (컨텍스트·요금·캐시 쓰기)
- [OpenAI Codex] Changelog (2026-09-22, CLI 0.156.0·모델 선택)
- [GitHub Changelog] OpenAI’s GPT-6 Sol and GPT-6 Luna now available (2026-09-22, Copilot 요금제)
- [TechCrunch] OpenAI launches GPT-6 Sol and Luna (2026-09-22, 출시 시각·용도)
- [Anthropic] Introducing Claude Opus 5.5 (2026-09-22, Opus 5.5 요금·AutomationBench 점수)
- 환율: 1달러 ≈ 1,400원 기준 환산