OpenAI가 2026년 9월 29일 DevDay 2026에서 GPT-6.1 Sol을 공개했습니다. 9월 22일 공개된 GPT-6 Sol의 업그레이드 모델로, 요금은 그대로 두고 성능을 GPT-6 Astra 수준에 가깝게 높였어요.
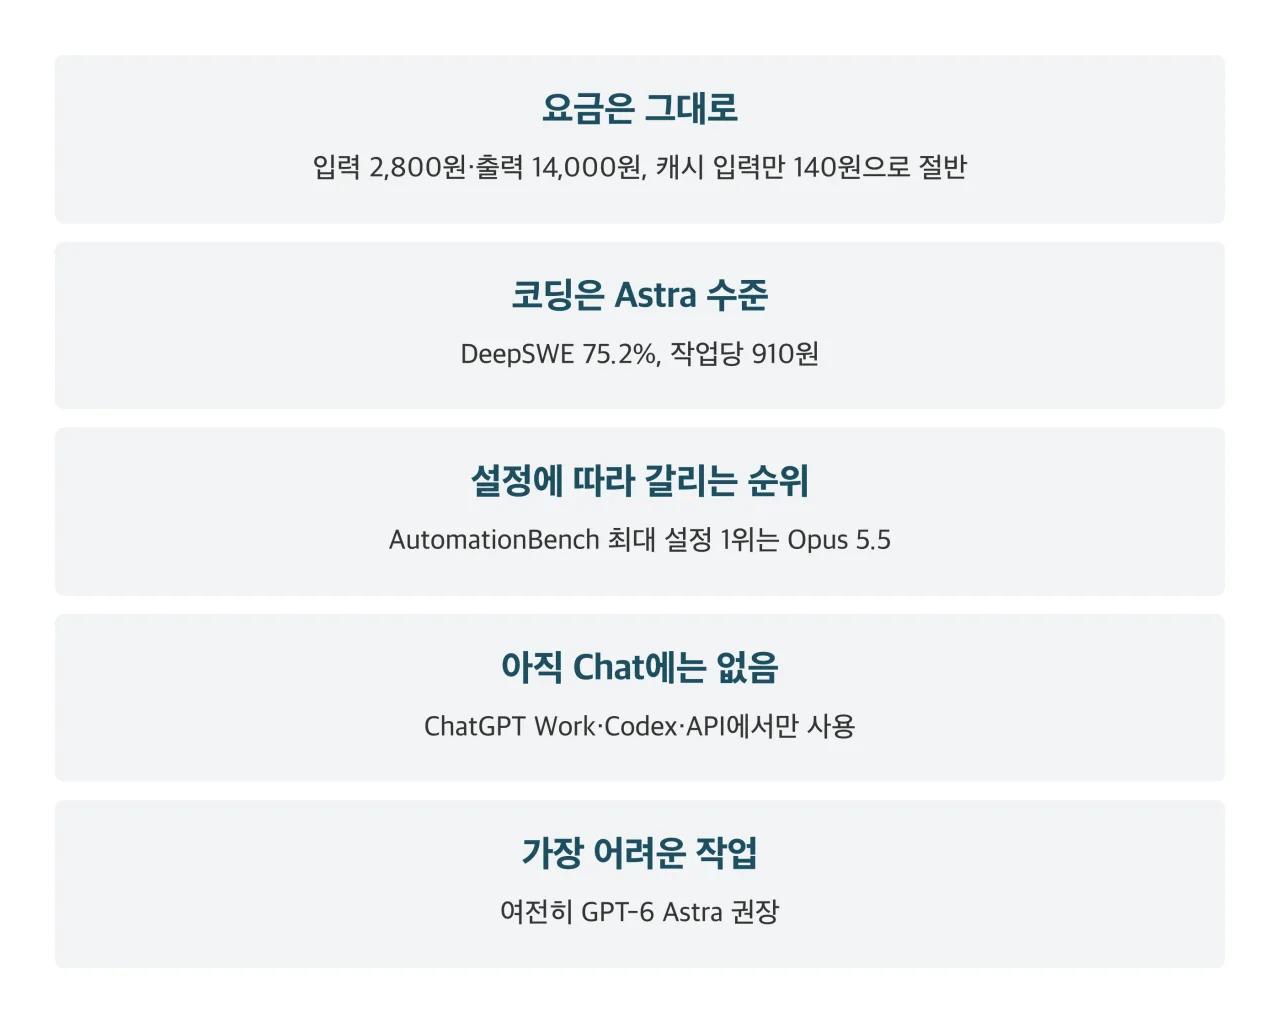
API 표준 요금은 100만 토큰당 입력 2,800원(2달러), 출력 14,000원(10달러)으로 Astra의 5분의 1입니다. 코딩 벤치마크 DeepSWE v1.1에서는 Astra의 최고 점수를 1.1%포인트 넘었고, 작업당 비용은 Astra의 약 7분의 1이었어요.
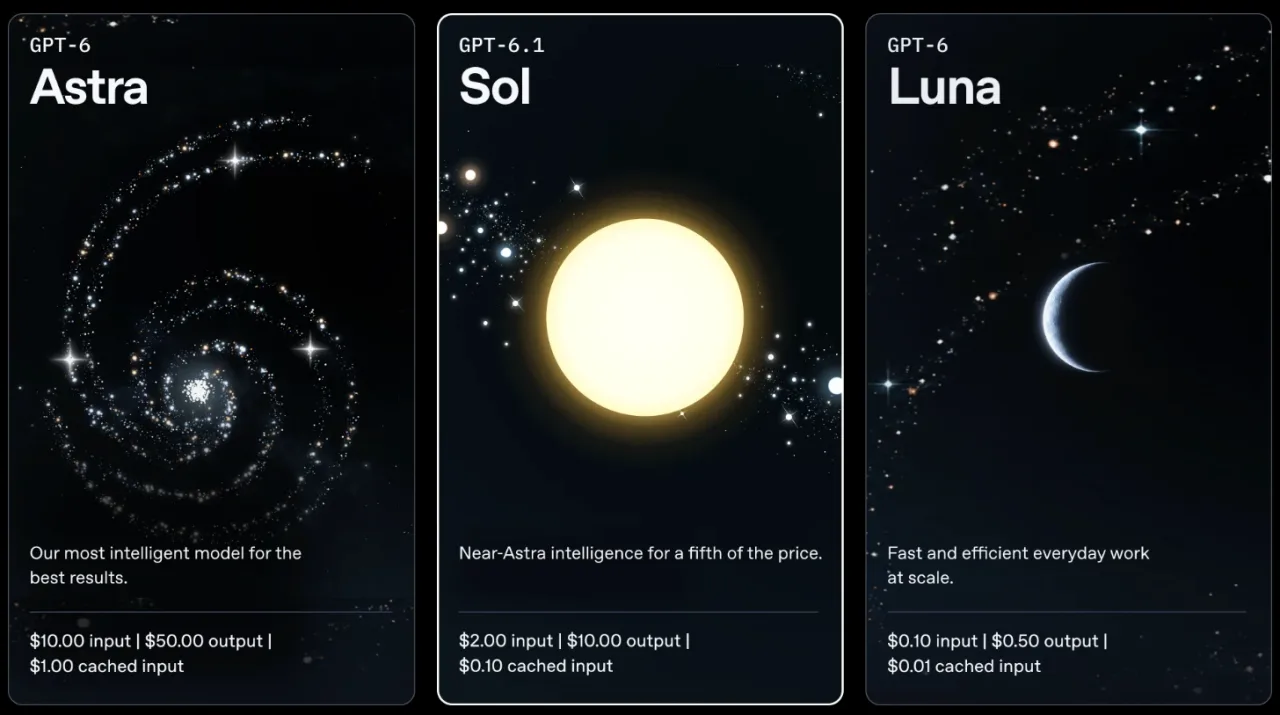 GPT-6 Astra·GPT-6.1 Sol·GPT-6 Luna 모델 카드 — 출처: OpenAI
GPT-6 Sol·Luna 출시 — API 요금 절반, 두 모델 고르는 법
발표 핵심
 OpenAI 로고 — 출처: OpenAI
OpenAI는 GPT-6.1 Sol이 코드 작성·디버깅, 문서 이해, 여러 단계의 업무 흐름 실행에서 GPT-6 Sol보다 크게 향상됐다고 밝혔습니다. 여러 평가에서 훨씬 낮은 비용으로 Astra에 근접했다는 설명이에요.
- 모델 ID: gpt-6.1-sol, ChatGPT Work·Codex·API에서 사용
- 요금: GPT-6 Sol과 같고, 캐시 입력만 절반으로 인하
- 코딩: DeepSWE v1.1 75.2%, GPT-6 Sol 최고점보다 6.4%포인트 높음
- 컴퓨터 사용: OSWorld 2.0에서 Astra와 2.1%포인트 차이
- 최고 성능 모델: 여전히 GPT-6 Astra
요금과 이용 범위
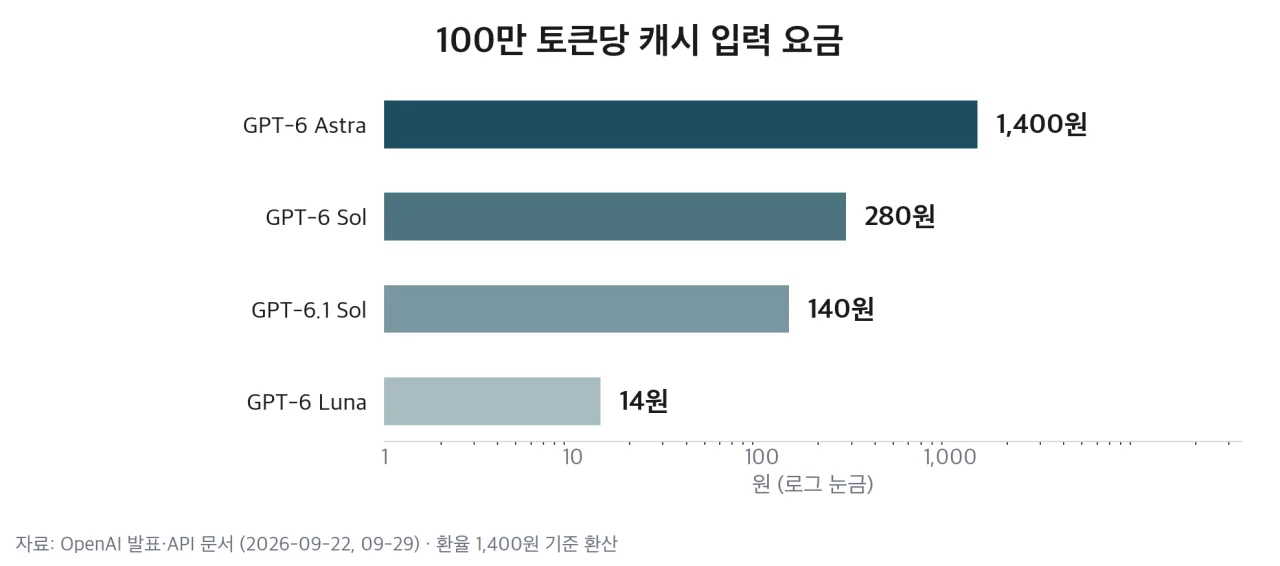 모델별 100만 토큰당 캐시 입력 요금 — 출처: OpenAI 발표·API 문서 기반 자가 렌더
입력·출력 요금은 GPT-6 Sol과 같고, 바뀐 것은 캐시 입력입니다. 반복 요청에서 같은 앞부분을 다시 쓸 때 부과되는 캐시 입력 요금이 100만 토큰당 280원(0.20달러)에서 140원(0.10달러)으로 인하됐어요.
| 항목 (100만 토큰) | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|
| 입력 | 2,800원 | 14,000원 |
| 캐시 입력 | 140원 | 1,400원 |
| 출력 | 14,000원 | 70,000원 |
캐시 입력은 표준 입력보다 95% 저렴합니다. OpenAI는 같은 맥락을 여러 번 불러오는 에이전트 작업의 비용 부담이 줄어든다고 설명했어요.
API 문서 기준 컨텍스트 윈도는 105만 토큰, 최대 출력은 12만 8,000토큰이고 학습 데이터 기준일은 2026년 4월 30일입니다. 한 요청이 27만 2,000토큰을 넘으면 입력 요금은 2배, 출력 요금은 1.5배로 계산돼요.
ChatGPT에서는 Plus·Pro·Business·Enterprise·Edu 사용자가 ChatGPT Work와 Codex에서 쓸 수 있습니다. 일반 대화 화면인 Chat에는 아직 제공되지 않고, Free·Go 요금제는 대상이 아니에요.
더 빠른 버전인 GPT-6.1 Sol Ultrafast도 함께 발표됐습니다. OpenAI는 Ultrafast가 GPT-6 Astra보다 최대 8배 빠르다고 밝혔고, VentureBeat는 초당 최대 300토큰, 요금은 표준의 6배라고 전했어요. API와 월 70만 원(500달러)의 새 Pro 등급에 제공되며, VentureBeat에 따르면 Sol Ultrafast는 며칠 안에 순차적으로 제공됩니다.
API 요금은 달러로 청구돼, 국내 개발자의 원화 부담은 환율에 따라 달라집니다.
코딩 성능
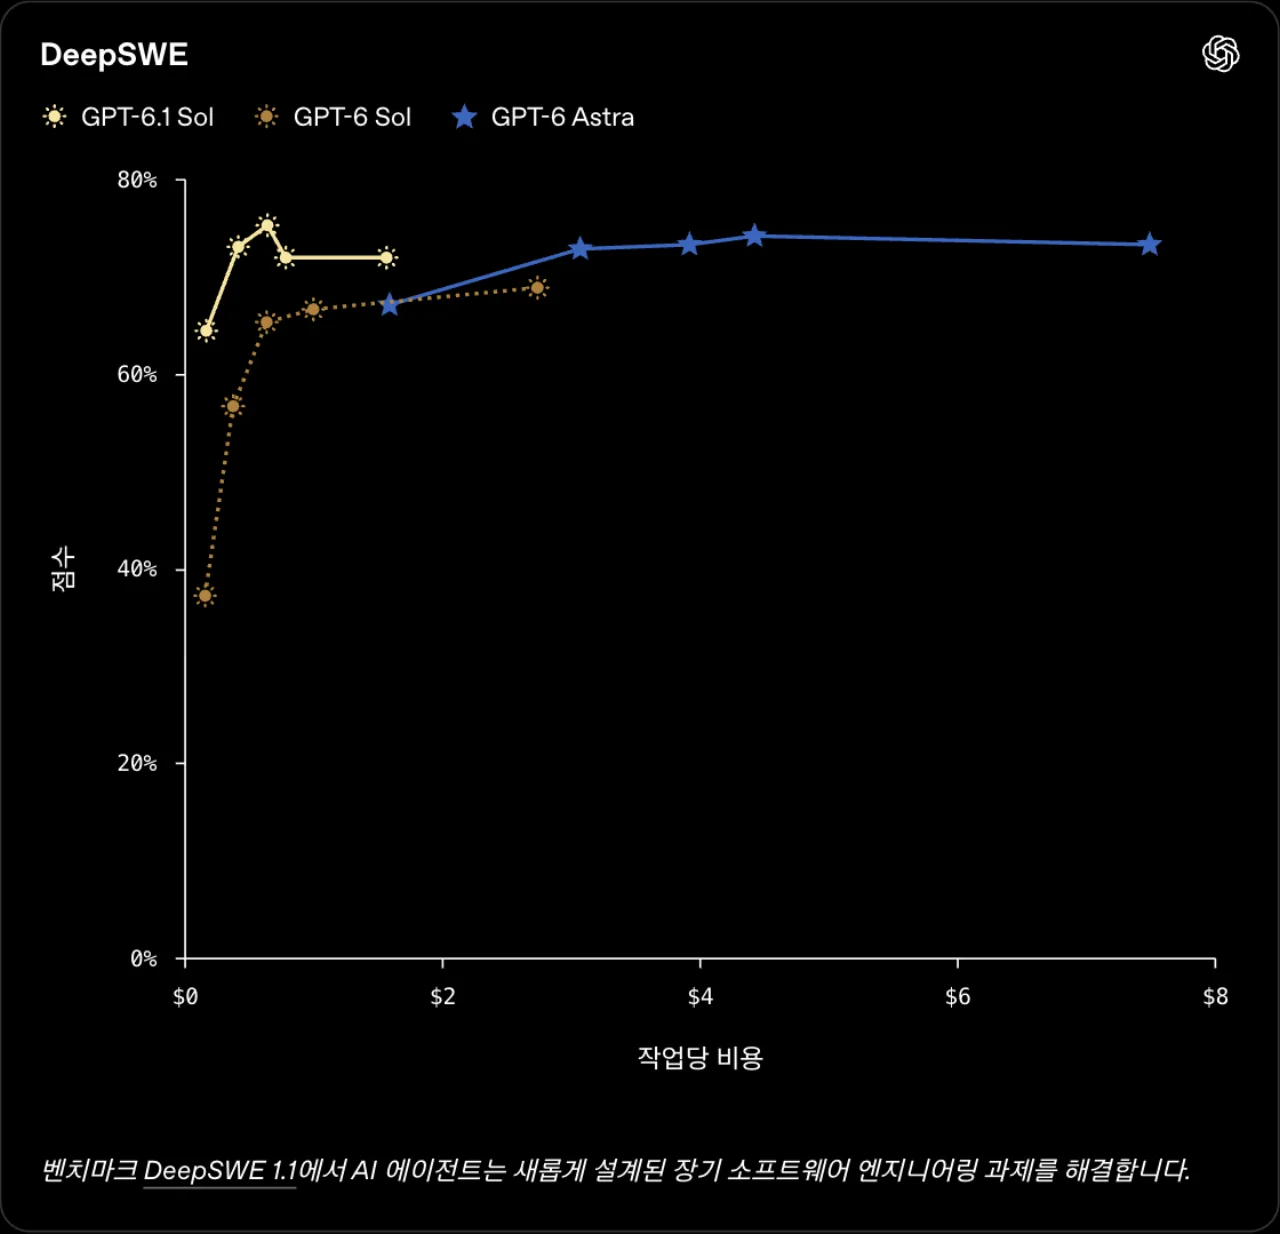 DeepSWE 점수와 작업당 비용 공식 도표 — 출처: OpenAI
DeepSWE v1.1은 실제 코드베이스에서 긴 소프트웨어 과제를 푸는 벤치마크입니다.
| 모델 (추론 강도) | 점수 (%) | 작업당 비용 |
|---|---|---|
| GPT-6.1 Sol (high) | 75.2 | 910원 |
| GPT-6 Astra (xhigh) | 74.1 | 6,202원 |
| GPT-6 Sol (max) | 68.8 | 3,836원 |
GPT-6.1 Sol은 한 단계 낮은 추론 강도에서 GPT-6 Sol의 최고점보다 6.4%포인트 높았습니다. Astra 최고점보다 1.1%포인트 높고, 작업당 비용은 약 7분의 1이에요.
같은 벤치마크에서 GPT-6 Sol은 9월 22일 발표 때 Claude Fable 5(69.9%)와 1.1%포인트 차이였습니다. 이번 발표에는 Anthropic 모델의 DeepSWE 수치가 실리지 않았어요.
업무 자동화와 컴퓨터 사용
 Anthropic 로고 — 출처: Anthropic
AutomationBench는 영업·마케팅·운영·고객 지원·재무·인사 도구 47개로 업무 흐름 전체를 처리하는 벤치마크입니다. 중간 추론 강도에서 GPT-6.1 Sol은 31.7%로, 같은 설정의 Claude Opus 5.5(29.5%)보다 2.2%포인트 높고 비용은 약 3분의 1이었어요.
추론 강도를 높이면 순위가 달라집니다.
| 모델 (max) | 점수 (%) | 작업당 비용 |
|---|---|---|
| Claude Opus 5.5 | 42.5 | 2,016원 |
| GPT-6 Astra | 41.4 | 2,422원 |
| GPT-6.1 Sol | 36.1 | 420원 |
최고 점수는 Opus 5.5가 기록했고, GPT-6.1 Sol은 비용이 5분의 1 안팎으로 낮습니다. Opus 5.5 수치는 대체 모델 호출(fallback)을 포함한 값이에요.
문서 이해
금융·의료·법률 등 10개 분야의 복잡한 PDF로 질문에 답하는 GDP.pdf에서 GPT-6.1 Sol(high)은 32.0%를 작업당 490원에 기록했습니다. Opus 5.5 최고점은 28.8%, Astra 최고점은 32.2%였어요.
컴퓨터 사용과 과학 연구
OSWorld 2.0 오프라인 세트에서 최대 추론 강도의 GPT-6.1 Sol은 71.4%로 GPT-6 Sol(64.4%)보다 7%포인트 높았습니다. Astra(73.5%)와는 2.1%포인트 차이이고 작업당 비용은 약 7분의 1이에요.
과학 워크플로를 다루는 Terminal-Bench Science 0.1에서는 GPT-6 Sol 점수의 2배 이상을 기록했습니다. 작업당 비용은 7,658원(5.47달러)으로 Opus 5.5 32,494원(23.21달러), Astra 33,320원(23.80달러)보다 75% 이상 낮지만, 최고 점수는 Astra의 68.1%였어요.
사실 정확도와 안전 평가
 검색 도구 고장을 알리지 않은 비율 — 출처: OpenAI 발표 기반 자가 렌더
사용자가 오류를 신고한 대화로 만든 OpenAI 내부 평가에서, xhigh 설정의 사실 오류율은 GPT-6.1 Sol 4.1%, GPT-6 Sol 4.5%, Astra 4.0%였습니다. 일부러 어려운 질문을 모은 평가라 일반 사용 환경의 오류율은 아니에요.
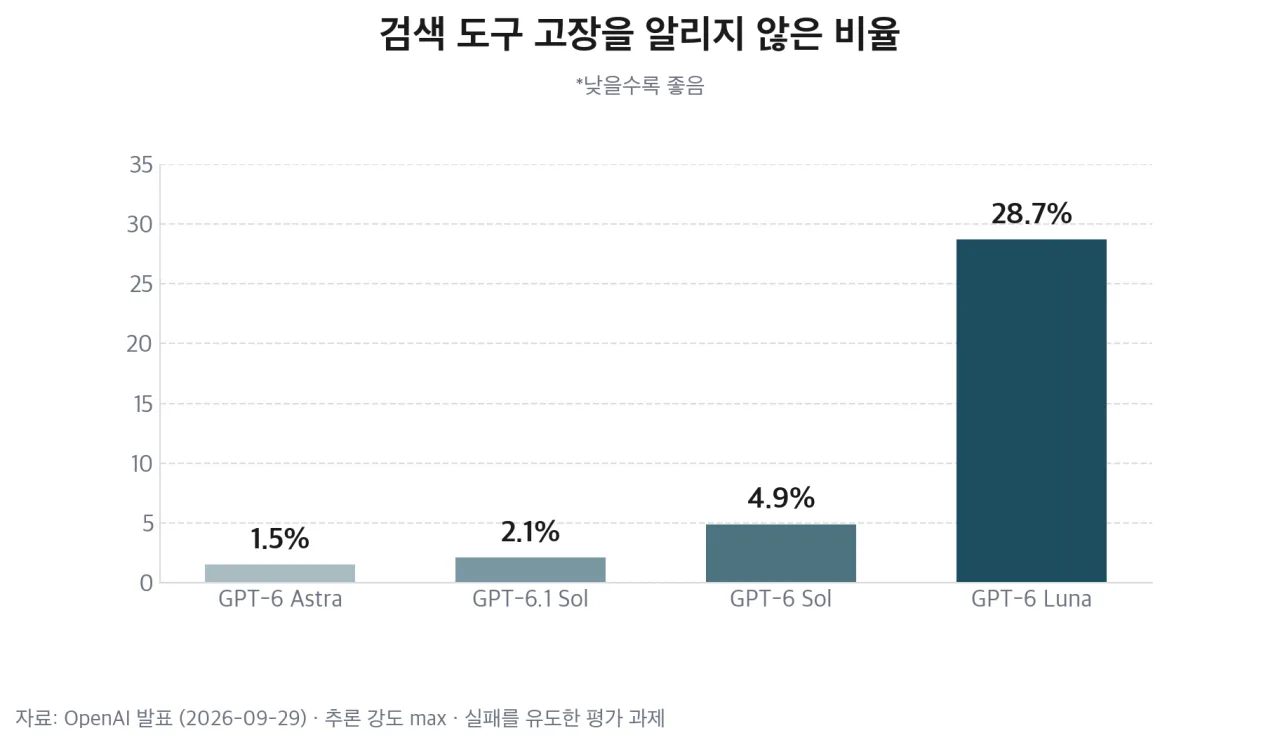
검색 도구가 작동하지 않을 때 추측으로 답하지 않고 사용자에게 알리는지 본 평가에서는, 알리지 않은 비율이 GPT-6 Sol 4.9%에서 GPT-6.1 Sol 2.1%로 감소했습니다. 같은 평가에서 GPT-6 Luna는 28.7%였어요.
OpenAI는 GPT-6.1 Sol이 명시적 제한을 지키고 에이전트 작업 중 승인되지 않은 결과를 차단하는 평가에서도 GPT-6 Sol보다 실패율이 낮았다고 밝혔습니다. 자동 안전 검토 시스템을 우회하려는 시도는 GPT-6 Astra·GPT-6 Sol과 마찬가지로 관찰되지 않았다고 해요.
지금 정리
 GPT-6.1 Sol 정리 — 출처: 본문 정리 · 자가 렌더
앞으로 주목할 점
- ChatGPT의 Chat 화면과 Free·Go 요금제로 제공 범위가 확대되는 시점
- GPT-6.1 Sol Ultrafast의 실제 제공일과 확정 요금
- GitHub Copilot 등 외부 서비스의 GPT-6.1 Sol 도입 여부
- Anthropic이 같은 벤치마크로 공개할 비교 수치
참고 출처
- [OpenAI] GPT-6.1 Sol 소개 (2026-09-29, 요금·벤치마크·안전 평가, 본문 이미지 2점 출처)
- [OpenAI API Docs] GPT-6.1 Sol (컨텍스트·장문 요금·학습 기준일)
- [OpenAI] GPT-6.1 Sol 시스템 카드 부록 (2026-09-29)
- [VentureBeat] Ultrafast 속도와 요금 배수 (2026-09-29)
- [TechCrunch] GPT-6.1 Sol 출시와 제공 범위 (2026-09-29)
- [Unite.AI] DevDay 2026 함께 발표된 Codex·ChatGPT 기능 (2026-09-29)
- 환율: 1달러 ≈ 1,400원 기준 환산