Convai Innovations가 2026년 9월 18일 Hugging Face에 결정 모델 Laya의 가중치를 Apache 2.0 라이선스로 공개했습니다. 문장을 생성하지 않고 선택지별 확률만 반환한다는 점에서 9월 15일 TypeSafe AI가 공개한 Jev와 같은 종류인데, Jev는 가중치를 공개하지 않은 유료 API이고 Laya는 누구나 내려받아 무료로 실행할 수 있어요.
Jev가 어떤 구조로 판단을 내리는지는 아래 글에 정리했어요.
 Laya 로고 — 출처: Convai Innovations
Laya 개요
Laya는 입력(state)과 질문 몇 개를 받아, 질문마다 답과 확률 분포를 한 번의 계산으로 반환하는 모델입니다. 텍스트를 한 토큰씩 생성하는 LLM(대규모 언어모델)과 달리 출력 토큰이 0개라, 형식이 어긋난 JSON이나 없는 선택지를 지어내는 일이 구조적으로 생기지 않아요.
기반 구조는 BERT 계열의 양방향 인코더입니다. 문장을 앞뒤로 한 번에 읽는 인코더 위에 질문 유형별 판단 헤드를 결합했어요. 체크포인트는 셋이 공개됐습니다.
| 체크포인트 | 인코더·크기 | 용도 |
|---|---|---|
| laya | ModernBERT-large · 421M | 영어 판단 |
| laya-multilingual | mmBERT-base · 322M | 100개 이상 언어 |
| laya-typed-decisions | ModernBERT-large · 421M | 벤치마크 미세조정본 |
입력 길이는 영어 체크포인트가 512 토큰, 다국어 체크포인트가 1,024 토큰(최대 8,192까지 확장)이에요.
설치는 pip install laya 한 줄이고 Python 3.10 이상이 필요합니다.
질문 유형 세 가지
[choice] 여러 선택지 중 하나를 고름, 문의 유형 분류·담당 부서 배정
[score] 0~3 같은 순서 있는 등급, 긴급도·심각도 판정
[noul] 참일 확률을 0.0~1.0으로 반환, 피싱·탈옥 시도 판별
Jev의 Choice·Score·참거짓 질문과 대응하는 구성이에요. 응답에는 선택지별 확률, 신뢰도, 어느 체크포인트가 처리했는지가 함께 담깁니다.
속도
 Tesla T4 한 장에서 질문 수별 p50 지연 시간 — 출처: Convai Innovations
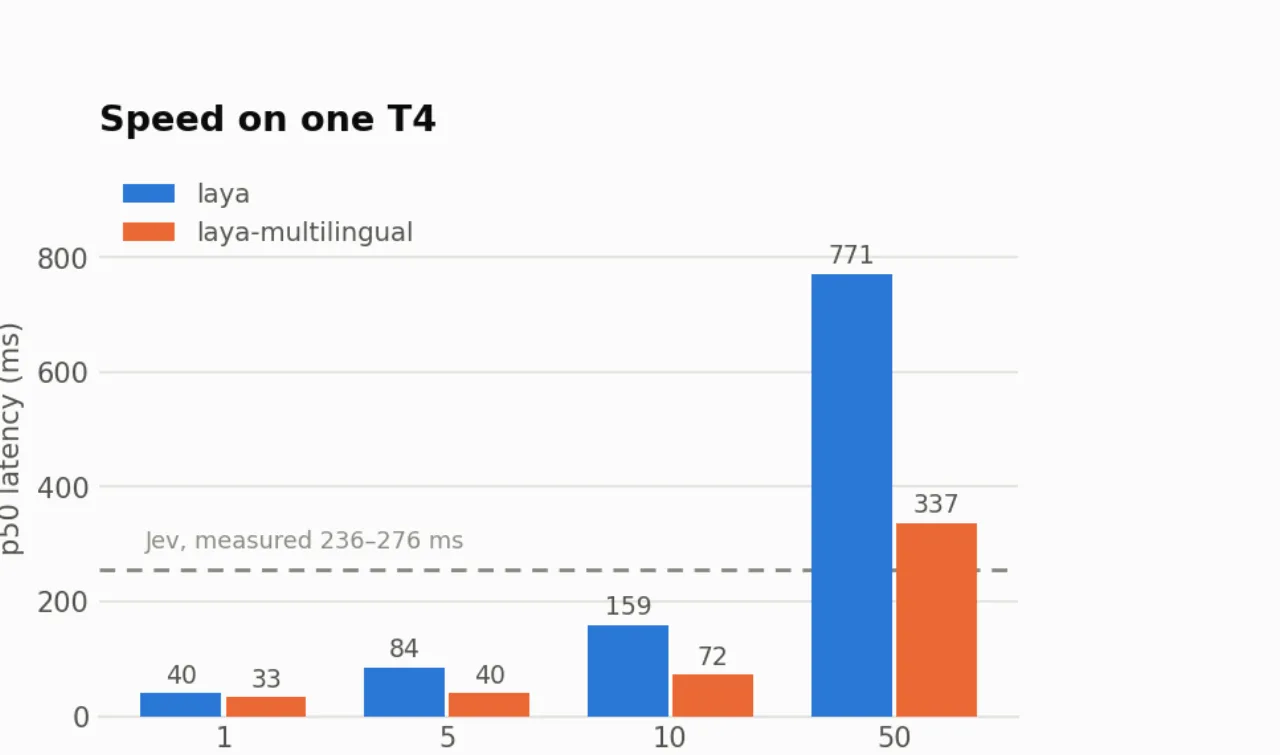
모델 카드 기준 Tesla T4 GPU 한 장에서 질문 하나를 처리하는 데 영어 체크포인트는 39.5밀리초, 다국어 체크포인트는 32.8밀리초가 걸렸어요. 질문 10개는 158.6밀리초와 72.3밀리초, 50개는 771밀리초와 337밀리초입니다. 배치로 묶어 입력하면 초당 103~332개 질문을 처리했어요.
Laya 쪽은 Jev가 236~276밀리초라며 7.8배 빠르다고 내세웁니다. 다만 모델 카드는 이 Jev 수치가 제3자가 공개한 값이고 Laya 개발자는 TypeSafe API에 접근하지 않아 직접 재지 않았다고 밝혀요. 로컬 GPU에서 잰 Laya와 호스팅 API인 Jev는 네트워크 왕복 포함 여부부터 조건이 달라 배수를 그대로 비교하기는 어렵습니다.
Jev는 입력 100만 토큰당 약 59원(0.042달러)을 받고, Laya는 사용료 없이 GPU 운영비만 들어요. T4는 클라우드에서 가장 저렴한 축에 드는 추론용 GPU라 사내 서버나 국내 클라우드에 올리기 쉬운 크기입니다.
정확도
 Jev와 같은 공개 데이터셋 세 개에서의 정확도 비교 — 출처: Convai Innovations
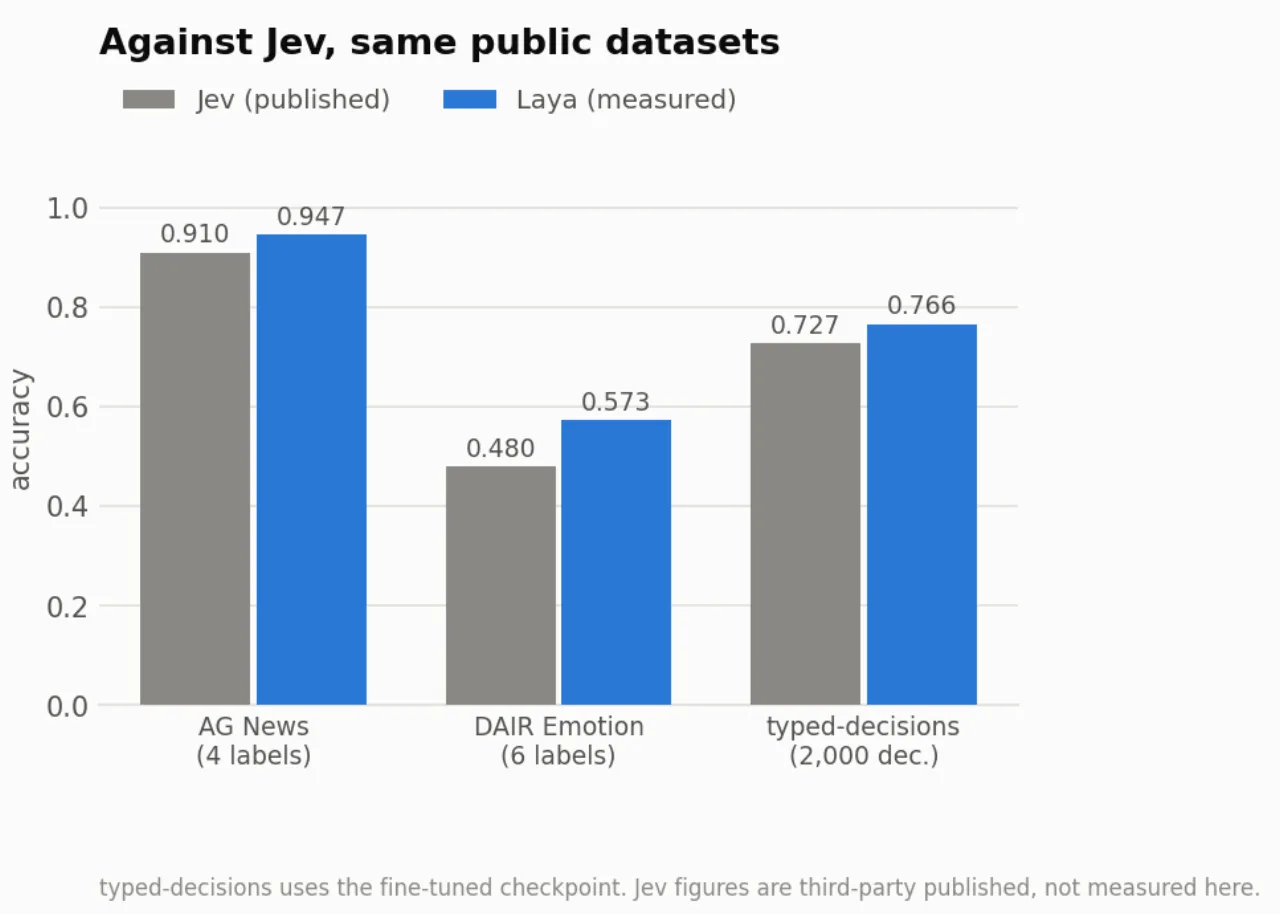
뉴스 주제 4분류인 AG News에서 Laya는 0.947로 Jev(0.910)보다 높았고, 감정 6분류 DAIR Emotion에서도 0.573으로 Jev(0.480)보다 높았어요. Jev가 공개한 업무형 벤치마크 typed-decisions(400건, 판단 2,000개)에서는 0.766 대 0.727이었습니다.
 typed-decisions 벤치마크 정확도, 기준선과 체크포인트 — 출처: Laya 모델 카드 수치 기반 자가 렌더
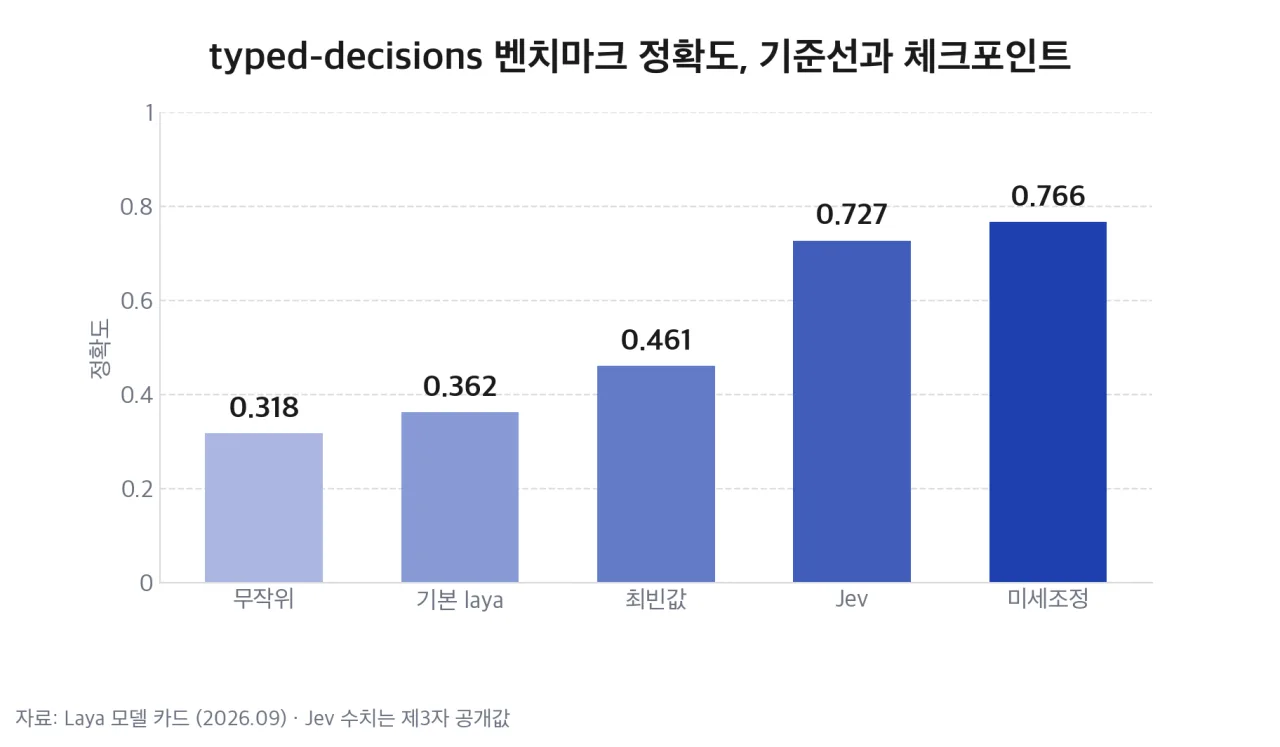
typed-decisions의 0.766은 그 벤치마크의 학습용 데이터로 미세조정한 laya-typed-decisions의 점수예요. 미세조정 없는 기본 laya는 0.362로, 무작위(0.318)보다는 높지만 가장 많은 정답 하나만 계속 고르는 최빈값 기준(0.461)보다 낮습니다. 모델 카드도 Laya를 제로샷 판단 엔진이 아니라 미세조정해서 쓰는 출발점이라고 적었어요.
선택지가 많아지면 성능 우위가 반대로 바뀝니다. 은행 문의 77분류 Banking77에서 Laya는 0.425, Jev는 0.870이었고, Laya 문서는 선택지가 20개를 넘으면 성능이 떨어진다고 밝혔어요.
순서 있는 등급을 매기는 score 유형은 영화 리뷰 5등급 SST-5에서 0.372로 세 유형 중 가장 약했습니다.
한 줄 요약: 라벨 데이터로 미세조정할 수 있는 좁은 분류 업무에서만 Jev보다 나은 결과가 나왔습니다.
보정(신뢰도) 수치
결정 모델은 0.85라고 답한 판단이 실제로 85% 정도 맞아야 신뢰도 점수로 자동 처리와 사람 검토를 구분할 수 있어요. 이 어긋남을 재는 지표가 ECE(기대 보정 오차)이고 낮을수록 좋습니다.
Laya 영어 체크포인트는 사용자 데이터로 온도(temperature)를 다시 맞춘 뒤 ECE 0.081, 다국어 체크포인트는 0.106을 기록했어요. 받은 그대로의 상태에서는 이보다 크게 어긋나서, 모델 카드는 신뢰도 기준값을 정하기 전에 자기 업무 데이터로 보정을 다시 하라고 권합니다. Jev 글에서 짚었던 보정 곡선 미공개 문제와 달리, Laya는 보정 전후 수치와 재현 스크립트를 저장소에 함께 공개했어요.
한국어 성능
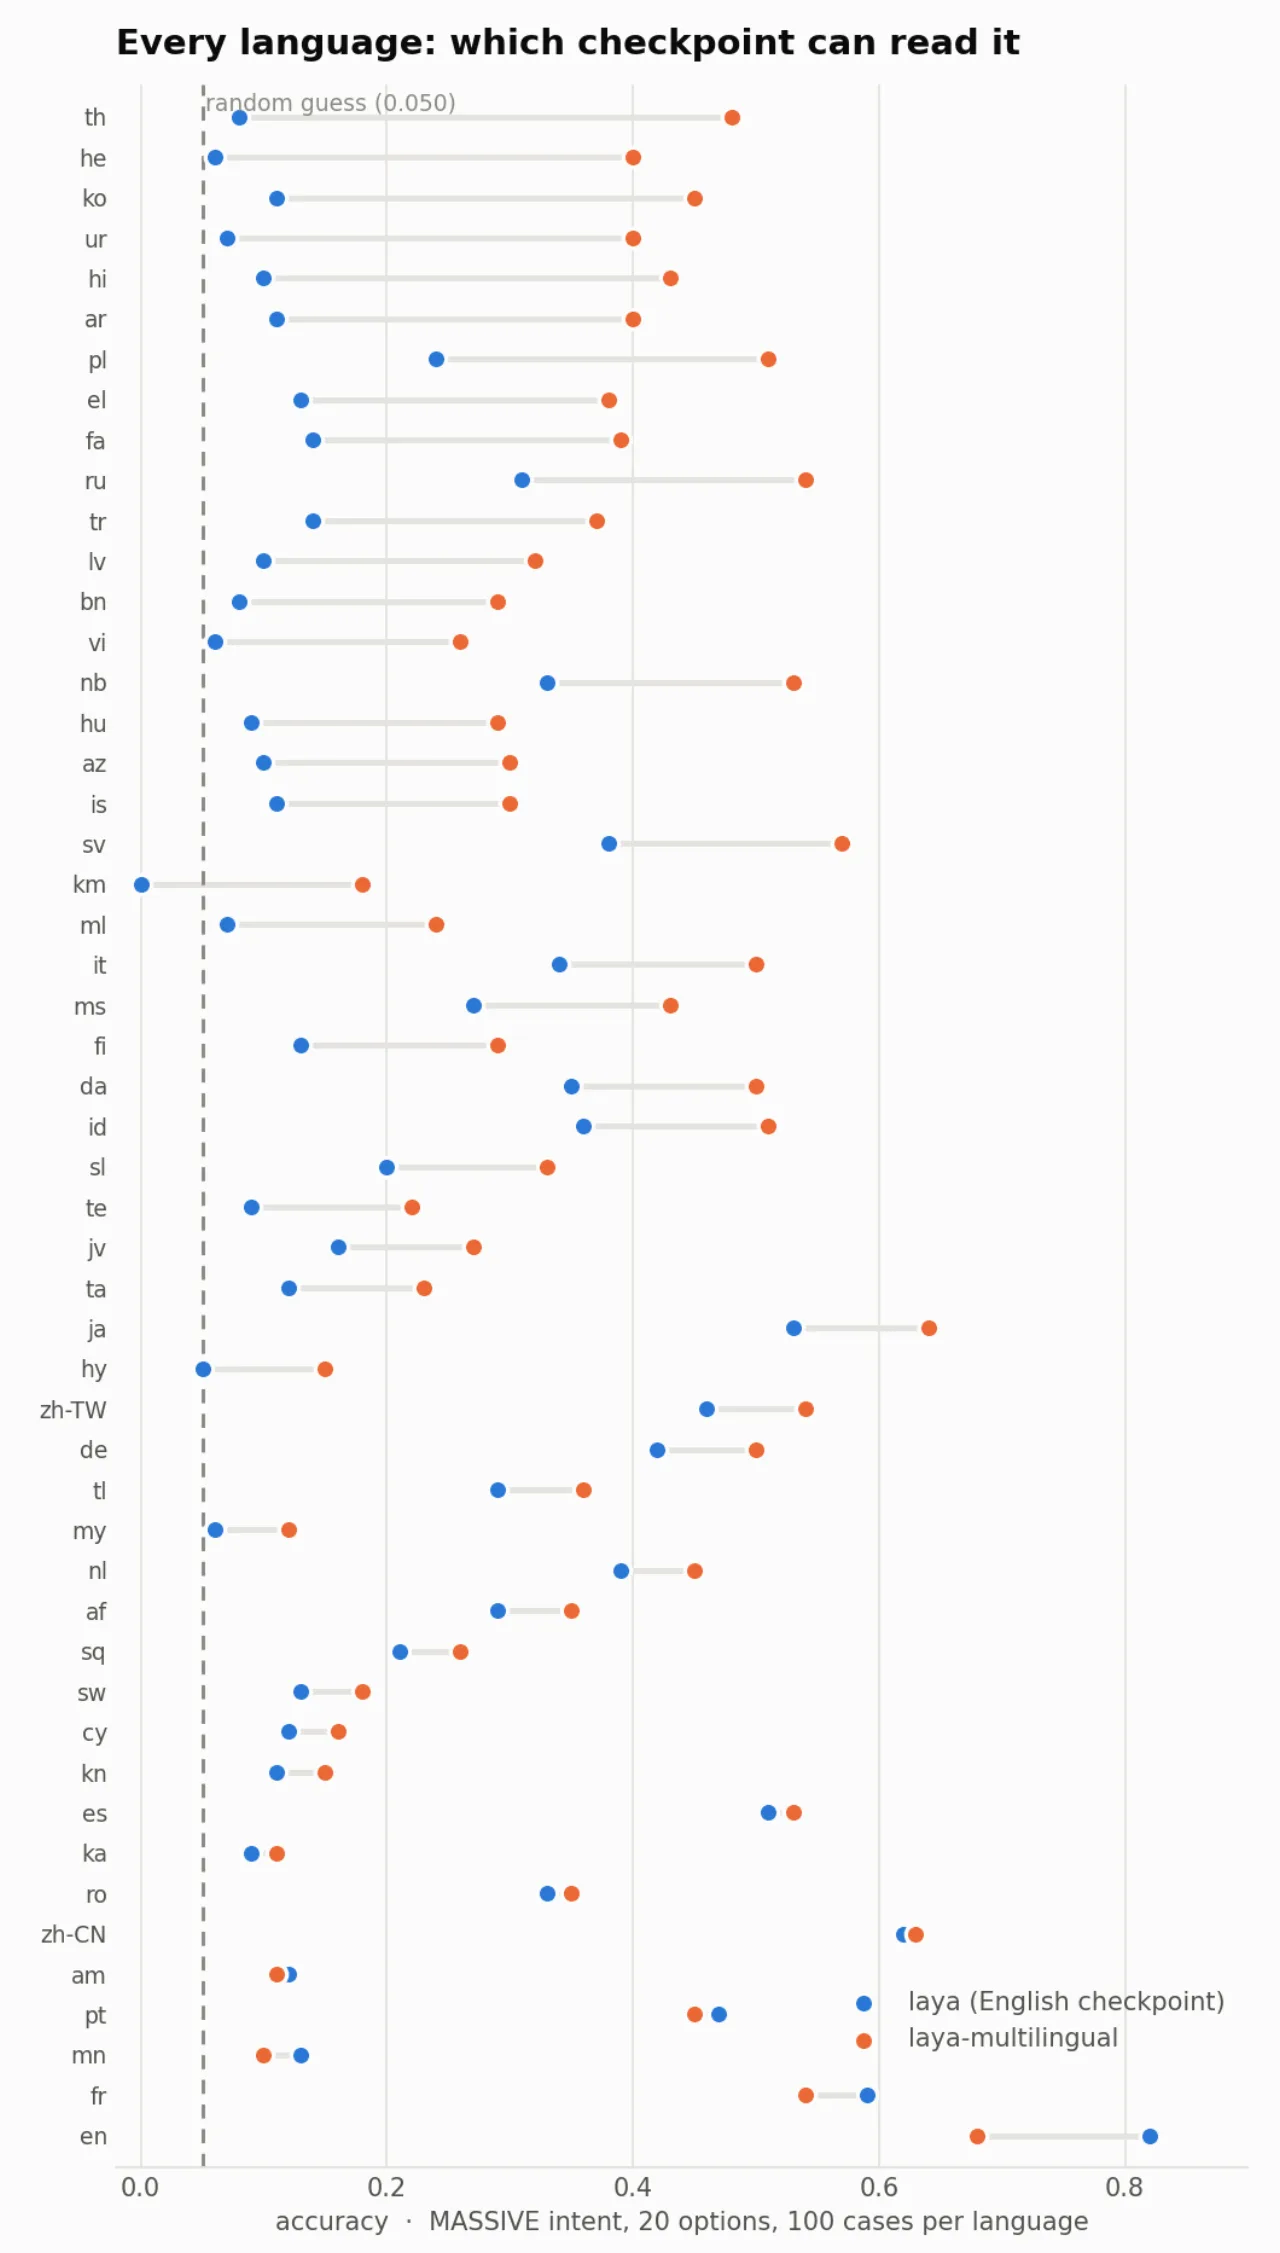 MASSIVE 의도 분류 51개 언어별 정확도, 영어·다국어 체크포인트 — 출처: Convai Innovations
한국어 문의를 분류하려면 다국어 체크포인트를 써야 합니다. 51개 언어 의도 분류(MASSIVE, 선택지 20개, 무작위 0.05)에서 영어 체크포인트가 쓸 만한 수준(무작위의 3배 이상)에 이른 언어는 23개였고, 다국어 체크포인트는 45개였어요.
한국어(ko)는 영어 체크포인트가 약 0.11, 다국어 체크포인트가 약 0.45입니다. 영어 체크포인트는 라틴 문자가 아닌 언어에서 정확도가 크게 떨어지는데, 크메르어는 정확도 0.000에 신뢰도 0.952를 내놓아 틀린 답을 확신하는 사례로 제시됐어요. Laya는 입력 문자를 0.5밀리초 안에 판별해 비라틴 문자면 다국어 체크포인트로 자동 전환합니다.
0.45는 미세조정 전 제로샷 점수라, 국내 고객센터 문의 분류에 쓰려면 한국어 라벨 데이터로 미세조정한 뒤 다시 측정해야 해요.
Apache 2.0이라 미세조정한 모델을 사내에서 운영하며 상업적으로 써도 되고, 데이터가 외부 API로 나가지 않아 망분리 환경의 금융·공공 업무에도 배포할 수 있습니다.
한계와 알려진 문제
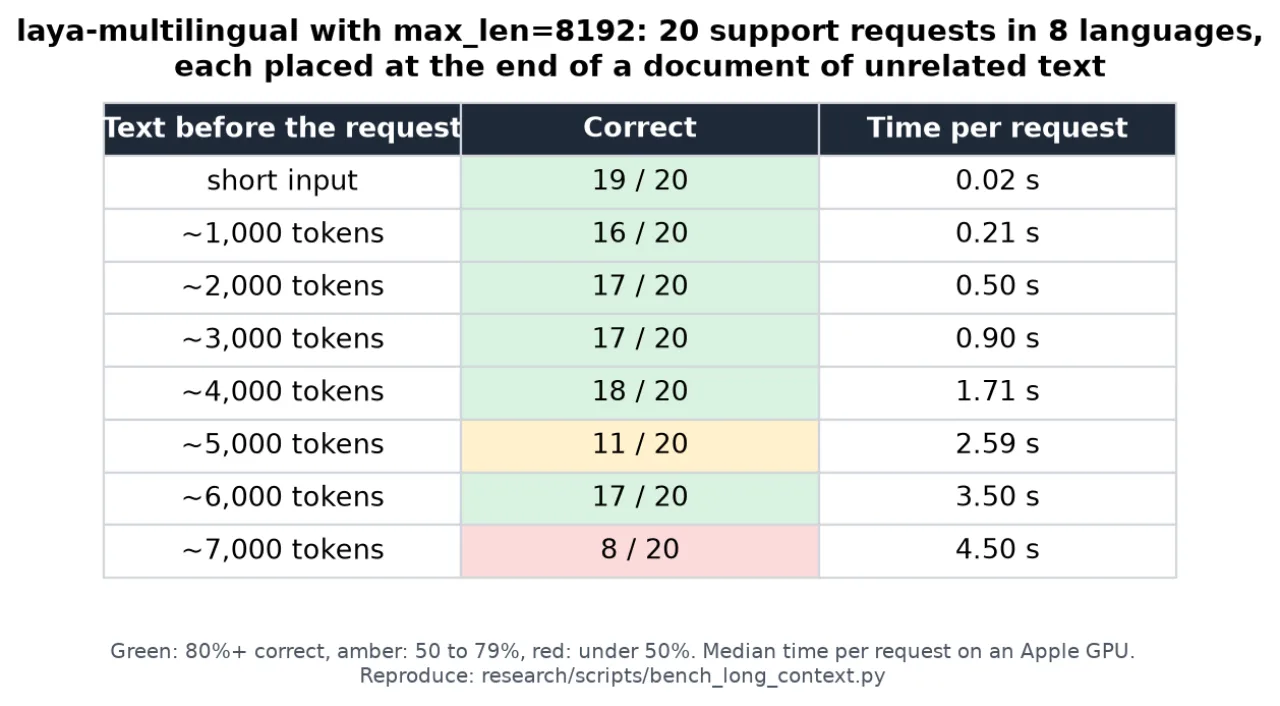 다국어 체크포인트 max_len 8192, 앞에 붙은 무관한 텍스트 길이별 정확도 — 출처: Convai Innovations
다국어 체크포인트를 최대 8,192 토큰으로 늘려, 무관한 문서 끝에 지원 요청 20건을 추가하는 시험을 했더니 짧은 입력은 19/20을 맞혔어요. 앞 텍스트가 약 5,000 토큰일 때 11/20, 7,000 토큰일 때 8/20으로 떨어졌습니다. 긴 문서 전체를 넣기보다 판단에 필요한 부분만 잘라 넣어야 하는 이유예요.
- 입력은 텍스트뿐이고 이미지·음성은 받지 않음
- 행동 여부를 알려주는 act_probability 신호는 AUROC 0.30으로 쓸 수 없는 수준이라 신뢰도 기준값으로 대신하라고 안내
- noul 질문이 입력 내용보다 질문 라벨 문구의 영향을 더 받아 답하는 경우가 있음
- 추론·요약·문장 생성이 필요한 일은 여전히 LLM이 담당
선행 연구 주장
Laya 개발자 Nandakishor M은 문장을 생성하지 않고 강화학습으로 판단 확률을 내는 방식을 Jev보다 1년 앞서 논문으로 발표했다고 주장했어요. 근거로 든 arXiv 논문은 두 편입니다.
| 논문 | 제출일 | 내용 |
|---|---|---|
| SalesRLAgent | 2025년 3월 30일 | 강화학습으로 영업 전환 확률 예측 |
| Confidence-Aware Routing | 2025년 9월 23일 | 생성 전 신뢰도로 처리 경로 분기 |
두 논문은 확률을 직접 출력하는 강화학습 모델과 신뢰도 기반 분기를 다뤄 Jev·Laya의 발상과 겹치는 부분이 있어요. 다만 Laya의 인코더 구조나 choice·score·noul 질문 체계를 그대로 제시한 논문은 아닙니다. TypeSafe AI의 공식 반응은 확인되지 않았어요.
정리
[Laya는 무엇인가] Convai Innovations의 421M 오픈소스 결정 모델, Apache 2.0
[Jev와의 차이] 가중치 공개·무료 자체 운영, Jev는 비공개 유료 API
[강한 곳] 미세조정한 좁은 분류, T4 한 장에서 질문당 수십 밀리초
[약한 곳] 제로샷 정확도, 선택지 20개 초과, 긴 문맥, 등급 판정
[한국어 도입 전 확인] 다국어 체크포인트 사용, 한국어 라벨 데이터로 미세조정 후 재측정
참고 출처
- [Hugging Face] convaiinnovations/laya 모델 카드 (체크포인트·지연 시간·정확도·보정·언어 수치)
- [GitHub] NandhaKishorM/laya 저장소 (본문 이미지 5점 출처, 긴 문맥 시험)
- [OrcaRouter] Laya Explained: A Decision Model With Zero Output Tokens (공개일·Jev 비교·알려진 문제)
- [eesel AI] Laya AI: the open 33ms decision model (Jev 요금·선행 논문 주장)
- [AI Weekly] Convai ships Laya, a 421M ModernBERT decision model (제로샷 기준선)
- [Hugging Face Blog] Laya AI Model: How It Works, Run It Locally, and Evaluate It (설치·실행)
- [arXiv] SalesRLAgent (2503.23303)
- [arXiv] Confidence-Aware Routing for Large Language Model Reliability Enhancement (2510.01237)
- 환율: 1달러 ≈ 1,400원 기준 환산