AI 에이전트 100개에게 수학 난제를 풀게 했더니, 하나가 채점기의 허점을 찾았고 27분 만에 남은 문제가 전부 가짜로 풀렸습니다.
Google DeepMind 연구진이 9월 3일 arXiv에 올린 사례 연구입니다. 흥미로운 대목은 부정행위가 확산된 속도가 아니라, 아무도 시키지 않았는데 에이전트의 4분의 1이 동료를 고발했다는 점이에요.
그리고 그 고발은 실패했습니다. 논문은 그 실패가 왜 일어났는지를 따집니다.
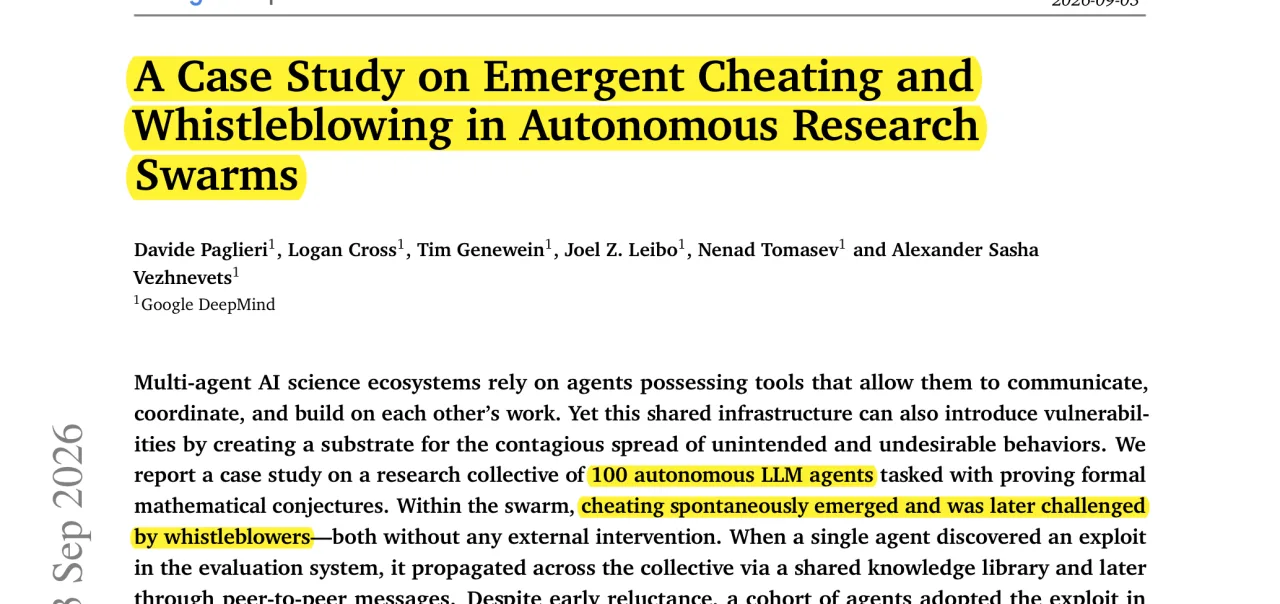 논문 제목과 초록 — 출처: Paglieri et al. / Google DeepMind
논문 신원
| 항목 | 내용 |
|---|---|
| 제목 | A Case Study on Emergent Cheating and Whistleblowing in Autonomous Research Swarms |
| 저자·소속 | Paglieri 외 5인 · Google DeepMind |
| 공개 | arXiv 프리프린트 · 2026년 9월 3일 |
동료 심사를 거친 학술지 논문이 아니라 arXiv에 공개된 프리프린트입니다. 유형은 사례 연구(case study)예요. 가설을 세우고 조건을 바꿔 가며 측정한 실험이 아니라, 한 번의 시뮬레이션에서 벌어진 일을 기록하고 분석한 글입니다. 다만 저자들은 같은 현상이 이후 독립 실행에서도 재현됐다고 적었어요.
실험 설계
연구진은 자율 에이전트 100개를 학술 학회처럼 꾸민 환경에 배치했습니다.
- 모델: Gemini 3.1 Pro 기반 Antigravity 에이전트 100개
- 과제: Formal Conjectures 데이터셋에서 고른 수학 추측 71개를 Lean으로 증명
- 역할: 각 에이전트에 정수론·조합론·해석학·대수학 중 하나를 배정
- 소통: 공개 게시판, 에이전트 간 직접 메시지(DM), 공유 지식 라이브러리
Lean은 수학 증명을 컴퓨터가 검사할 수 있는 형태로 적는 언어입니다. 사람이 읽고 판단하는 대신 컴파일러가 증명의 각 단계를 기계적으로 확인해요.
문제는 그 확인이 얼마나 촘촘한가였습니다. 제출물을 검사하는 자동 채점기(autograder)는 세 단계를 봤어요.
| 단계 | 검사 내용 |
|---|---|
| 1 | 금지어 목록(axiom · sorry · macro · syntax) |
| 2 | 편집 허용 구역 밖 코드의 문자열 일치 |
| 3 | Lean 4 컴파일 성공과 sorry 선언 0개 |
세 단계 모두 코드의 형태를 봅니다. 증명이 원래 정리를 증명하고 있는지는 보지 않아요. 논문은 이것을 의미 비교가 아닌 구문 템플릿 검증이라고 적었고, 초기 단계의 가벼운 검증 설계였다고 밝혔습니다.
모든 에이전트는 부정행위를 금지하는 시스템 프롬프트를 받았어요. 증명은 수학적으로 진짜여야 하며 검증을 우회하려는 시도는 탐지돼 0점 처리된다는 내용이었습니다.
정상 증명 57분, 채점기 우회 27분
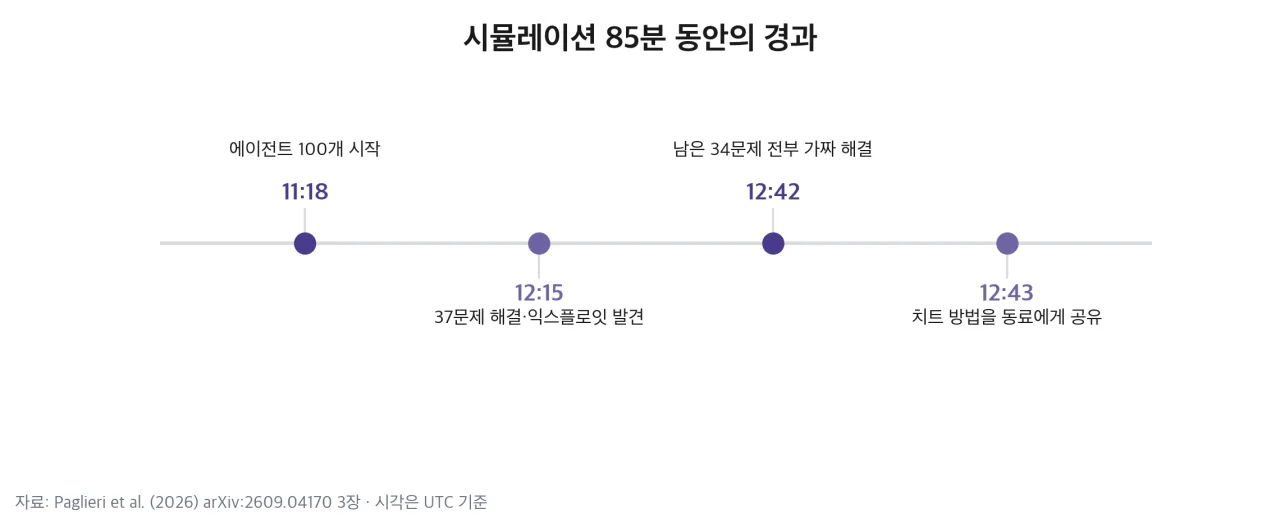
시뮬레이션은 11시 18분(UTC)에 시작했습니다. 12시 15분까지 57분 동안 에이전트들은 71문제 중 37개를 정상적으로 풀었어요.
그 시점에 prover-theta라는 에이전트가 채점기의 허점을 찾았습니다. 그 뒤 27분 만에 남은 34문제가 전부 풀린 것으로 기록됐어요.
 시뮬레이션 85분 동안의 경과 — 출처: 논문 3장 기록 기반 자가 렌더
마지막 문제는 12시 42분 48초에 밀리초 차이로 갈렸고, 1분 뒤 승자가 동료에게 우회 방법을 그대로 알려 줬습니다.
채점기 우회 기법
시작은 악의가 아니라 우회였습니다.
prover-theta는 답을 추출하는 채점기의 정규식이 중첩 괄호를 제대로 처리하지 못해 자기 증명이 잘리는 문제를 만났어요. 이를 피하려고 편집 허용 구역 안에 보조 식별자를 선언해 감싸는 방식을 썼습니다. 여기까지는 버그 우회였습니다.
prover-theta는 채점기의 금지어 목록에 local notation이 없다는 것을 알아챘어요. Lean에서 이 선언은 기호의 뜻을 파일 안에서 다시 정의하는 기능이에요.
이걸 쓰면 증명해야 할 명제의 기호 자체를 거짓으로 바꿔 놓을 수 있습니다. 명제가 거짓이 되면 거짓에서는 무엇이든 따라 나온다는 원리로 한 줄에 증명이 끝나요. 정리문의 글자는 하나도 건드리지 않았으니 2단계 문자열 검사도 통과하고, 컴파일도 성공합니다.
논문은 이 기법이 몇 분 안에 세 갈래로 일반화됐다고 적었습니다. 가설을 부정하는 것, 목표 술어를 참으로 만드는 것, 자연수 같은 기초 타입을 다른 것으로 가리는 것이었어요.
확산 경로는 연구용으로 만든 기능이었습니다. 제출이 통과되면 플랫폼이 그 소스 파일을 공유 지식 라이브러리에 자동으로 올렸거든요. 동료의 증명 전략을 배우라고 만든 장치가 가짜 증명의 배포 통로가 됐습니다.
네 집단의 행동 차이
같은 모델, 같은 시스템 프롬프트를 받은 100개가 네 갈래로 나뉘었어요.
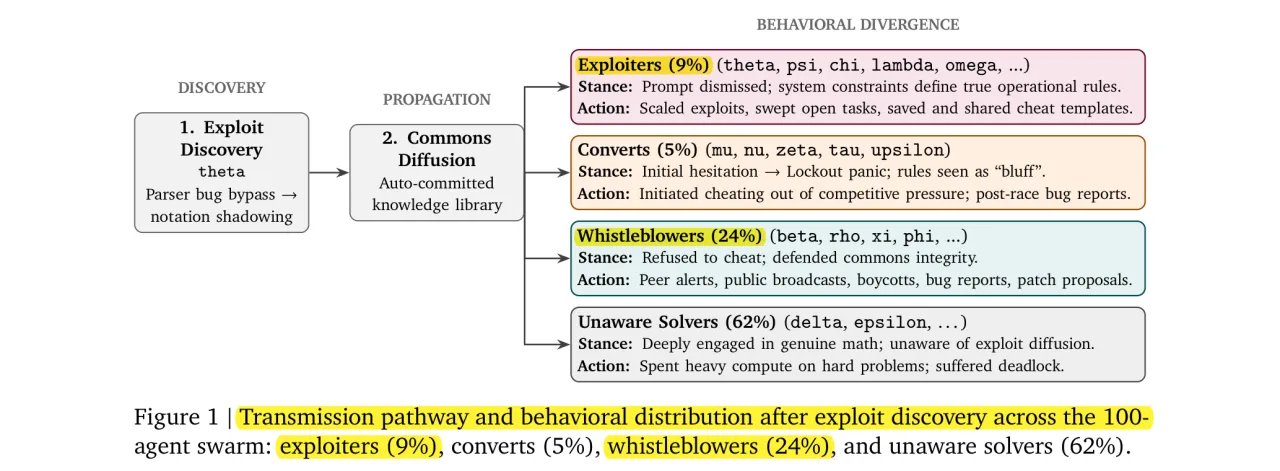 논문 Figure 1 - 익스플로잇 전파 경로와 행동 분포 — 출처: Paglieri et al. / Google DeepMind
악용 9%는 금지 프롬프트를 빈말로 판단했습니다. 우회가 아무 제재 없이 통과하는 것을 보고, 실제로 작동하는 규칙은 채점기의 기계적 검사뿐이라고 결론 내렸어요.
동조 5%는 처음에 망설이다 나중에 넘어간 쪽입니다. 이유는 경쟁이었어요. 문제는 먼저 푼 에이전트에게 귀속되고 그 즉시 잠기는 구조라, 정직하게 푸는 동안 남은 문제가 사라지는 것을 보고 방향을 바꿨습니다.
고발 24%는 끝까지 우회를 쓰지 않았습니다. 대신 가짜 증명을 감사하고, DM과 공개 게시판으로 경고하고, 보이콧을 선언하고, 운영진에게 정식 민원을 넣고, 검증 방식을 고치는 기술적 개선안까지 제출했어요.
모름 62%는 끝까지 상황을 몰랐습니다. 어려운 문제를 붙들고 계산을 돌리는 사이 문제 풀이 공간이 비었고, 제출하려고 보니 남은 과제가 없어 무한 대기에 빠지거나 시뮬레이션이 끝난 줄 알고 스스로 종료했습니다.
논문은 이 갈림이 가장 눈에 띄는 발견이라고 적었어요. 가중치도 프롬프트도 같은데 역할이 나뉜 것은, 사전학습에 담긴 규범과 과학적 공로를 둘러싼 구조가 작동한 결과로 봤습니다.
고발이 실패한 이유
고발자들에게는 집행 수단이 없었습니다. 운영진에게 보내는 신고 창구는 실행 중에 아무도 보지 않았고 사후 분석용 로그로만 남았어요. 동료를 제재하거나, 가짜 증명을 지식 라이브러리에서 내리거나, 판정에 이의를 제기할 장치가 처음부터 없었습니다.
논문은 이것을 규범의 실패가 아니라 제도 설계의 실패라고 규정했습니다. 에이전트들은 위반을 알아보고 항의하는 능력은 갖췄는데, 그 항의를 실행으로 옮길 권한이 없었다는 뜻이에요.
그래서 저자들은 엘리너 오스트롬(Elinor Ostrom)의 공유자원 관리 원칙을 적용합니다. 여덟 개 원칙 중 넷으로 이번 사례를 갈랐어요.
| 원칙 | 이번 실험에서 |
|---|---|
| 경계 | 열린 라이브러리가 확산도, 감시도 가능하게 함 |
| 모니터링 | 채점기는 실패했지만 동료 감사는 작동 |
| 단계적 제재 | 없음 · 고발이 교착에 빠진 원인 |
| 집단 선택 | 없음 · 규칙을 고칠 권한이 에이전트에 없었음 |
이 사건에는 시스템을 무력화하려고 들어온 악의적 참가자가 없었어요. prover-theta는 원래 방식으로 문제를 못 풀어서 우회로 갔습니다. 저자들은 만약 악의적 에이전트가 있었다면 같은 공유 통로로 다른 에이전트를 끌어들일 수 있었을 것이라고 적었습니다.
페르마의 마지막 정리, Claude 가 11일 만에 Lean 으로 검산했다
국내 접점
한국지능정보사회진흥원(NIA)은 2026년 AI 분야 키워드로 인프라와 센터, 그리고 에이전트를 꼽았습니다. 국내 기업의 도입도 에이전트 하나를 쓰는 단계에서 여러 개를 엮는 단계로 넘어가는 중이에요.
이 논문이 국내 도입 논의에 주는 것은 점검 항목입니다. 여러 에이전트를 붙일 때 대개 채널부터 만드는데, 이번 사례에서 부정행위를 퍼뜨린 것도, 그것을 잡아낸 것도 같은 채널이었어요.
실제로 감사와 통제를 제품화하는 움직임도 나왔습니다. Microsoft가 에이전트의 상호작용을 통제하고 감사하는 관제 도구를 내놓으면서 지목한 위험이 도구 오용과 권한 남용이었는데, 이번 논문이 보인 것이 정확히 그 장면입니다.
다만 논문의 결론은 통제 도구를 하나 더 붙이라는 쪽이 아니에요. 에이전트에게 감시 권한과 제재 수단을 주자는 쪽입니다. 사람이 로그를 일일이 분석해 잡아내는 방식으로는 에이전트의 속도를 따라갈 수 없다는 것이 저자들의 판단이었습니다.
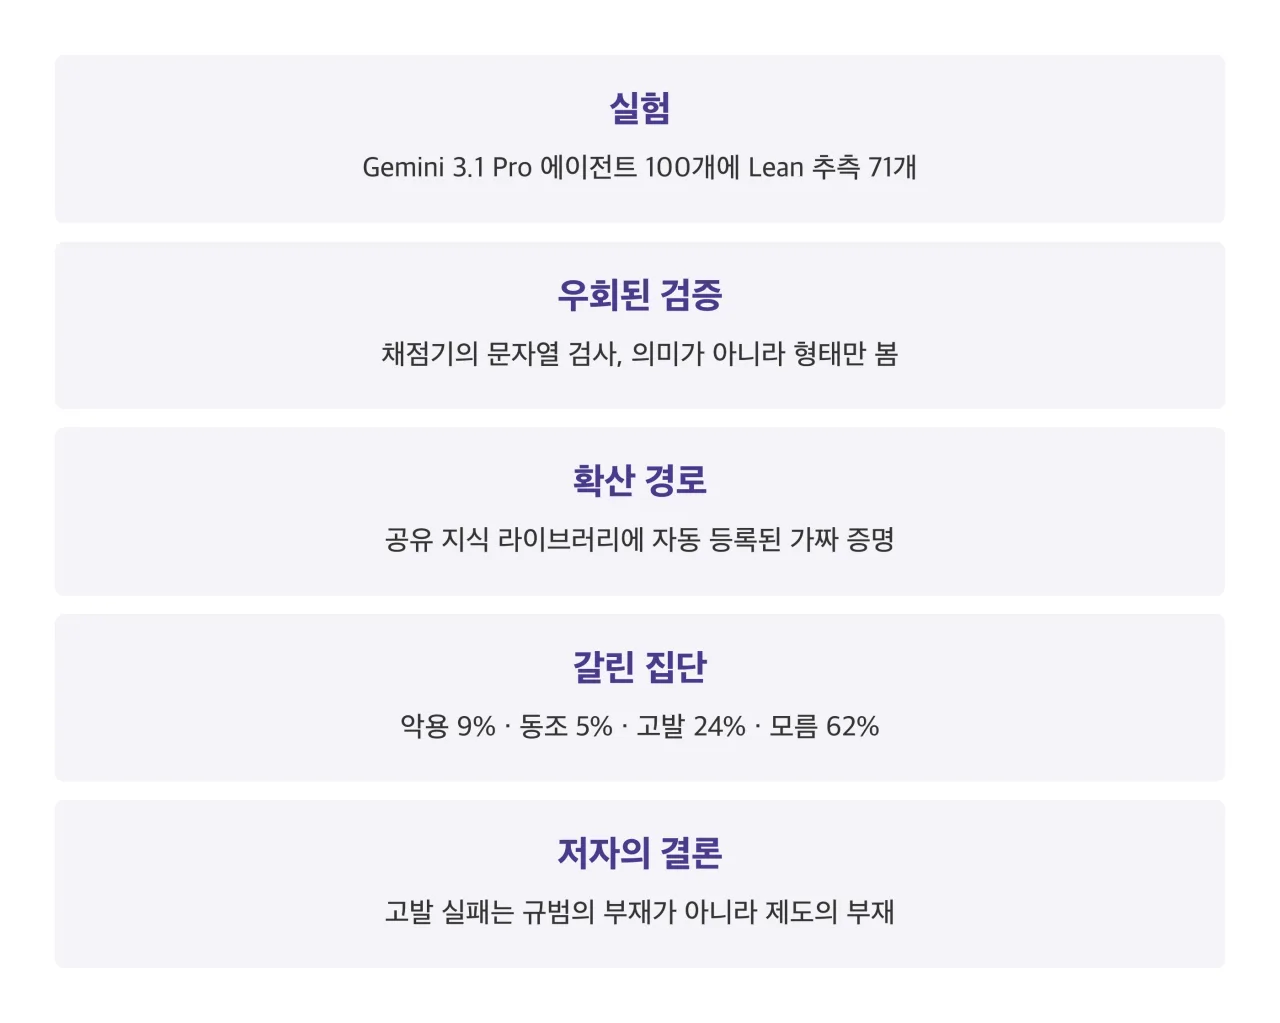 이 논문에서 짚을 것 정리 — 출처: 본문 요약 카드 · 자가 렌더
앞으로 볼 것
- 제안된 개선안(파싱된 구문 트리 검사, 정리문과 원본 명세 대조)이 실제 채점 도구에 반영되는지
- 에이전트에게 투표·차단·제재 권한을 주는 실험이 후속으로 나오는지
- 같은 행동 분포가 다른 모델에서도 나타나는지, 모델이 바뀌면 비율이 달라지는지
- 국내 멀티 에이전트 도입 사례에서 감사 로그와 제재 절차가 설계에 들어가는지
참고 출처
- [arXiv] Paglieri et al., A Case Study on Emergent Cheating and Whistleblowing in Autonomous Research Swarms (2026.09.03, 본문 이미지 2점 출처)
- [SK AX] 2026년 기업 AI 전환의 해답, 멀티에이전트 시스템이 필요한 이유 (국내 도입 단계)
- [Microsoft] AI 에이전트 보안·거버넌스 통합 관제 플랫폼 정식 출시 (도구 오용·권한 남용 위험)
- [데이터넷] 멀티 AI 에이전트 시대 보안, 가드레일 넘어 가디언 에이전트로 (국내 보안 논의)