Meta가 공개한 Muse Spark Open은 파라미터가 8,160억 개(816B)입니다. 이 숫자 하나로 필요한 GPU 메모리를 대략 계산할 수 있어요.
 거대 모델 가중치가 여러 GPU 메모리에 나뉘어 올라가는 개념 컷 — 출처: 개념 컷 · agy 자가 생성
기본 계산식
모델 파일은 각 파라미터의 값을 숫자로 저장한 데이터라, 용량은 파라미터 수에 숫자 하나의 크기를 곱하면 나와요.
가중치 용량(바이트) = 파라미터 수 × 정밀도별 바이트
| 정밀도 | 숫자 하나 | 816B 모델 |
|---|---|---|
| FP32 | 4바이트 | 3,288GB |
| BF16 | 2바이트 | 1,644GB |
| FP8 | 1바이트 | 822GB |
| FP4 | 0.5바이트 | 411GB |
정밀도는 숫자 하나를 몇 비트로 표현하느냐를 말해요. 학습은 보통 BF16(16비트)으로 하고, 배포할 때 FP8·FP4처럼 비트를 줄이는 양자화(quantization)로 용량을 줄입니다. 비트가 줄면 표현할 수 있는 값의 종류가 줄어 정확도가 조금 떨어질 수 있어요.
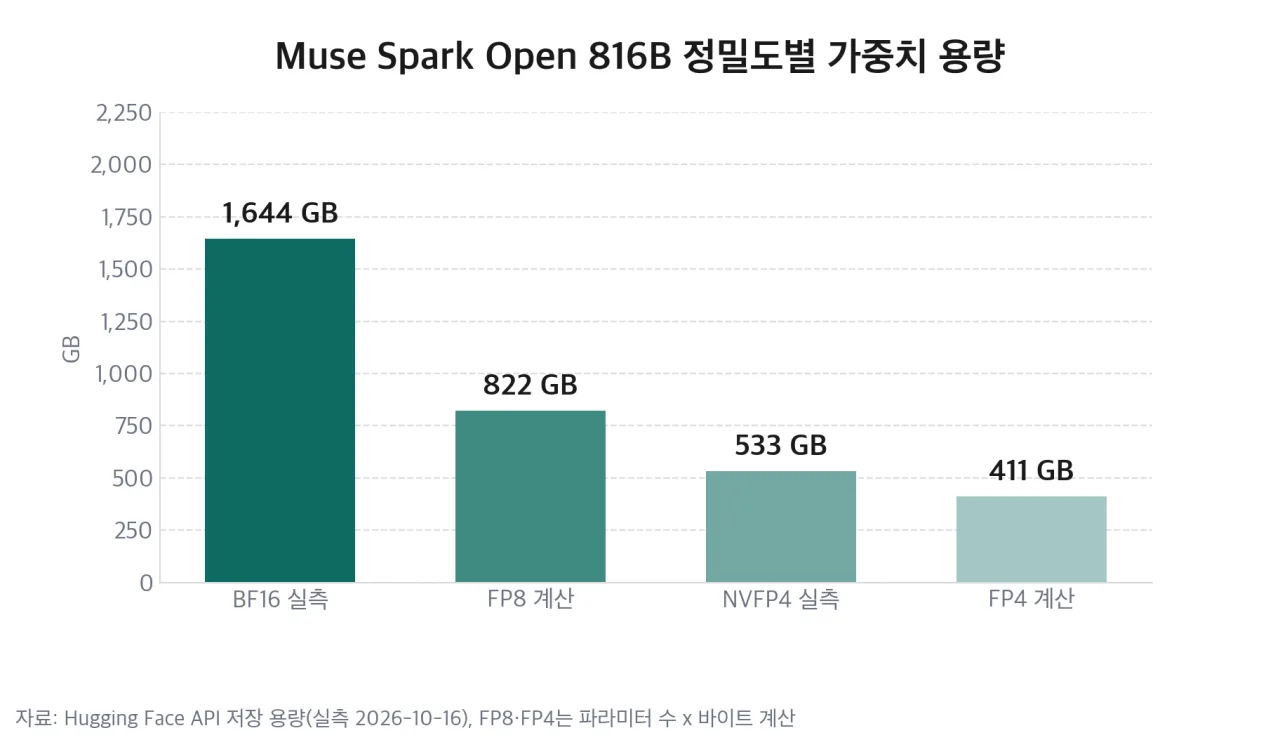 816B 모델의 정밀도별 가중치 용량 비교 — 출처: Hugging Face API 실측 기반 자가 렌더
실제 파일과 맞춰 보기
Hugging Face API는 저장소마다 텐서 정밀도별 개수와 실제 저장 용량을 반환해요. 계정 없이도 조회됩니다.
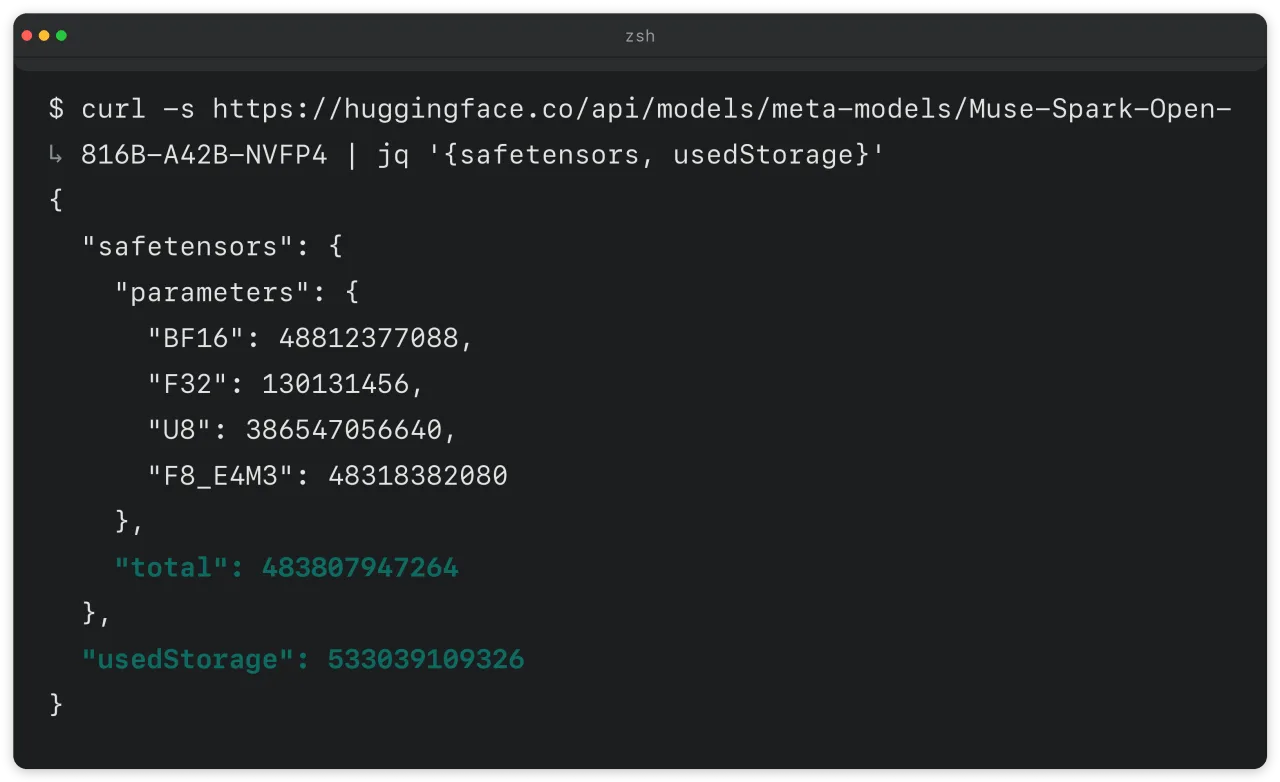 Hugging Face API로 Muse Spark Open NVFP4판 텐서 구성 조회 — 출처: Hugging Face API 실행 화면 자가 렌더
BF16판은 파라미터 822,036,529,664개, 저장 용량 1,644GB로 계산식(× 2바이트)과 거의 일치했어요. 모델 이름의 816B보다 실제 파라미터가 조금 많은 것은 이미지·음성을 받는 인식 인코더(18억 개)와 입력·출력 임베딩(약 33억 개)이 더해졌기 때문으로 보입니다.
NVFP4판은 계산값 411GB보다 많은 533GB였어요.
[양자화 스케일] NVFP4는 값 16개마다 FP8 스케일 하나를 붙여 값당 약 4.5비트, 스케일만 48.3GB
[BF16으로 남긴 부분] 파라미터 488억 개는 4비트로 줄이지 않고 BF16으로 둬서 97.6GB
FP4로 양자화된 파라미터는 7,731억 개(1바이트에 2개씩 담아 386.5GB)이고, 여기에 스케일과 BF16 유지분, FP32 0.5GB가 더해져 533GB가 됐어요. 양자화 모델 용량은 파라미터 × 0.5바이트보다 20~30% 여유를 두고 산정하는 것이 안전합니다.
KV 캐시, 대화 길이만큼 늘어나는 메모리
가중치만 메모리에 적재해서는 모델을 실행할 수 없어요. 모델은 대화의 앞부분을 다시 계산하지 않으려고 토큰마다 Key·Value 값을 저장해 두는데, 이것이 KV 캐시입니다. 입력이 길수록 커져요.
KV 캐시(바이트) = 2 × 층 수 × KV 헤드 수 × 헤드 차원 × 바이트 × 토큰 수
모델 카드에 적힌 Muse Spark Open 구조(62층, KV 헤드 16개, 헤드 차원 64)를 BF16 캐시로 저장하면 토큰 하나에 약 254KB예요.
| 컨텍스트 | KV 캐시 |
|---|---|
| 3만 2천 토큰 | 8.3GB |
| 12만 8천 토큰 | 33.3GB |
| 100만 토큰 | 266GB |
이 값은 모든 층이 전체 문맥을 본다고 가정한 상한이에요. 일부 층만 짧은 구간을 보는 구조를 쓰거나 캐시를 FP8로 줄이면 더 작아지고, 동시에 여러 요청을 받으면 요청 수만큼 늘어납니다.
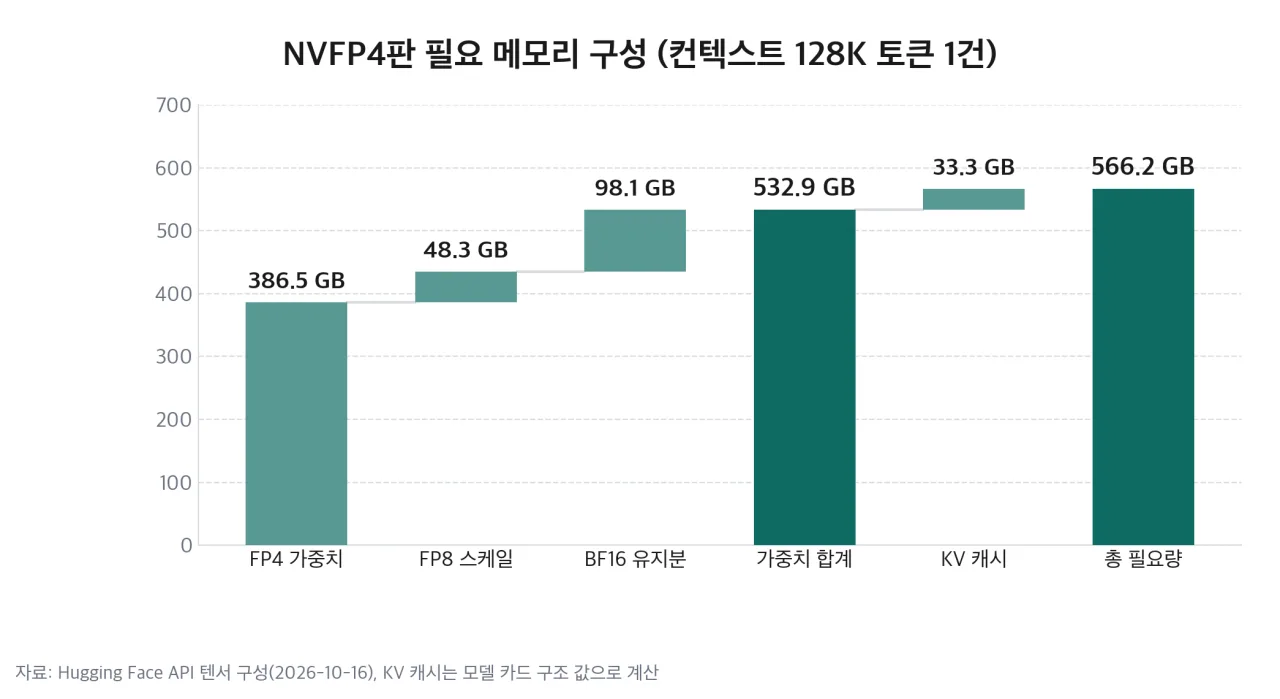 NVFP4판 가중치와 128K 토큰 KV 캐시를 합친 필요 메모리 구성 — 출처: Hugging Face API·모델 카드 기반 자가 렌더
가중치 533GB에 128K 토큰 캐시 33GB를 더하면 566GB예요. 모델 카드가 NVFP4 기준 VRAM 700GB 이상을 권한 것은 여기에 실행 중 계산 버퍼와 여러 요청 처리분을 더한 값으로 보여요. BF16판은 가중치만 1,644GB라 모델 카드에도 필요 메모리가 2TB로 적혀 있습니다.
MoE 모델의 메모리 요구량과 연산량
Muse Spark Open은 전문가 혼합(MoE) 구조라 토큰마다 전문가 256개 중 8개, 파라미터로는 약 420억 개(42B)만 계산에 씁니다. 그래서 생성 속도와 계산량은 42B급 모델에 가까워요.
반면 어느 토큰이 어느 전문가로 갈지 미리 알 수 없어서 메모리에는 전체 816B 파라미터를 적재해야 해요. MoE 모델의 이름에 붙은 활성 파라미터 수(A42B)는 속도를 가늠하는 값이고, 필요한 메모리는 전체 파라미터 수로 계산합니다.
다른 오픈 가중치 모델에 대입하기
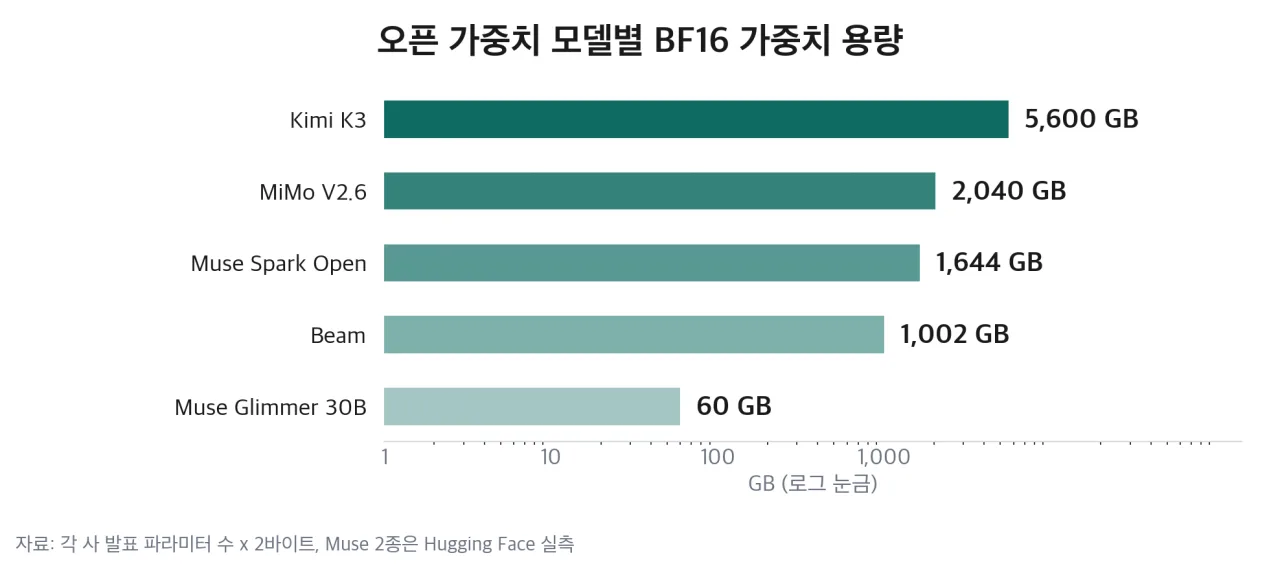 오픈 가중치 모델별 BF16 가중치 용량 비교 — 출처: 각 사 발표 파라미터 수·Hugging Face 실측 기반 자가 렌더
2.8조 파라미터인 Kimi K3는 BF16 가중치만 5.6TB이고, 같은 Meta의 Muse Glimmer 30B는 60GB라 80GB GPU 한 장에 들어갑니다. 300억 개 안팎 모델은 FP4로 줄이면 15~20GB라 32GB 메모리 PC에서도 실행할 수 있어요. MacBook에서 Gemma 4를 크기별로 돌려 본 결과는 따로 정리했어요.
🔗 링크 첨부 - https://blog.naver.com/rottensweetpotato/224379118246
GPU 최소 필요 수량
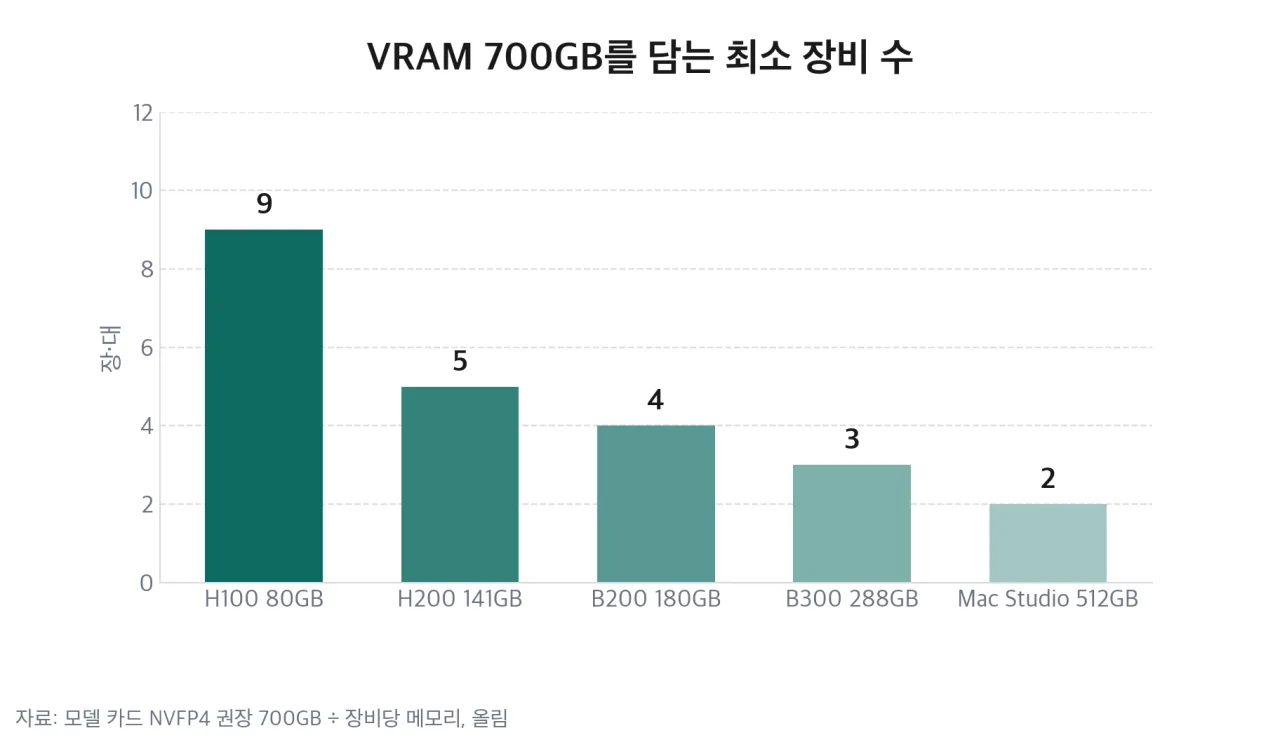 VRAM 700GB를 담는 장비별 최소 수량 — 출처: 모델 카드 기반 자가 렌더
모델 카드 기준 700GB를 장비당 메모리로 나누면 최소 수량을 계산할 수 있어요. H100(80GB)은 9장, H200(141GB)은 5장, B200(180GB)은 4장, B300(288GB)은 3장, 512GB 통합 메모리를 단 M5 Ultra Mac Studio는 2대입니다.
여러 GPU에 모델을 나눠 올리는 텐서 병렬은 보통 2·4·8장 단위로 묶기 때문에, H100 8장 서버는 총 640GB라 요구 메모리에 미치지 못하고 서버 두 대(16장)가 필요해요. H200은 8장 서버 한 대(1,128GB)에 들어갑니다. Mac Studio 두 대는 Meta가 Apple MLX로 연결해 모델을 실행할 수 있다고 밝힌 구성이에요.
원화로 환산한 비용
국내 GPU 클라우드 VESSL Cloud는 가격 페이지에 H100 80GB GPU의 시간당 요금이 GPU당 약 4,170원(2.98달러)부터라고 적었어요. H100 16장이면 시간당 약 6만 6,800원, 한 달(720시간) 내내 켜 두면 약 4,806만 원입니다. 네이버클라우드는 GPU 서버 요금을 요금 계산기에서만 보여 줘서 공개 단가로 비교하지 못했어요. 같은 모델을 API로 이용하는 편이 비용이 적게 드는지는 하루 처리량에 따라 달라집니다.
정리
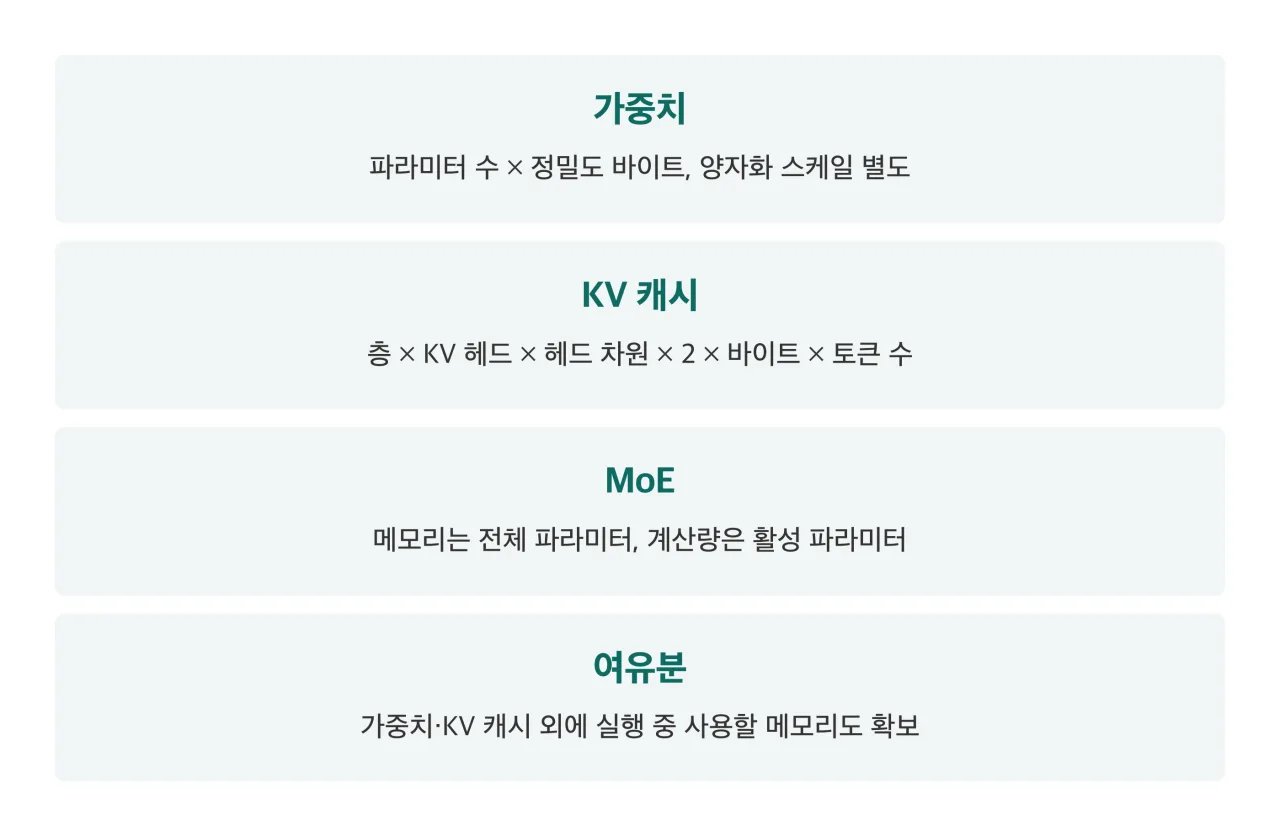 GPU 메모리 계산 네 가지 정리 — 출처: 자가 렌더
참고 출처
- [Hugging Face] Muse-Spark-Open-816B-A42B 모델 카드 (구조·요구 메모리)
- [Hugging Face API] NVFP4판 텐서 구성·저장 용량 (2026-10-16 조회)
- [Meta] Muse Spark Open 발표 (M5 Ultra Mac Studio 두 대 실행)
- [NVIDIA Research] Pushing Intelligence to 4-bit (NVFP4 16값 블록·약 4.5비트)
- [VESSL] NVIDIA GPU 클라우드 가격 (H100 시간당 요금, 2026-10-16 확인)
- 환율: 1달러 ≈ 1,400원 기준 환산