DeepMind 출신이 설립한 Reflection AI가 10월 5일 첫 프런티어급 오픈 가중치 모델 Beam을 공개했어요. 전체 파라미터 5,010억 개 가운데 한 번에 230억 개만 사용하는 전문가 혼합(MoE) 구조입니다.
가중치는 10월 안에 Apache 2.0 라이선스로 공개될 예정이라, 다운로드해 사내 서버에서 실행하고 수정해 사용하는 것까지 허용됩니다. 중국 모델이 차지한 오픈 가중치 상위권에 미국 회사가 공개한 모델이에요.
 Beam 키 비주얼 — 출처: Reflection AI
사건 경과
 Reflection 로고
Reflection AI는 2024년 3월 Google DeepMind 연구자였던 미샤 라스킨(Misha Laskin, CEO)과 이오아니스 안토노글루(Ioannis Antonoglou, CTO)가 설립한 회사예요. 안토노글루는 AlphaGo 개발에 참여했던 연구자입니다.
발표가 먼저 이뤄지고 가중치는 이후에 공개돼요. 회사는 Beam이 마지막 레드팀(공격 시험)과 평가를 거치는 중이며, 이달 안에 가중치와 기술 보고서, 모델 카드, 실행·평가·파인튜닝 도구를 함께 공개하겠다고 밝혔습니다. 그 전까지는 얼리 액세스 신청만 받습니다.
- 10월 5일: Beam 발표, 얼리 액세스 신청 시작
- 10월 중: 가중치·기술 보고서 공개 예정 (Apache 2.0)
모델 사양
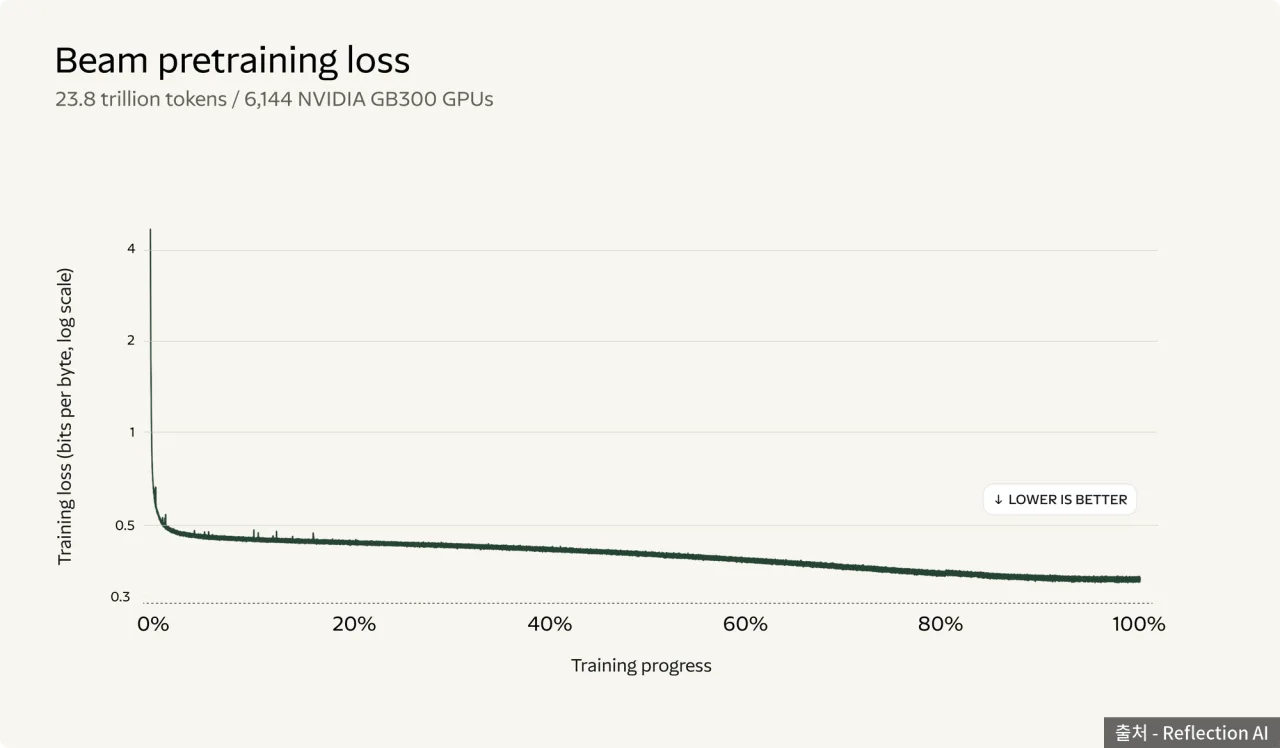 Beam 사전학습 손실 곡선 — 출처: Reflection AI
| 항목 | Beam |
|---|---|
| 전체 파라미터 | 5,010억 개 |
| 활성 파라미터 | 230억 개 |
| 구조 | 희소 MoE |
| 사전학습 데이터 | 23.8조 토큰 |
| 문맥 길이 | 최대 100만 토큰 |
| 라이선스 | Apache 2.0 |
MoE는 수많은 전문가 블록 가운데 토큰마다 일부만 선택해 계산하는 구조예요. 그래서 계산량은 230억 개 모델 수준이지만, 메모리에는 5,010억 개를 모두 적재해야 합니다.
사전학습에는 NVIDIA GB300 GPU 6,144개를 4주 미만 사용했고, 이후 강화학습에 GB300 1만 500개로 4주 동안 1억 회 넘는 시도(rollout)를 실행했다고 회사는 밝혔어요. 강화학습은 25만 6,000 토큰 길이로 했고, 중간 학습으로 문맥을 100만 토큰까지 확장했습니다.
벤치마크 점수
Reflection AI 공개 수치에서 Beam은 중국 Z.ai의 GLM-5.2와 비슷한 점수를 기록했어요.
| 벤치마크 | Beam | GLM-5.2 |
|---|---|---|
| DeepSWE v1.1 | 44.4 | 44.0 |
| Terminal Bench v2.1 | 80.1 | 81.0 |
| AIME 2026 | 97.8 | 99.2 |
| GPQA Diamond | 90.5 | 91.2 |
| SWE Bench Pro v2-Hard | 77.2 | 미공개 |
| SciCode | 49.7 | 미공개 |
같은 공개 수치에서 Moonshot AI의 Kimi K3는 점수가 공개된 다섯 항목 모두 Beam보다 높았어요. DeepSWE v1.1은 68.0, Terminal Bench v2.1은 88.3입니다. Alibaba의 Qwen 3.8-Max도 네 항목에서 Beam을 앞섰어요.
점수는 모두 Reflection AI가 직접 측정한 값이고, 가중치가 공개되기 전이라 외부에서 재현한 결과는 없습니다.
추론 연산 효율 주장
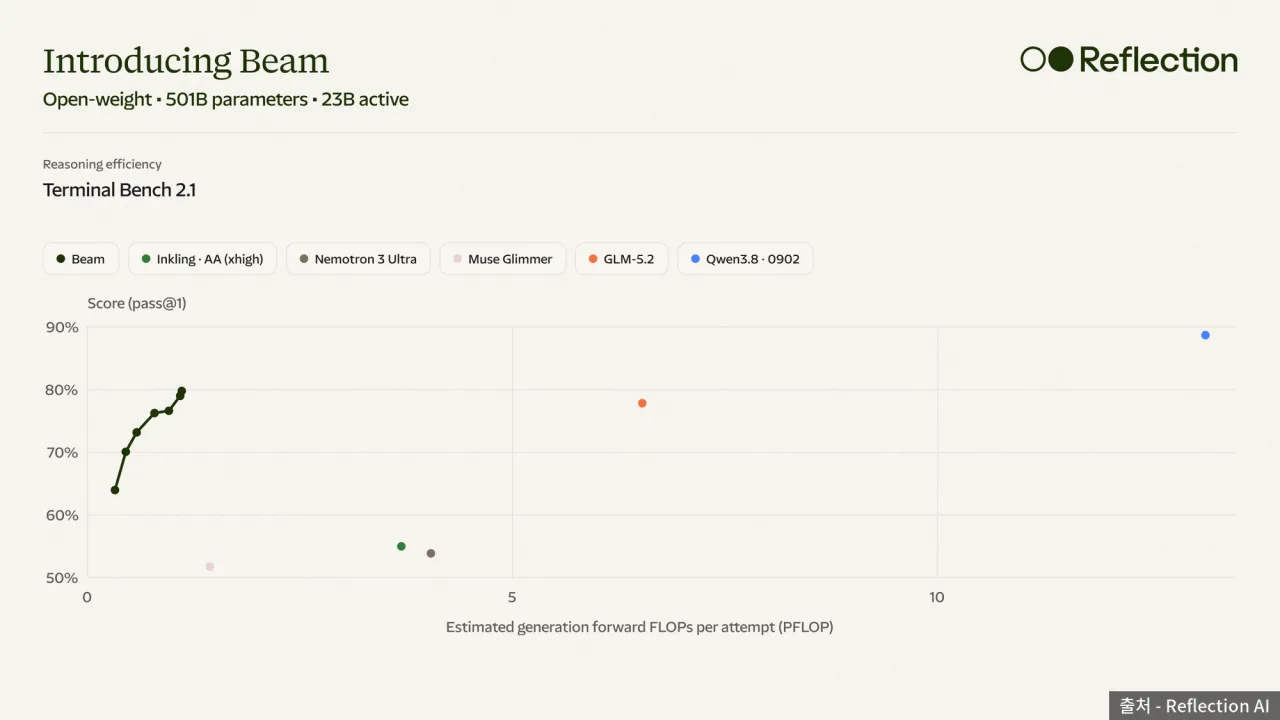 Terminal Bench 2.1 점수와 생성 연산량 — 출처: Reflection AI
Reflection AI는 점수보다 추론 연산량을 강조합니다. 고난도 추론 벤치마크에서 GLM-5.2와 비슷한 점수를 내면서 추론 연산은 3~4배 적게 사용한다고 주장합니다.
비교에는 한 번 답변을 생성할 때 필요한 연산량(PFLOP)과 점수를 썼어요. 라스킨 CEO는 대규모 강화학습으로 토큰 비용과 추론 연산의 일부만 사용하고도 경쟁력 있는 성능을 기록했다고 말했습니다. 답변을 짧게 생성하도록 길이 벌점을 조절하는 학습이 들어갔다고 하는데, 이 효율 역시 독립 검증 전이에요.
오픈 가중치 경쟁 구도
오픈 가중치 상위권은 Kimi K3, DeepSeek V4, GLM-5.2·5.3 같은 중국 모델이 차지해 왔어요. 미국 쪽에서는 Thinking Machines Lab이 7월 Inkling을 냈고 NVIDIA가 Nemotron을 내고 있지만, Fortune은 Beam을 중국 모델과 직접 경쟁하려는 새 미국 모델로 봤습니다.
자금 규모도 큽니다. Reflection AI는 2025년 10월 NVIDIA가 주도한 투자에서 약 2조 8,000억 원(20억 달러)을 받았고, 라스킨 CEO는 4월 기업가치가 약 35조 원(250억 달러)이라고 밝혔어요. 5월에는 미국 에너지부·전쟁부에 모델을 공급하는 협력도 맺었습니다.
국내 기업이 쓰려면
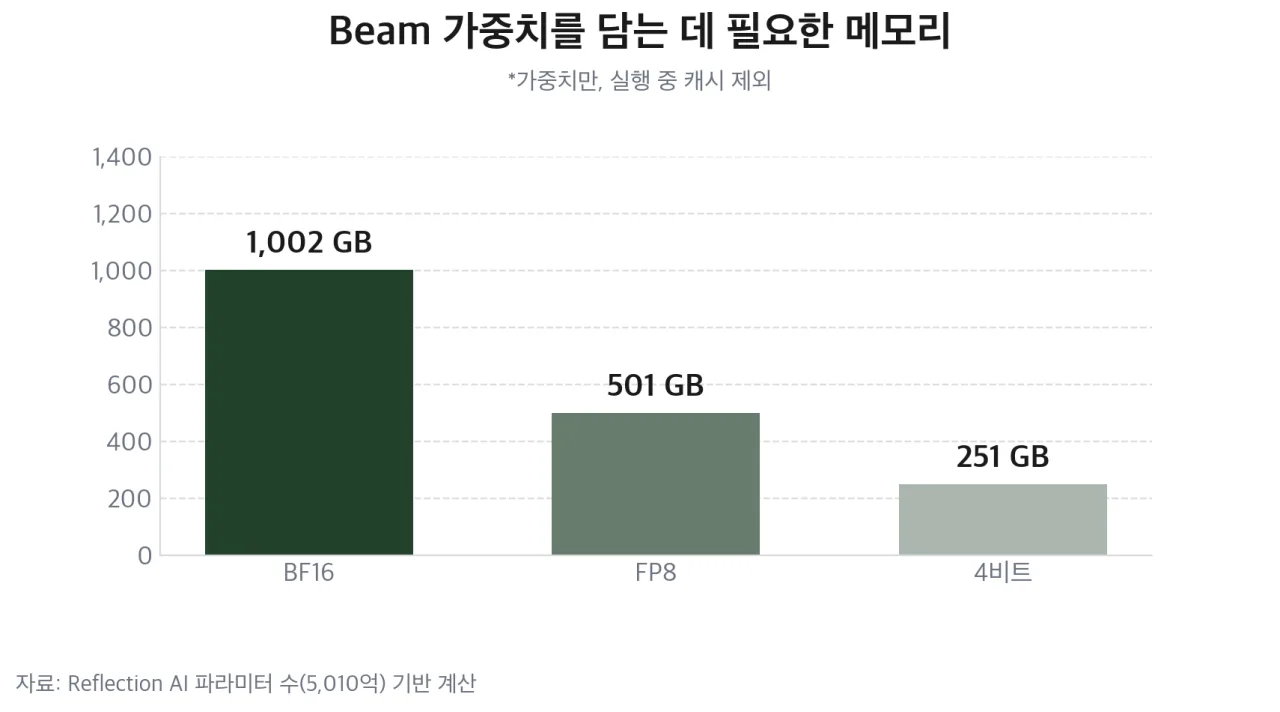 Beam 가중치를 담는 데 필요한 메모리 — 출처: Reflection AI 파라미터 수 기반 자가 렌더
Apache 2.0은 상업적 이용·수정·재배포를 허용하고 특허 사용권도 함께 주는 라이선스예요. 사용자 수나 매출 상한을 두지 않아, 국내 기업이 사내 서버에 배포해 고객 데이터를 외부로 전송하지 않고 쓰는 데 조건이 붙지 않습니다.
제약 요인은 하드웨어예요. 가중치만 FP8(파라미터당 1바이트)로 약 501GB, BF16(2바이트)으로 약 1TB라서, FP8로도 80GB GPU 8장(640GB)에 실행 중 캐시까지 포함하기에는 용량이 부족할 수 있습니다. 141GB급 GPU 8장 서버나 4비트 양자화가 현실적인 선택이고, 4비트는 정확도가 얼마나 하락하는지 공개 뒤에 확인해야 해요.
국내에서는 LG AI연구원·업스테이지·SK텔레콤 등이 정부의 독자 AI 파운데이션 모델 사업으로 자체 모델을 만들고 있어요. Beam 가중치가 공개되면 이 모델들과 같은 조건에서 비교할 수 있는 미국산 비교 기준 모델이 하나 더 추가됩니다.
앞으로 주목할 점
- 10월 안에 가중치와 기술 보고서가 실제로 공개되는지
- 외부 평가 기관이 재현한 벤치마크 점수
- 3~4배 적은 추론 연산 주장이 실제 토큰 사용량으로 확인되는지
- 국내 클라우드·추론 서비스의 Beam 지원 여부
참고 출처
- [Reflection AI] Introducing Beam (2026-10-05, 사양·벤치마크·라이선스, 본문 이미지 2점 출처)
- [Fortune] The U.S. has a new horse in the race to build the best open-source AI model (2026-10-06, 경쟁 구도·기업가치·CEO 인용)
- [MarkTechPost] Reflection AI Introduces Beam (2026-10-05, 구조 정리)
- [Wikipedia] Reflection AI (설립·투자 연혁)
- [Apache Software Foundation] Apache License 2.0 (상업 이용·특허 조항)
- 환율: 1달러 ≈ 1,400원 기준 환산