AWS의 Strands Labs 팀이 2026년 10월 1일 결정 모델 Strands Decider 2B를 Apache 2.0 라이선스로 공개했습니다. 문장을 생성하지 않고 정해진 선택지 가운데 하나를 선택하면서 그 답이 맞을 확률을 함께 출력하는 모델인데, 크기가 2B라 노트북에서도 실행돼요.
TypeSafe의 Jev, Convai Innovations의 Laya에 이어 이번에는 Amazon이 같은 종류의 모델을 공개했고, 같은 날 Cloudflare도 Clef를 공개했어요.
 Strands Decider 2B 공식 발표 — 출처: Strands Agents
Strands Decider 2B 개요
Amazon의 Marc Brooker 등 세 명이 공식 블로그에 발표했고, 가중치는 Hugging Face에, 코드·학습 데이터·학습 스크립트는 GitHub에 함께 공개됐습니다. Brooker는 9월에 공개된 Jev를 보고 직접 개발한 사내 시제품이 JevBench에서 같은 크기 모델 중 1위를 기록해 공개까지 이어졌다고 설명했어요.
| 항목 | 내용 |
|---|---|
| 공개일 | 2026년 10월 1일 |
| 기반 모델 | Qwen3.5-2B-Base |
| 학습한 부분 | LoRA r16 + 포인터 헤드 |
| 라이선스 | Apache 2.0 |
| 설치 | pip install strands-decider |
질문 형식은 예·아니요를 묻는 noul, 여러 선택지 중 하나를 고르는 choice, 순서가 있는 등급을 부여하는 score 세 가지입니다. 공식 블로그가 꼽은 쓰임새는 모델 라우팅, 도구 선택, 결과 평가, 가드레일, 정책 분류처럼 에이전트 작업 흐름 안에서 다음 단계를 정하는 용도예요.
구조
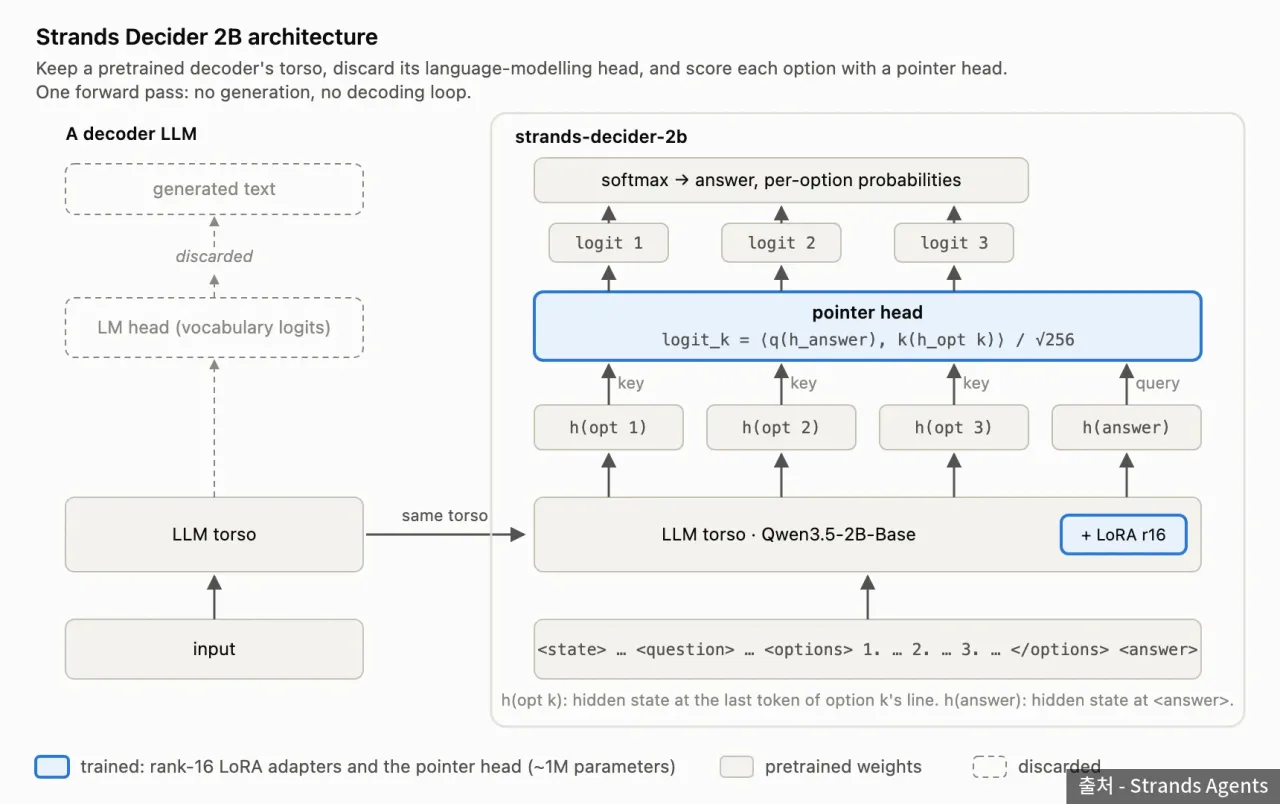 Strands Decider 2B 구조도, LLM 본체와 포인터 헤드 — 출처: Strands Agents
사전 학습된 Qwen3.5-2B에서 다음 단어를 고르는 출력층(LM head)을 떼어 내고, 그 자리에 선택지 점수를 산출하는 포인터 헤드를 결합했습니다. 입력을 한 번 처리한 뒤 각 선택지 줄의 마지막 토큰 상태와 답변 위치의 상태를 비교해 점수를 산출하기 때문에, 토큰을 하나씩 생성하는 반복 과정이 없어요.
새로 학습한 것은 본체에 결합한 rank 16 LoRA 어댑터와 약 100만 파라미터의 포인터 헤드뿐입니다. 학습은 H100 GPU 한 장에서 4,204초(약 70분) 걸렸다고 모델 카드에 적혀 있어요.
정확도와 보정
모델 카드 기준 JevBench 공개 세트 231문항 중 167문항을 맞혀 정확도 72.3%입니다. 공식 블로그는 2B급 모델 33개 중 3위, 2B를 살짝 넘는 모델을 빼면 30개 중 1위라고 밝혔어요.
| 평가 | 정확도 (%) | 문항 수 |
|---|---|---|
| JevBench 공개 세트 | 72.3 | 231 |
| 학습에 안 쓴 짧은 과제 | 64.1 | 6,000 |
| BoardGame | 82.2 | 900 |
| ContractNLI | 87.2 | 1,026 |
| HotpotQA | 71.7 | 959 |
| MuSiQue | 88.4 | 1,199 |
함께 출력하는 확률이 실제 정답률과 얼마나 일치하는지(보정)는 ECE 0.050, Brier 점수 0.348입니다. ECE는 모델이 출력한 확신도와 실제 정답률의 평균 차이라 0에 가까울수록 좋아요. 다만 모델 카드는 이 보정이 짧은 분류 과제에서만 확인됐다고 적었습니다.
속도
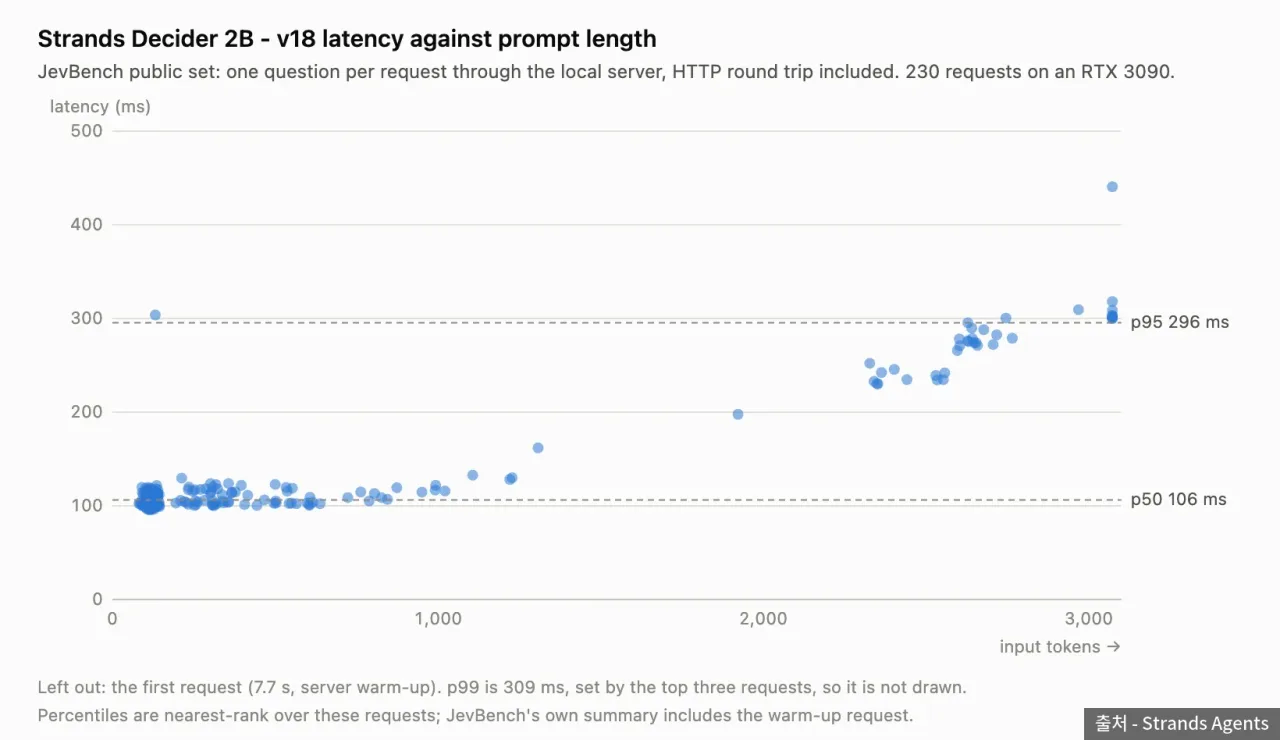 v18 프롬프트 길이별 지연 시간, RTX 3090 — 출처: Strands Agents
공식 블로그 기준 v19의 지연 시간 중앙값은 RTX 3090에서 약 115밀리초, M3 MacBook에서 짧은 과제 약 153밀리초입니다. 직전 버전 v18을 HTTP 왕복 포함으로 230번 잰 결과는 중앙값 106밀리초·상위 5% 296밀리초였어요.
입력 길이가 늘면 지연도 증가합니다. 1,000토큰 아래에서는 대부분 100~130밀리초에 분포했고, 2,500토큰을 넘는 요청은 230~300밀리초대로 올라갔어요.
한국어 실측
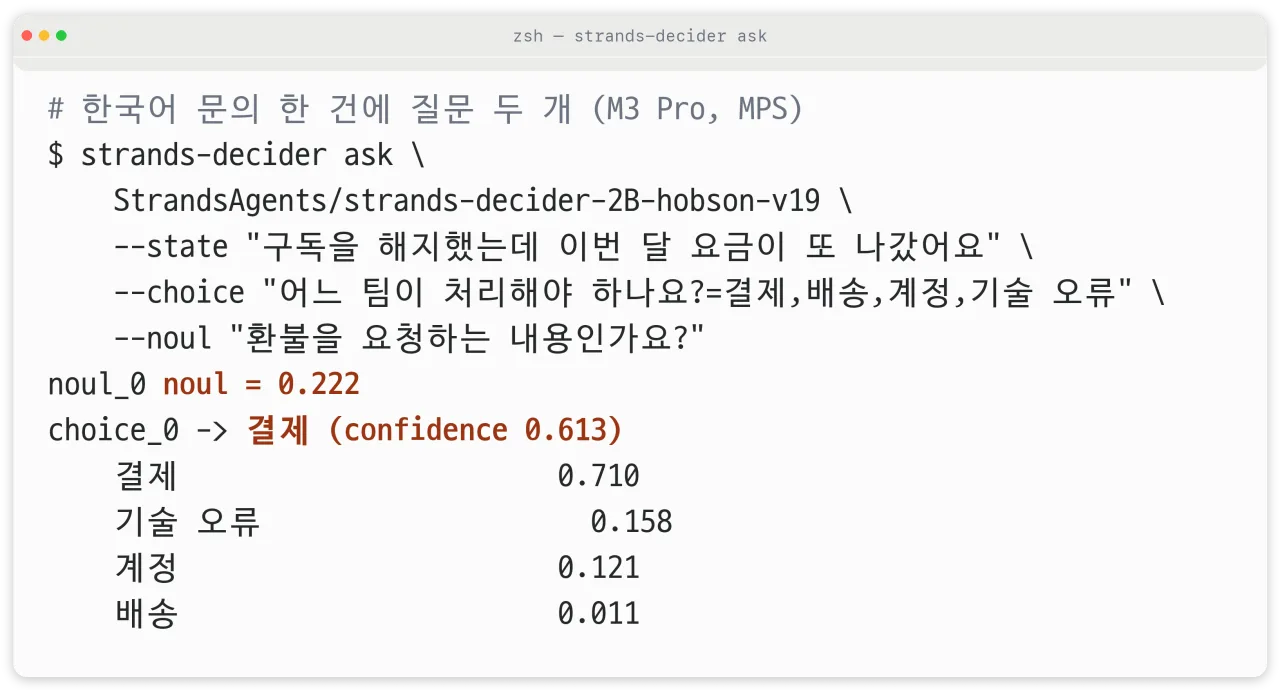 한국어 문의로 strands-decider ask 명령을 실행한 화면 — 출처: 직접 실행 화면 기반 자가 렌더
모델 카드는 영어 공개 데이터셋으로 학습했다고만 밝히고 지원 언어를 따로 적지 않았어요. 그래서 M3 Pro MacBook에서 고객 문의 12건을 결제·배송·계정·기술 오류 네 팀 중 하나로 분류하는 질문을 영어와 한국어로 동일하게 입력해 봤습니다.
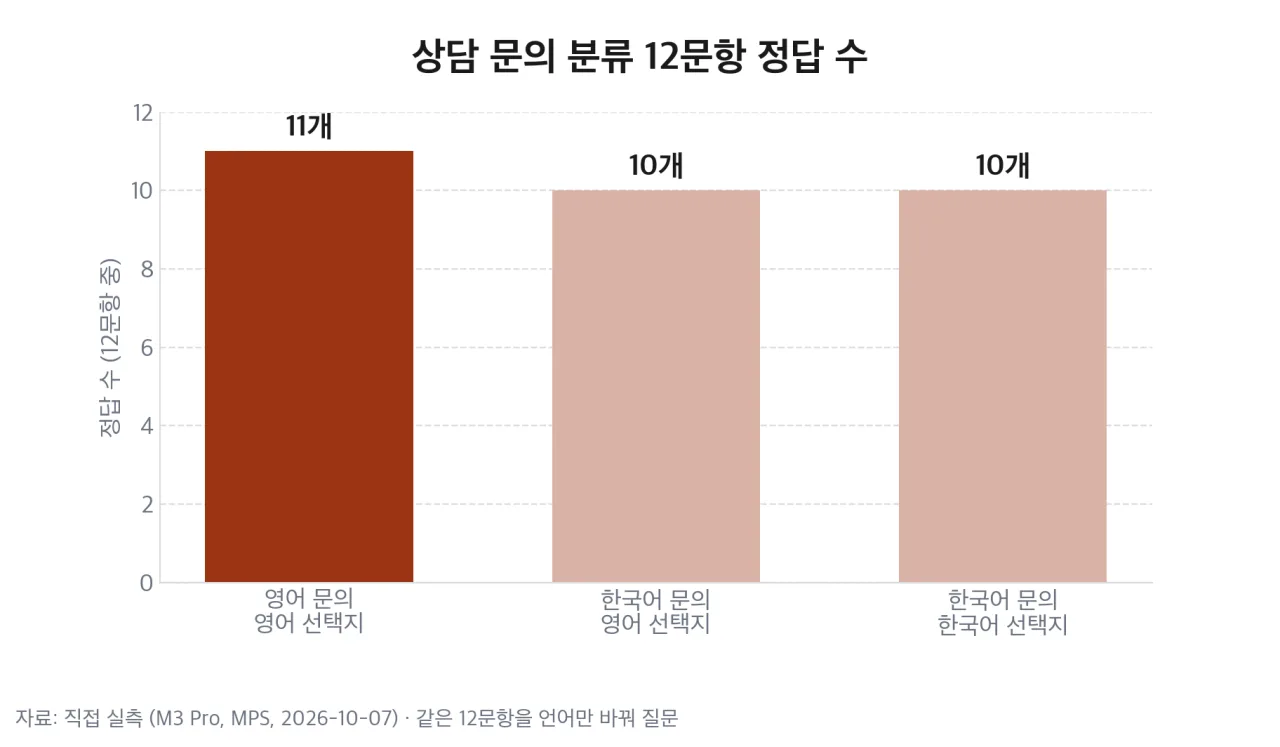 상담 문의 분류 12문항 정답 수, 언어 조건별 — 출처: 직접 실측 기반 자가 렌더
영어는 12문항 중 11개, 한국어는 선택지를 영어로 주든 한국어로 주든 10개를 맞혔습니다. 같은 기기에서 지연 시간 중앙값은 한국어 문의 154~168밀리초, 영어 문의 227밀리초였어요.
| 틀린 문의 | 모델의 답 | 확신도 |
|---|---|---|
| 번호 변경, 인증 문자 못 받음 | 기술 오류 | 0.64~0.77 |
| 비밀번호 변경 후 로그인 불가 | 기술 오류 | 0.47~0.60 |
틀린 두 문항 모두 계정 문제를 기술 오류로 분류했고, 확신도가 0.6~0.77로 맞힌 문항과 비슷하게 나온 경우가 있었어요. 확신도만 보고 사람 검토로 전환할지를 정하면 이런 오답이 걸러지지 않습니다. 12문항은 경향을 보는 크기이지 정확도를 단정할 크기는 아니에요.
noul 질문으로 요금이 또 나갔다는 문의가 환불 요청인지 묻자 확률이 0.222로 출력됐고, 문장에는 환불이라는 말이 없었어요. 암시된 의도를 묻는 질문은 영어로도 따로 검증이 필요합니다.
Jev·Laya·Clef와 비교
 Cloudflare 로고 — 출처: Cloudflare
Cloudflare는 같은 10월 1일 Clef(27B)와 Clef-flash(9B)를 Apache 2.0으로 공개하고, 자사 Workers AI에서 호스팅 서비스로도 유료 제공하기 시작했습니다. 64k 토큰 문맥과 이미지 입력을 지원해 노트북용인 Strands Decider와는 용도가 달라요.
| 모델 | 크기 | 공개 방식 |
|---|---|---|
| Jev (TypeSafe) | 비공개 | 유료 API |
| Laya (Convai) | 421M | Apache 2.0 |
| Strands Decider | 2B | Apache 2.0 |
| Clef-flash (Cloudflare) | 9B | Apache 2.0 + API |
| Clef (Cloudflare) | 27B | Apache 2.0 + API |
| 모델 | 지연 중앙값 | 100만 토큰당 요금 |
|---|---|---|
| Jev | 70~500ms | 59원 |
| Laya | 39.5ms (T4) | 로컬 무료 |
| Strands Decider | 115ms (3090) | 로컬 무료 |
| Clef-flash | 38.8ms | 126원(0.09달러) |
| Clef | 209.3ms | 336원(0.24달러) |
지연 시간은 측정 장비가 제각각이라 순위로 읽으면 안 됩니다. Strands Decider와 Laya는 내 컴퓨터에서 측정한 값이고, Jev와 Clef는 호스팅 서비스 기준이에요.
한계
공식 블로그는 추론 모델보다 복잡한 문제 풀이가 크게 떨어지고, 코딩·챗봇·문서 요약처럼 글을 써야 하는 일에는 맞지 않는다고 직접 밝혔어요. 모델 카드가 적은 한계는 넷입니다.
- 질문보다 문서 내용에 주의가 집중됨
- 길고 단계가 많은 문서에 약함
- 학습 데이터와 다른 새 채점 기준에 잘 일반화되지 못함
- 공개 데이터셋의 편향을 물려받음
국내에서 쓴다면 Apache 2.0이라 사내 서버에 배포해 상업적으로 쓸 수 있고 문의 내용이 외부 API로 전송되지 않는다는 점이 장점입니다. 한국어 공식 평가는 없어서, 도입 전에 실제 문의로 정확도와 확신도 분포부터 다시 측정해야 해요.
참고 출처
- [Strands Agents] Introducing Strands Decider 2B (2026-10-01, 구조·JevBench 순위·지연 시간·한계)
- [Hugging Face] StrandsAgents/strands-decider-2B-hobson-v19 모델 카드 (정확도·ECE·Brier·학습 시간·한계)
- [GitHub] strands-labs/strands-decider (코드·학습 레시피·데이터)
- [Cloudflare Blog] Clef decision models (2026-10-01, 지연 시간·문맥·라이선스)
- [Cloudflare Docs] Workers AI Clef·Clef-flash 모델 페이지 (요금·파라미터) https://developers.cloudflare.com/workers-ai/models/clef-flash/
- [TypeSafe AI Docs] Models (Jev 요금·지연 시간)
- [Hugging Face] convaiinnovations/laya 모델 카드 (Laya 크기·T4 지연 시간)
- 환율: 1달러 ≈ 1,400원 기준 환산