Instagram·Facebook에 비즈니스 계정을 둔 곳이라면 2026년 10월 30일부터 약관이 바뀌어요
Meta가 커머스 약관에 자동화된 소프트웨어로 연결된 웹사이트를 수집한다는 조항을 넣었어요
수집한 콘텐츠는 Meta 제품의 개발·연구·학습에 쓸 수 있다고 적었습니다
동의하지 않으면 비즈니스 목적 이용을 중단하는 방법밖에 없어요!!
 Meta 워드마크
약관 변경 내용
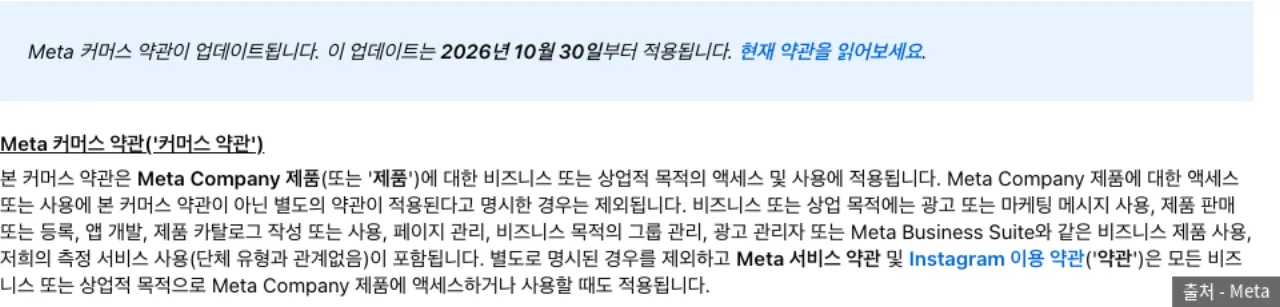 Meta 커머스 약관 한국어판 상단의 2026년 10월 30일 적용 공지 — 출처: Meta
바뀌는 문서는 Meta 커머스 약관이에요
광고 집행·페이지 관리·Meta Business Suite 이용 등 상업 활동에 적용되는 약관입니다
개정판은 2026년 10월 30일부터 적용돼요
Meta는 10월 초 블로그와 Business Suite 알림으로 개정을 공지했어요
한국어판 약관에도 같은 날짜, 같은 조항이 올라와 있어요
개정 약관에는 동의하지 않으면 상업 목적 이용을 중단하는 방법만 적혀 있어요
따로 거부할 수 있는 설정은 없습니다
새 조항 풀이
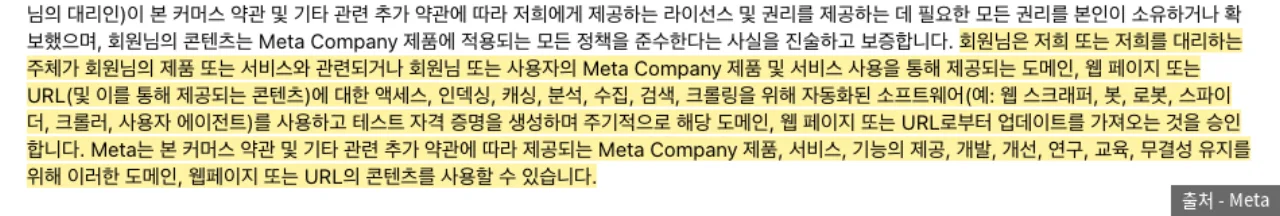 커머스 약관의 자동화된 소프트웨어·테스트 자격 증명 조항 (하이라이트 표시) — 출처: Meta
새 문단은 「회원님이 Meta에 제공하는 라이선스 및 권리」 항목 둘째 문단에 들어갔어요
| 조항 요소 | 약관 문구 |
|---|---|
| 수집 도구 | 웹 스크래퍼·봇·스파이더·크롤러 |
| 수집 대상 | 제품·서비스와 관련된 도메인·URL |
| 수집 행위 | 인덱싱·캐싱·분석·수집·크롤링 |
| 추가 권한 | 테스트 자격 증명 생성 |
| 사용 목적 | 제공·개발·개선·연구·교육 |
광고에 건 랜딩 페이지만이 아니라 계정과 연결된 도메인 전체에 적용된다고 해석될 여지가 있어요
영문판의 train은 한국어판에서 교육으로 옮겨졌어요
영문을 보면 AI 모델 학습을 가리키는 단어입니다
테스트 자격 증명은 사이트에 시험용 계정을 생성해 접근할 수 있다는 뜻으로 해석돼요
법률가 해석과 Meta 반박
 비즈니스 계정에서 연결된 웹사이트로 크롤러가 뻗어 가는 개념 컷 — 출처: 개념 컷 · agy 자가 생성
미국 언론 연구 매체 Nieman Lab이 10월 15일 법률가 세 명에게 조항을 검토받았어요
[James Grimmelmann] Cornell 로스쿨 교수, 테스트 자격 증명으로 회원 가입을 거쳐야 열리는 콘텐츠까지 접근할 수 있다고 봄
[Matt Topic] Loevy & Loevy 변호사, 수십억 원(수백만 달러)어치 콘텐츠가 걸린다고 봄
[Benjamin Sobel] 위스콘신대 로스쿨 교수, 제품 이용에 다른 조건을 묶는 반독점법의 끼워팔기에 견줌
세 사람 모두 법원이 이 조항을 인정할지는 불확실하다고 했어요
다만 Topic 변호사는 언론사는 집행될 것으로 가정하고 대비하라고 조언했습니다
거의 모든 언론사가 Meta 비즈니스 계정을 하나 이상 갖고 있어 적용 대상에서 제외되기 어려워요!
Meta 대변인은 여러 약관에 있던 크롤링 문구를 통합했을 뿐이라고 설명했어요
퍼블리셔를 크롤링하는 방식은 바뀌지 않는다고 밝혔습니다
Meta 홍보 담당 Andy Stone도 10월 16일 X에 사실이 아니다라고 올렸습니다
외부 사이트에서 상품 정보를 정확히 수집하기 위한 개정이라는 설명이에요
Meta는 테스트 자격 증명으로 유료 구독자만 볼 수 있는 콘텐츠에 접근할 수 있는지는 답하지 않았어요
robots.txt로 막는 범위
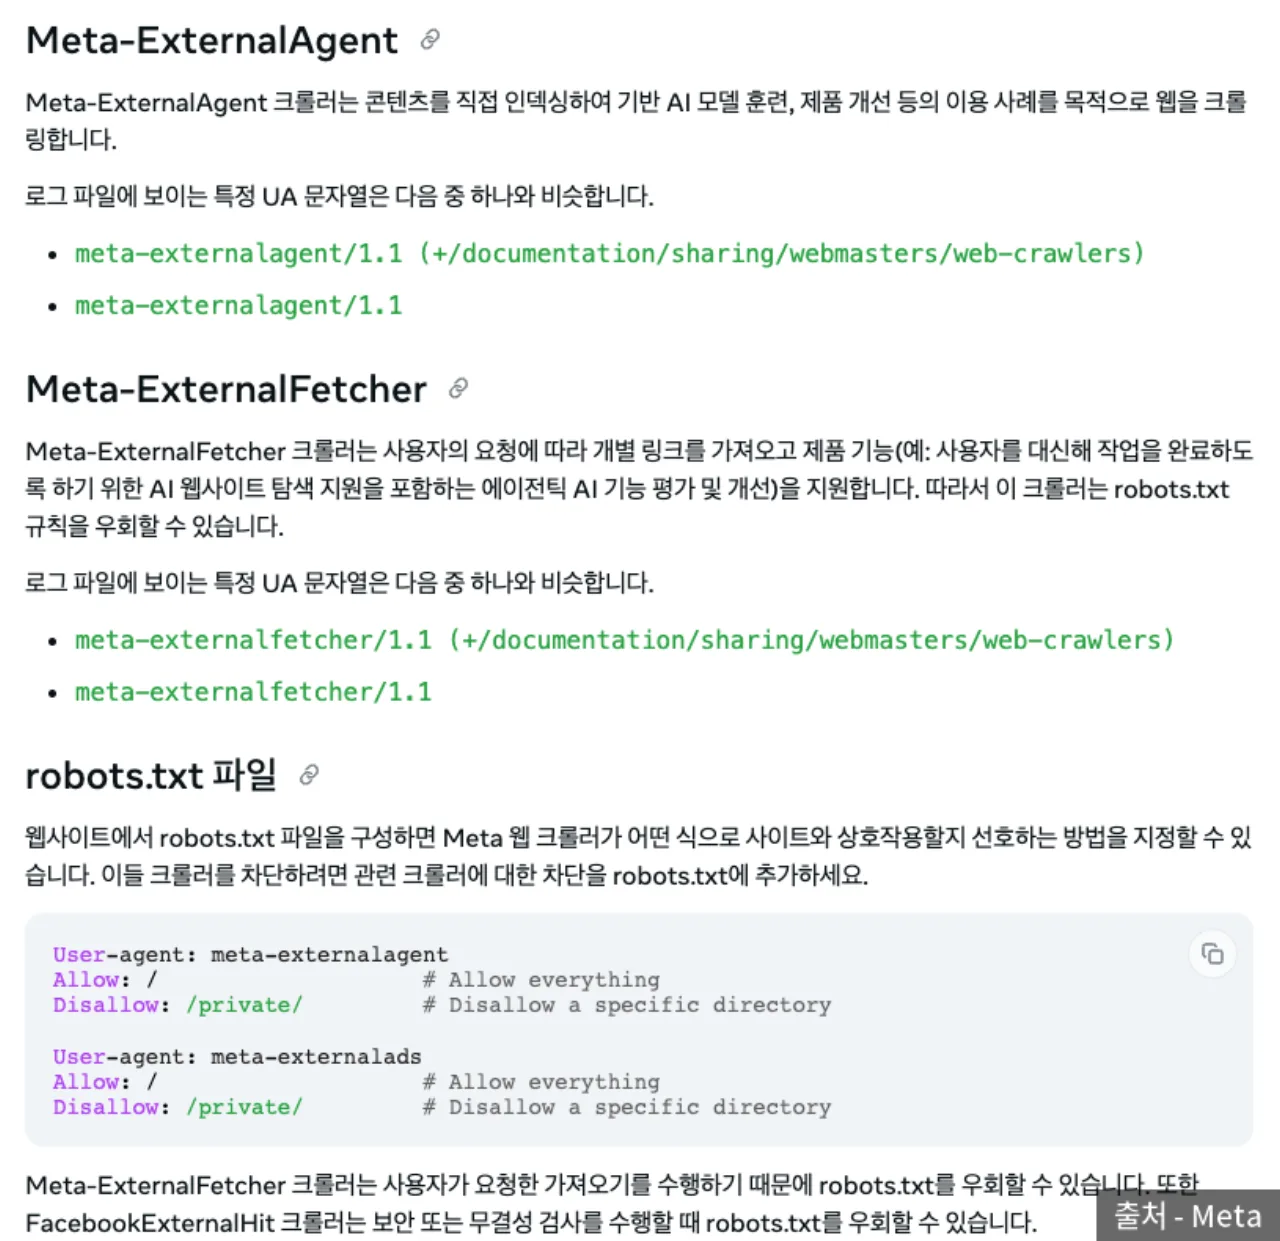 Meta 개발자 문서의 Meta-ExternalAgent·Meta-ExternalFetcher 설명과 robots.txt 예시 — 출처: Meta
Meta가 내세우는 대안은 robots.txt예요
사이트의 최상위 경로에 두는 파일로, 크롤러마다 접근을 허용하거나 막을 수 있어요
Meta 개발자 문서에 공개된 크롤러는 다섯 개입니다
| 크롤러 | 용도 |
|---|---|
| Meta-ExternalAgent | 기반 AI 모델 훈련·인덱싱 |
| Meta-WebIndexer | Meta AI 검색 인용 |
| Meta-ExternalAds | 광고·비즈니스 제품 |
| Meta-ExternalFetcher | 사용자 요청 링크 가져오기 |
| FacebookExternalHit | 링크 미리보기 |
AI 학습을 막으려면 Meta-ExternalAgent를 지정해 막아요
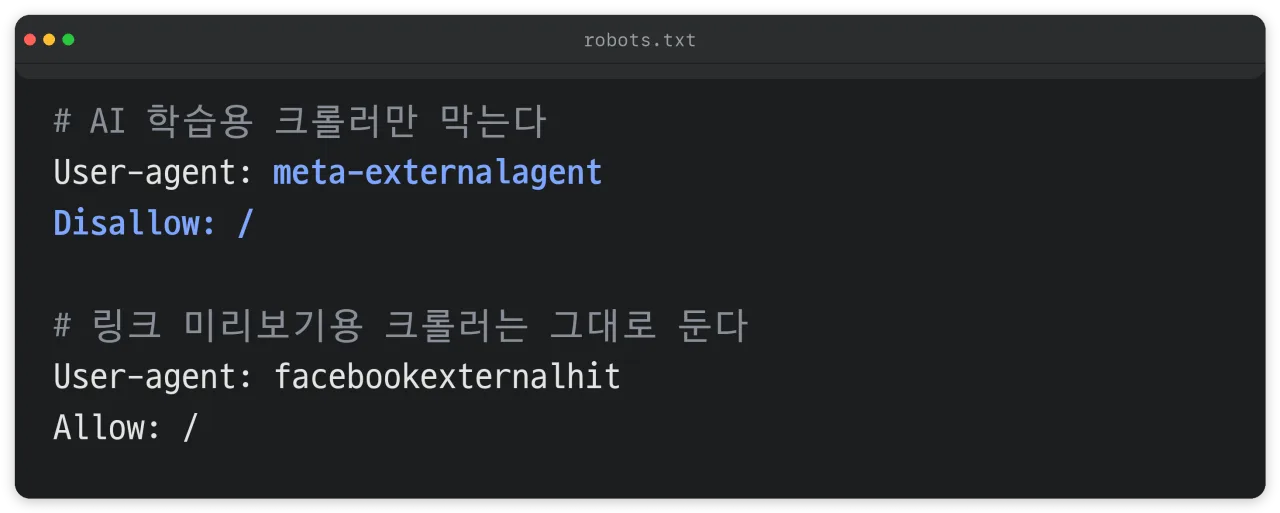 meta-externalagent만 막고 링크 미리보기 크롤러는 허용하는 robots.txt 예시 — 출처: Meta 개발자 문서 기반 자가 렌더
FacebookExternalHit까지 막으면 공유한 링크의 미리보기가 사라질 수 있어요
Meta는 robots.txt 변경이 최대 24시간 뒤에 반영된다고 적었어요
Meta-ExternalFetcher는 robots.txt를 우회할 수 있다고 문서가 직접 밝혀요!
사용자가 요청한 링크를 가져오는 크롤러라서예요
법률가들은 Meta가 약관 동의를 근거로 robots.txt보다 계약이 우선한다고 주장할 수 있다고 봤어요
robots.txt는 기술적 차단이고, 약관이 그보다 우선할지는 아직 판단되지 않았습니다
국내 사업자가 확인할 것
Meta는 2025년 12월 CNN·Fox News·Le Monde 등과 AI 콘텐츠 계약을 맺었어요
Meta AI가 뉴스 질문에 답할 때 그 기사로 연결하는 계약이에요
Meta는 커머스 약관으로 연결된 사이트의 콘텐츠 이용 권한도 받는 구조예요
2026년 10월 18일 기준 국내 언론 단체·정부 기관의 공식 입장은 찾지 못했어요
쇼핑몰·병원·학원처럼 Instagram 광고를 돌리는 사업자도 같은 약관을 받아요
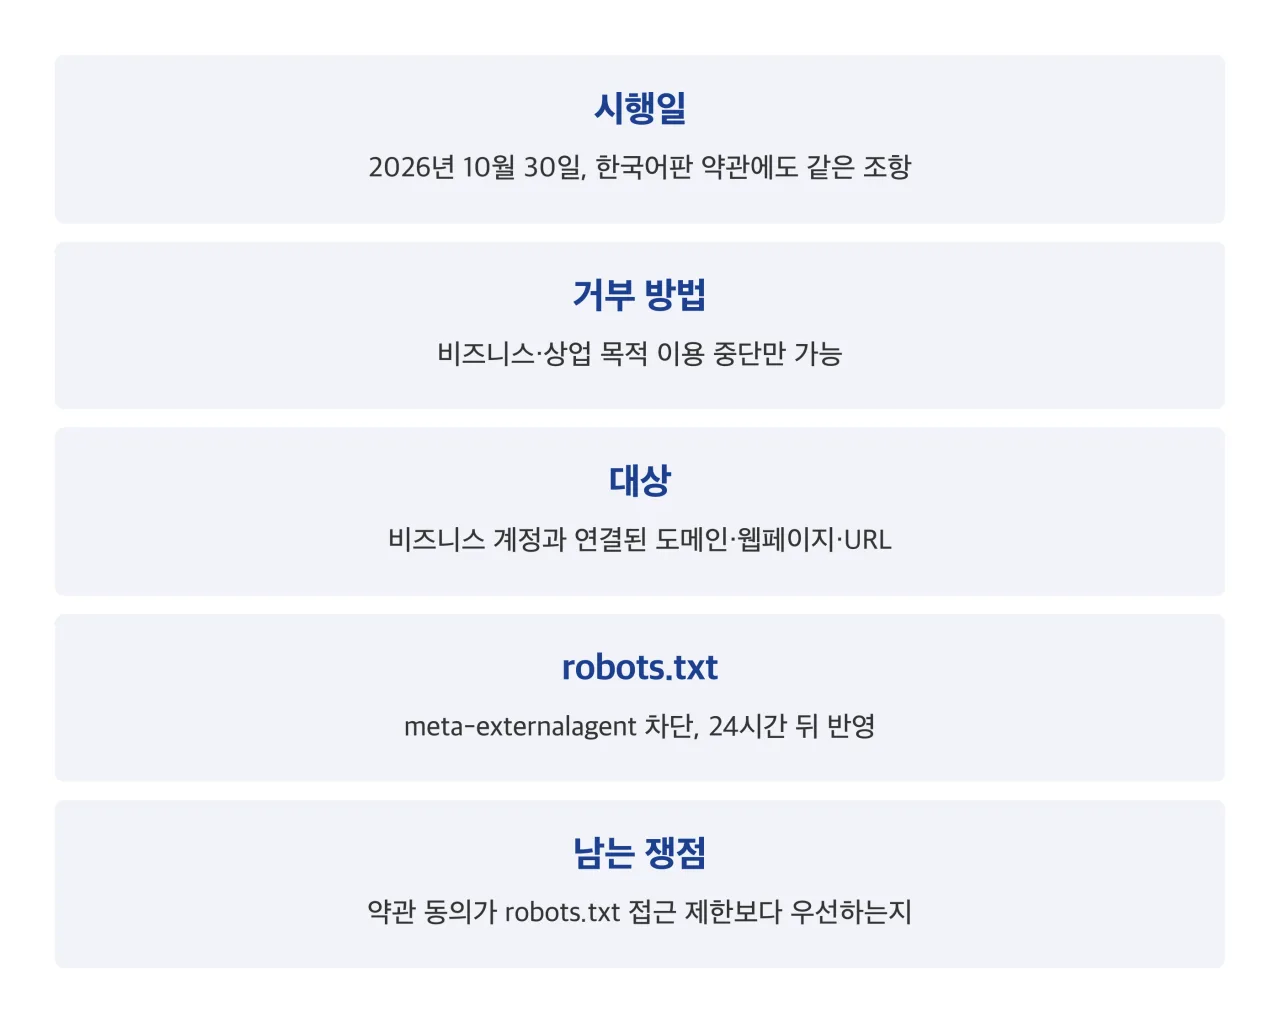 메타 커머스 약관 개정 정리 카드 — 출처: Meta 커머스 약관·개발자 문서 기반 자가 렌더
참고 출처
- [Meta] 커머스 약관 개정 미리보기 (2026년 10월 30일 적용, 한국어판)
- [Meta for Developers] Meta 웹 크롤러 (크롤러 다섯 종·robots.txt 예시)
- [Nieman Lab] 법률가 세 명의 조항 해석과 Meta 대변인 답변 (2026-10-15)
- [Relevant Audience] 영문 조항 문구와 Andy Stone 게시 정리 (2026-10-17)
- [지디넷코리아] 국내 언론사 우려 보도 (2026-10-17)
- [Reuters via MarketScreener] Meta의 언론사 AI 콘텐츠 계약 (2025-12-05)
- 환율: 1달러 ≈ 1,400원 기준 환산